RelateAnything 논문 소개
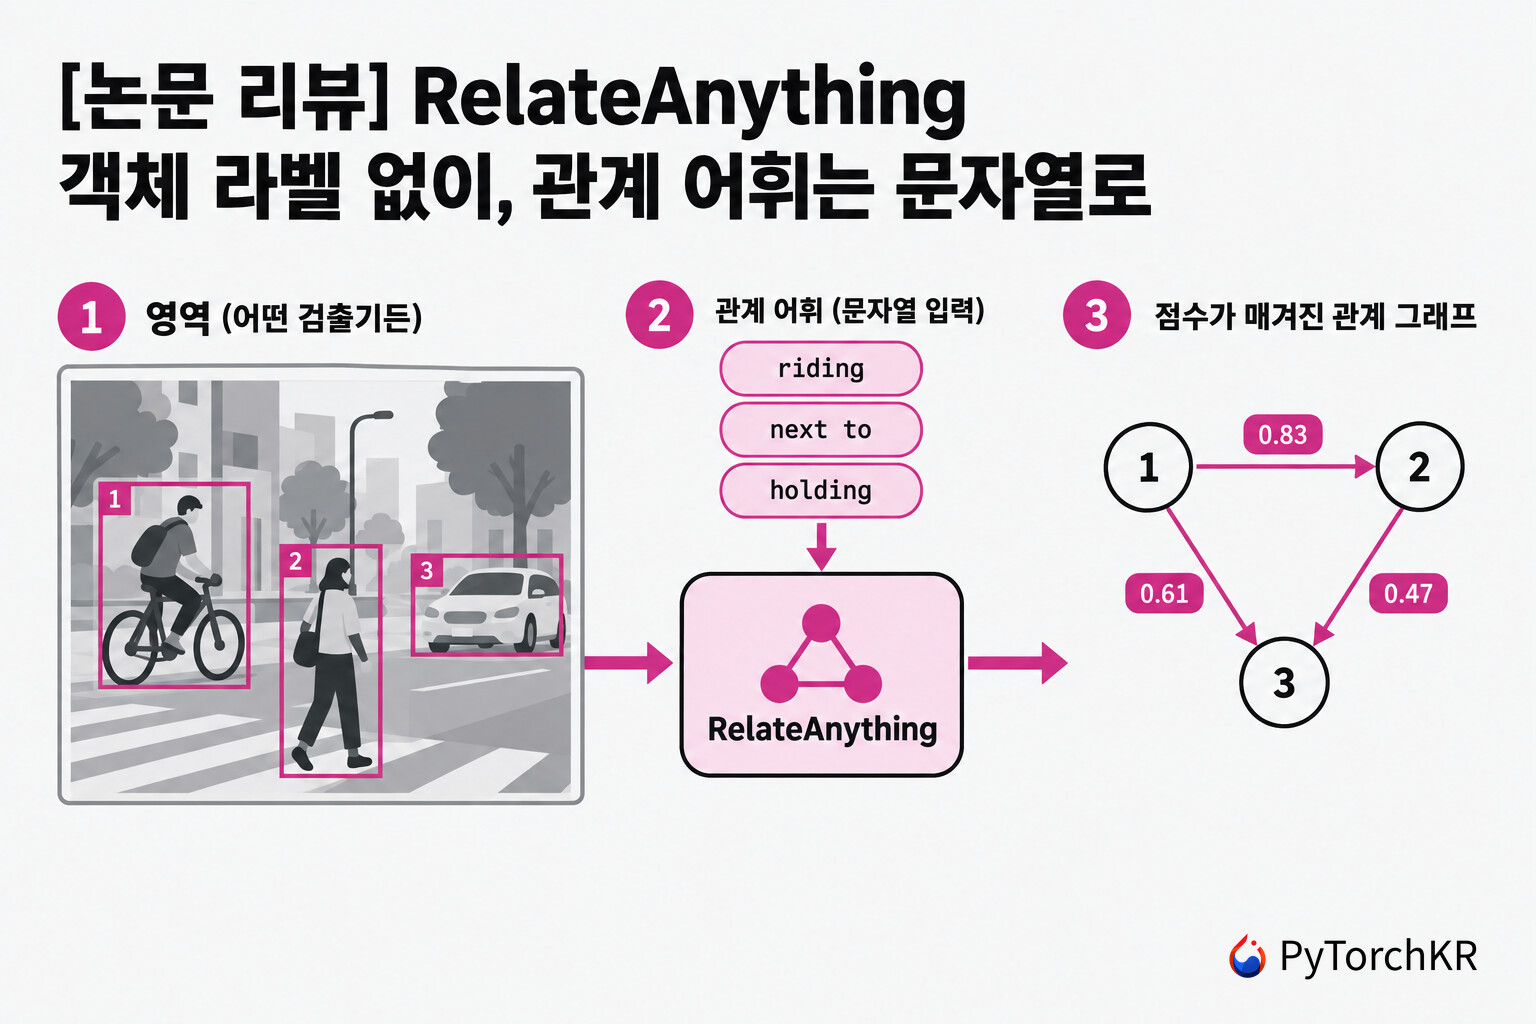
RelateAnything은 이미지와 임의의 출처에서 온 영역(region), 그리고 추론(Inference) 시점에 문자열 목록으로 넘겨주는 관계 어휘를 입력받아, 영역 쌍마다 점수가 매겨진 관계를 돌려주는 5,300만(53M) 파라미터 규모의 관계 예측 모델입니다. 사진 한 장을 보고 "사람이 말을 타고 있다", "버스가 가로등 옆에 서 있다"처럼 물체 사이의 관계를 말하는 일은 사람에게는 쉽지만, 지금까지의 장면 그래프 모델은 학습 때 정해 둔 50여 개의 관계 이름 밖으로는 답하지 못했습니다. 이 논문은 이 제약을 모델, 학습 데이터, 평가 방식의 세 방향에서 함께 풀려고 합니다.
장면 그래프 생성이 여전히 50개 술어에 묶여 있는 이유
최근 몇 년 사이 컴퓨터 비전에서는 "무엇을 찾을지"를 모델 밖으로 꺼내는 흐름이 뚜렷했습니다. 개방형 어휘(Open-Vocabulary) 객체 검출(Object Detection) 모델은 추론 시점에 임의의 클래스 목록을 받아들이고, YOLO-World나 YOLOE처럼 실시간으로 동작하는 모델도 나왔습니다. Segment Anything 계열처럼 프롬프트로 동작하는 분할 모델은 아예 클래스 이름이 없는 영역을 돌려줍니다. 두 경우 모두 분류체계(Taxonomy)가 모델 내부를 떠나 입력이 되었고, 덕분에 처음 만들어질 때 염두에 두지 않았던 도메인에도 바로 적용할 수 있게 되었습니다.
관계 예측은 아직 이 전환을 하지 못했습니다. 관계 예측을 담당하는 장면 그래프 생성(SGG, Scene Graph Generation) 연구는 여전히 VG150의 50개 술어(Predicate) 나 PSG의 56개 술어로 학습하고 평가합니다. 주류 구조는 하나의 백본(Backbone)에서 객체와 관계를 함께 예측하고, 관계 헤드를 예측된 객체 클래스에 조건화합니다. 이렇게 하면 레이블 공간이 고정되고, 실제 배포 환경에서 쓸 수 있는 다른 검출기, 클래스 없는 분할기, 사람이 직접 그린 박스 같은 영역 소스를 사용할 수 없게 됩니다.
개방형 어휘를 표방하는 방법도 한계가 있습니다. 대표적인 OvSGTR은 관계를 텍스트와 대조해 점수를 매기지만, 술어 이름을 하나의 캡션(caption)으로 묶어 함께 인코딩합니다. 텍스트 인코더의 512개 워드피스(word piece) 한도 때문에 어휘가 약 150개 문자열로 제한되고, 추론 경로에 언어 모델이 계속 남습니다. 그 반대편에는 ROBIN-3B처럼 30억(3B) 파라미터 비전-언어 모델(VLM) 위에 만든 장면 그래프 모델이나, Qwen3-VL과 같은 범용 멀티모달 모델에 프롬프트로 관계를 물어보는 방식이 있습니다. 이쪽은 자유 텍스트로 답할 수 있지만 무겁고, 뒤에서 살펴보듯 주석(Annotation)이 달린 영역 쌍 중 상당수를 아예 언급하지 않습니다.
저자는 관계 예측이 벤치마크 어휘 규모에 머문 이유가 주로 모델링 문제가 아니라고 주장합니다. 원인은 크게 세 가지로 정리됩니다:
-
지도 신호가 없습니다. 관계 주석은 비전 분야에서 가장 비싸고 신뢰도가 낮은 주석이며, 기존의 기계 생성 코퍼스는 고정된 클래스 목록에 투영하거나 주석을 만든 모델의 출력을 검증하지 않습니다.
-
구조가 그 지도 신호를 쓸 수 없습니다. 객체 레이블에 조건화된 관계 헤드는 레이블 공간을 물려받고, 캡션 하나로 인코딩한 어휘는 늘릴 수 없습니다.
-
측정 방식이 그 변화를 보지 못합니다. 장면 그래프 재현율(Recall)은 학습 어휘와 같은 어휘로 만든 벤치마크에서 계산되므로, 이미지 속 관계가 아니라 학습 코퍼스와의 일치를 보상합니다. 어휘를 넓힌 모델이 주석에 없는 문자열로 답하면 오히려 점수가 깎입니다.
RelateAnything의 접근: 모델, 코퍼스, 벤치마크를 함께 설계
이번에 소개할 RelateAnything 연구는 독립 연구자 Maëlic Neau가 단독 저자로 발표한 논문으로, 위 세 장애물 각각에 하나씩 대응하는 결과물을 내놓았습니다. 저자는 이 셋이 서로에게 미치는 영향까지 함께 측정했습니다.
-
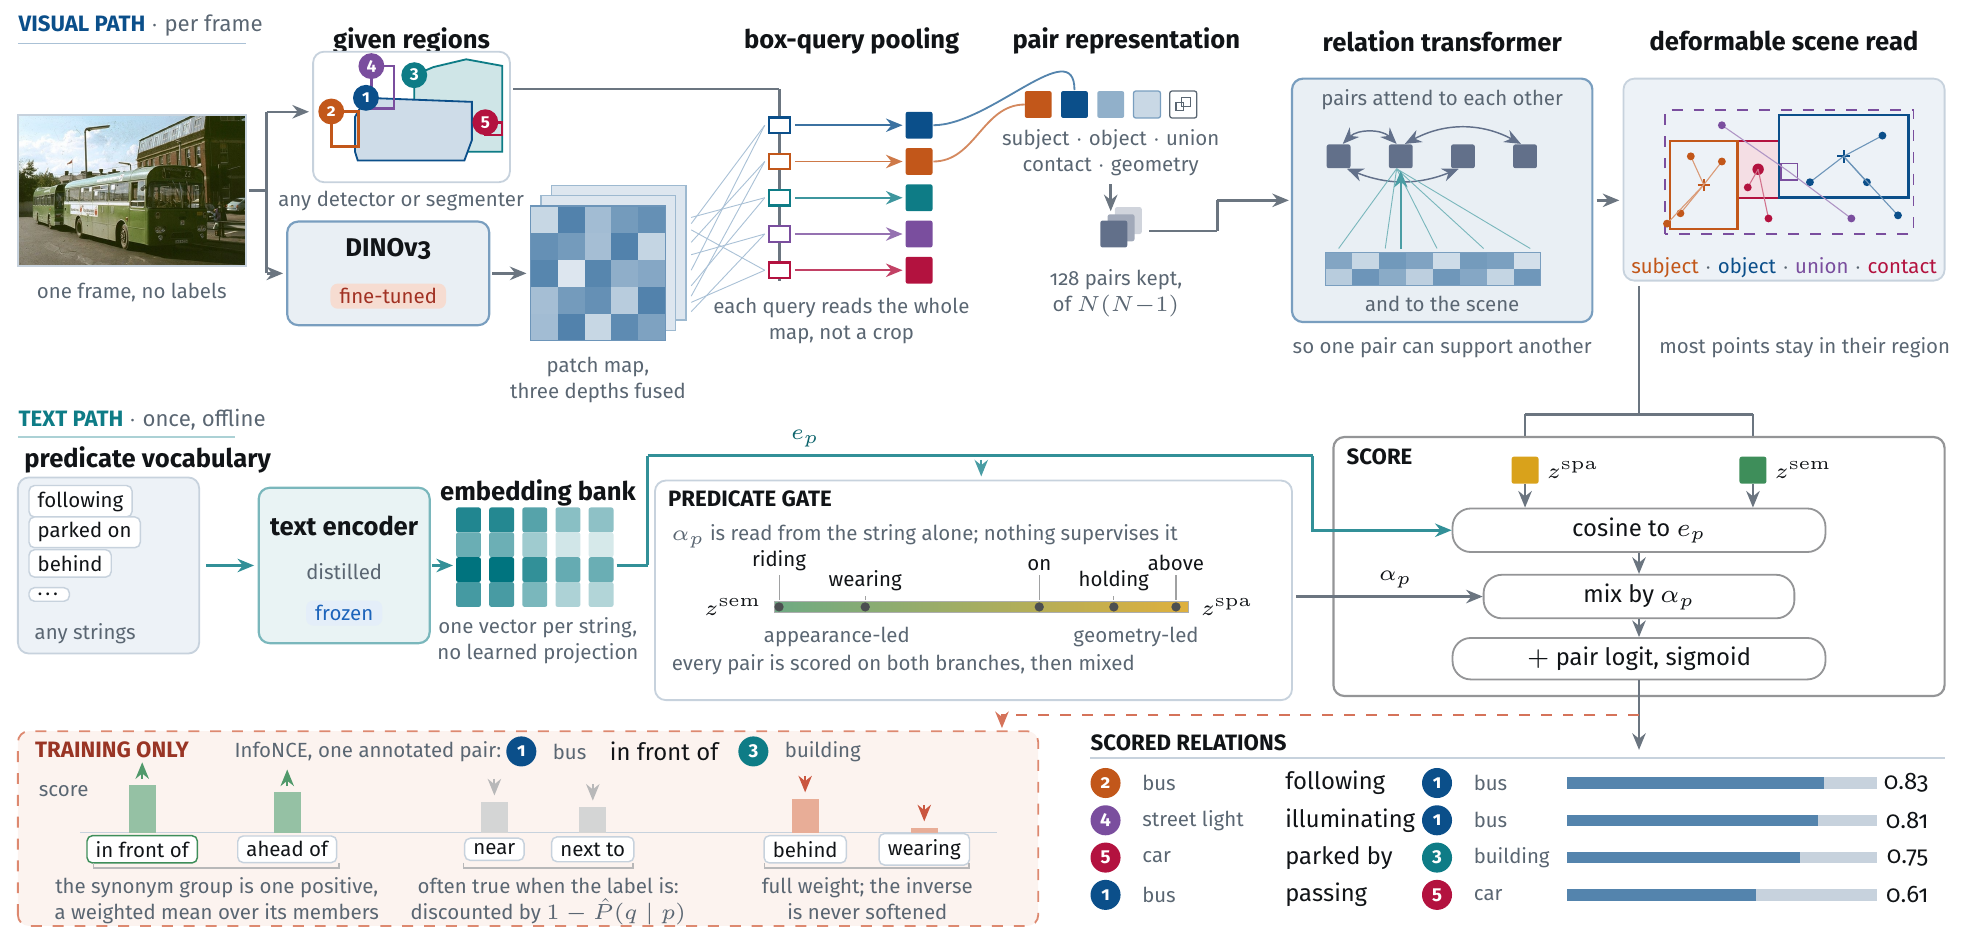
RelateAnything (모델): 픽셀과 박스 좌표만 보고, 추론 시점에 받은 술어 문자열마다 점수를 매깁니다. 객체 클래스 레이블은 학습과 추론 어느 단계에서도 네트워크 입력으로 쓰이지 않으며, 어휘는 학습된 분류기가 아니라 텍스트 임베딩을 쌓은 행렬이라 행렬 하나만 바꾸면 어휘가 바뀝니다.
-
RA-4M (코퍼스): 47만 4천여 장의 이미지와 430만 개의 관계, 10,102개의 자유 텍스트 술어로 이루어진 학습 코퍼스입니다. 비전-언어 모델이 번호를 붙인 박스 마커를 보고 관계를 쓰고, 결정적인 기하 검사(geometric check)가 이를 걸러냅니다.
-
OV-SGG-Bench (벤치마크): 6개 축을 모두 교차 데이터셋(cross-dataset)으로 측정하는 평가 프로토콜입니다. 표준 재현율이 보상하는 사전 지식(prior)만으로는 어느 축도 높은 점수를 얻을 수 없도록 설계했습니다.
미리 결과를 짚어 보면, 학습 이미지를 하나도 제공하지 않은 벤치마크 3개와 제로샷(Zero-shot)으로 평가한 벤치마크 1개에서 RelateAnything은 비슷한 규모의 가장 강한 개방형 어휘 방법(OvSGTR)보다 평균 재현율이 2.3 ~ 3.5\times 높았고, 실제 검출기가 영역을 공급해도 이 격차가 유지되었습니다. 30억 파라미터 VLM 기반 장면 그래프 모델과 비교해도 함께 평가한 세 벤치마크 모두에서 두 지표가 앞섰는데(둘 다 자유 텍스트 매처로 채점할 때의 micro 재현율만 예외), 파라미터는 그 모델의 2\% 미만입니다. 한편 저자는 도메인 내(in-domain) 측정이 교차 데이터셋 성능 향상을 약 5\times 과대평가한다는 사실도 함께 보고했습니다.
논문의 모든 결과는 모델이 학습하지 않은 벤치마크에서 얻은 교차 데이터셋 전이 결과이며, 예외는 HICO-DET 학습 분할의 5\% 관계 비중을 포함한 한 행과 미세조정(Fine-tuning)한 세 행뿐입니다.
RelateAnything 모델 구조
그렇다면 어떤 구조여야 영역 소스와 어휘를 모두 바꿀 수 있을까요? 논문은 문제 정의에서부터 두 가지 제약을 명시합니다.
문제 정의: 객체 레이블 없이, 어휘는 입력으로
이미지 I 와 박스 집합 B = \{b_i\}_{i=1}^{N} 이 주어지면, 모델은 점수가 매겨진 삼중항 (i, j, p) 를 출력합니다. 여기서 술어 p 는 추론 시점에 문자열로 주어지는 어휘 \mathcal{V} 에 속합니다.
첫 번째 제약은 객체 레이블을 쓰지 않는다는 것입니다. 모델은 픽셀과 박스 좌표만 받습니다. 대부분의 기존 수치가 얻어진 술어 분류(PredCls, Predicate Classification) 프로토콜에서는 정답 객체 클래스가 함께 주어지는데, 그 클래스에는 뒤에서 분석할 강력한 사전 지식이 실려 있습니다. RelateAnything의 설정은 그보다 어렵지만, 레이블이 검출기에서 오고 노이즈가 섞이거나 어휘 밖이거나 아예 없는 실제 배포 상황에 해당합니다. 객체 범주는 학습 중 두 개의 손실 항(쌍 샘플러의 연관성 손실, 객체-텍스트 그라운딩 항) 안에서만 쓰이고, 네트워크 입력으로는 한 번도 들어가지 않습니다.
두 번째 제약은 어휘가 입력이라는 것입니다. 술어 분류기가 없고, 점수는 시각적 쌍 임베딩과 텍스트 임베딩 사이의 코사인 유사도입니다. 텍스트 쪽에는 학습된 변환을 전혀 적용하지 않는데, 학습 어휘에 맞춰 학습한 투영(projection)은 나중에 들어오는 문자열에 대해서는 정의되지 않기 때문입니다. 따라서 어휘를 바꾸는 일은 행렬 하나를 갈아 끼우는 것과 같고 재학습이 필요 없습니다.
시각 경로: DINOv3 백본과 박스 쿼리 풀링
위 그림의 첫 번째 줄이 시각 경로입니다. DINOv3 백본이 이미지를 448 \times 448 해상도로 인코딩하고, 뒤에서 6번째, 3번째, 마지막 레이어의 패치 특징을 각각 레이어 정규화한 뒤 학습된 가중치로 융합합니다. 백본은 헤드보다 8\times 낮은 학습률로 전체 미세조정하며, 이 규모에서는 백본을 고정하거나 LoRA 어댑터를 쓰는 것보다 나았다고 합니다.
객체별 특징은 박스 영역을 잘라내는(crop) 방식이 아니라 좌표를 아는 소프트 풀링(soft pooling)으로 얻습니다. 박스 b_i 의 푸리에 위치 인코딩(Fourier position encoding)으로 쿼리를 만들고, 이 쿼리가 전체 패치 토큰에 교차 어텐션을 수행합니다:
이렇게 하면 객체 표현에 그 객체가 상호작용하는 주변 맥락이 함께 담길 수 있습니다. 예를 들어 사람 박스의 쿼리가 사람 영역만이 아니라 그 사람이 들고 있는 물건 쪽 패치도 참고할 수 있습니다.
순서가 있는 쌍 (i, j) 의 표현은 다섯 가지 풀링 특징을 이어 붙여 만듭니다:
v_{\cup} 는 두 박스를 합친 영역을, v_{\cap} 는 접촉(contact) 영역을 풀링합니다. 접촉 영역은 두 박스가 겹치면 교집합, 떨어져 있으면 둘 사이의 틈입니다. g_{ij} \in \mathbb{R}^{19} 는 스케일에 불변인 기하 특징(박스 특징 15개와 마스크 전용 슬롯 4개)입니다.
이후 작은 관계 트랜스포머(Relation Transformer) 가 샘플링된 쌍들을 정제합니다. 쌍끼리 셀프 어텐션을 하고, 장면 토큰과 쌍 자신의 박스 모서리 토큰에 교차 어텐션을 하며, 마지막으로 쌍과 장면 토큰을 함께 놓고 셀프 어텐션을 한 번 더 수행합니다. 덕분에 한 쌍의 관계가 다른 쌍의 관계를 뒷받침할 수 있습니다.
마지막 단계는 변형 가능 장면 읽기(Deformable Scene Read) 입니다. 각 쌍이 네 개의 앵커(주어, 목적어, 합집합, 접촉) 주변의 샘플링 오프셋을 예측하고, 그 위치에서 특징 맵을 읽어 0으로 초기화된 게이트를 거쳐 더합니다. 저자는 이 단계 덕분에 parked on 은 도로 표면을 보고, hanging from 은 주어 위쪽의 매달린 지점을 보고 판단할 수 있다고 설명합니다. 실제로 PSG 검증 이미지의 airplane parked on road(점수 0.99 ) 쌍에서는 주어 앵커가 어텐션 질량의 56\% 를 차지하며 비행기 주변의 활주로를 읽었습니다.
두 갈래 점수와 술어 조건부 게이트
공간 관계와 의미 관계는 서로 다른 근거에 의존합니다. above 는 박스 배치만으로 대부분 판단할 수 있지만 riding 은 외형을 봐야 합니다. 그래서 헤드는 각 쌍을 두 번 점수 매기고, 두 코사인 채널을 술어마다 다른 비율로 섞습니다:
e_p 는 술어 p 의 텍스트 임베딩이고, 혼합 비율 \alpha_p = g(e_p) 는 그 임베딩만으로 계산됩니다. 그래서 모델이 한 번도 본 적 없는 문자열에도 \alpha_p 가 정의됩니다. 게이트에는 별도의 지도 신호가 전혀 없는데도, 학습된 가중치는 뚜렷하게 두 봉우리로 나뉘었습니다. 전체 19,103개 학습 문자열에서 \alpha_p 의 중앙값은 0.002 이고, 0.5 를 넘는 술어는 12\% 입니다. 투영 관계는 기하 쪽 끝(behind 1.000 , below 0.9998 , above 0.970 )에, 행동은 외형 쪽 끝(carrying 0.0004 , parked on 0.0008 , riding 0.012 )에 모였고, 기하와 외형이 모두 필요한 접촉 술어는 그 사이(holding 0.82 , on 0.64 , wearing 0.22 )에 놓였습니다.
두 채널을 섞기 전에 각각 점수를 매기므로, 한 번의 순전파에서 공간 그래프(layout graph)와 의미 그래프(content graph)를 따로 꺼낼 수도 있습니다. 공개된 API의 decompose=True 옵션이 이 기능이며, 논문 부록에 따르면 공간 그래프 쪽이 모든 벤치마크에서 더 쉬운 문제였습니다(VG150에서 공간 술어 7개의 R@50이 63.1 , 의미 술어 43개는 48.6 ).
쌍 샘플링: 모든 쌍 대신 128쌍만 점수 매기기
박스가 N 개면 순서 있는 쌍은 N(N-1) 개입니다. RelateAnything은 2단계 샘플러로 먼저 기하적 개연성으로 400개를 남기고, 다시 학습된 연관성(relatedness) 점수로 128개를 남깁니다. 이 샘플러는 주석이 달린 양성 쌍의 99.79\% 를 유지하며, 모든 쌍을 점수 매기면 비용이 1.02\times 늘지만 측정 가능한 이득은 없었습니다.
저자는 이 샘플러의 부작용도 함께 설명합니다. 두 번째(학습되는) 단계는 어떤 쌍에 주석이 달렸는지를 예측하도록 학습되므로, 결국 뒤에서 다룰 주석 성향(annotation propensity) 을 학습합니다. 그래서 샘플러의 로짓은 최종 점수에 덧셈으로만 들어가도록 설계했고, 평가 시점에 이를 제거해 그 기여를 따로 측정할 수 있게 했습니다.
1만 개 술어로 학습하기: 양성-미표지 지도 학습
기존 개방형 어휘 관계 모델은 보통 폐쇄형 모델과 같은 수십 개 술어로 학습하고 헤드만 교체합니다. RelateAnything은 19,103개의 자유 텍스트 술어 문자열 뱅크를 대상으로 학습합니다. RA-4M의 10,102개에, 관계 자체는 학습하지 않는 세 개의 다른 관계 코퍼스(Synthetic Visual Genome, GQA, SpatialSense)의 어휘에서 가져온 9,001개를 더한 것입니다. 텍스트 쪽에는 학습되는 부분이 없으므로, 이 뱅크는 지도 신호가 아니라 답의 공간이고, 어떤 단일 소스보다 넓게 만들어도 비용이 들지 않습니다.
주 목적 함수는 술어 슬롯에 대한 배치 단위 InfoNCE 손실입니다. 주석이 달린 쌍마다 양성은 주석 술어가 속한 동의어 그룹(synonym group) 전체이며, 각 구성원은 추정한 동의어 확률로 가중해 평균냅니다. 음성은 배치 안의 다른 술어들입니다.
어휘가 50개일 때는 주석이 없는 술어를 모두 음성으로 취급해도 대체로 맞습니다. 하지만 1만 개가 되면 이 가정이 체계적으로 틀립니다. ⟨man, horse⟩ 쌍에 riding 이 주석되어 있다면 sitting on 과 mounted on 도 참이지만 적혀 있지 않을 뿐이고, 이를 음성으로 벌하면 모델은 맞는 답을 억누르도록 학습됩니다. 이것이 양성-미표지(PU, Positive-Unlabeled) 학습의 구조입니다.
RelateAnything은 모든 술어 쌍에 대해 p 가 주석되었을 때 q 도 성립할 확률 \hat{P}(q \mid p) 를 추정하고, 그만큼 음성의 가중치를 깎습니다. 이 추정치는 학습 혼합 데이터에서 주석이 두 개 이상 달린 70만 6천 개의 박스 쌍으로부터, 공동 주석 빈도와 텍스트 공간 코사인, 빈도를 이용해 적합하고, 미표지를 거짓으로 오인하지 않도록 Elkan and Noto (2008)의 보정을 적용합니다. 주석 술어가 p 인 쌍에서 음성 q 의 분모 로짓은 다음과 같이 바뀝니다:
거의 확실히 함께 참인 술어는 분모에 거의 기여하지 않게 됩니다. 여기에는 두 가지 중요한 예외가 있습니다. 주석된 술어는 절대 가중치를 낮추지 않고, 방향이 반대인 술어(inverse)는 항상 전체 가중치를 받습니다. 저자의 표현을 빌리면 "above와 below를 구분하는 지도 신호는 결코 약화되어서는 안 되는 유일한 신호"이기 때문입니다.
이 밖에 셀 단위 시그모이드(sigmoid) 보조 손실, 방향성 술어에 대한 스왑 힌지(swap hinge) \mathcal{L}_{\mathrm{swap}} = \max(0,\ m - c(i,j,p) + c(j,i,p)) (마진 m = 0.05 ), 배경 억제(background suppression), 객체-텍스트 그라운딩 항이 보조 목적 함수로 쓰입니다. 동의어 가중치는 1,177개 어휘 동의어 쌍에 대한 등위 회귀(isotonic fit)로, 스왑 힌지 가중치는 술어가 방향성일 추정 확률로 정하므로, 목적 함수의 의미적 상수 중 사람이 손으로 정한 것은 없다고 합니다. 좌우 관계가 균형 있게 들어 있으므로 레이블을 고치지 않는 수평 뒤집기 같은 기하 증강은 쓰지 않고, 기하와 무관한 색상 증강만 유지합니다. 공개된 학습 레시피는 A100 GPU 4장에서 5시간 4분이 걸립니다.
텍스트 임베딩 공간의 방향 문제와 증류한 텍스트 인코더
헤드는 시각 특징을 텍스트 방향에 맞추도록 학습되므로, 텍스트 공간의 기하 구조가 모델이 표현할 수 있는 것의 상한을 정합니다. 문제는 대조 학습(Contrastive Learning)으로 만든 텍스트 인코더가 관계에 가장 중요한 차원에서 실패한다는 점입니다. 반의어는 거의 같은 문맥에 등장하므로 거의 같은 벡터로 임베딩됩니다.
저자가 교사(teacher)로 쓴 dino.txt 인코더(2048차원)는 이 논문의 어휘에서 above 와 below 를 코사인 0.95 에, in front of 와 behind 를 0.94 에, to the left of 와 to the right of 를 0.99 에 놓았습니다. 동의어 쌍의 평균 코사인이 0.96 이니 반의어와 동의어를 구분할 수 없는 수준입니다. 이런 타깃에 맞춰 학습하는 시각 인코더는 누가 학습하든 above와 below를 안정적으로 구분할 수 없습니다. 저자는 이것이 시각 모델이 아니라 목적 함수의 한계이며, 기성 텍스트 임베딩으로 관계를 점수 매기는 모든 방법에 해당한다고 지적합니다. 평균 방향을 제거하는 기존 처방으로도 해결되지 않았습니다.
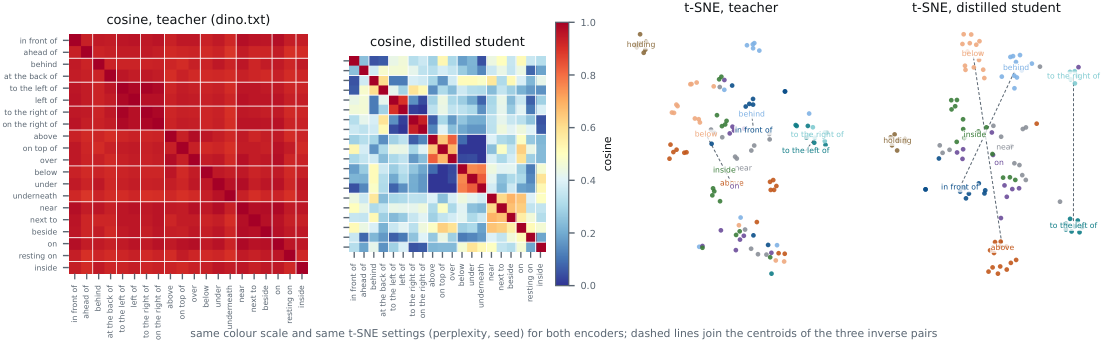
그래서 RelateAnything은 CLIP의 BPE(Byte Pair Encoding) 어휘 전체를 쓰는 512차원 학생(student) 인코더를 증류(Distillation) 해서 사용합니다. CLIP BPE 어휘를 쓰므로 어떤 술어 문자열도 어휘 밖(OOV, Out-of-Vocabulary)으로 빠지지 않습니다. 증류 목적 함수 중 핵심은 두 가지입니다. 알려진 반의어 쌍의 코사인을 마진 아래로 밀어내는 반의어 반발(antonym repulsion) 힌지는 고정된 교사가 줄 수 없는 신호이고, 이웃 보존(neighbourhood preservation) 항은 학생이 이 분리를 값싸게 얻지 못하게 막습니다. 이웃 보존 항이 없으면 학생은 동의어 대 반의어 AUC는 비슷하게 좋지만( 0.980 대 0.989 ) 유효 차원(effective dimension)이 44 에서 24 로 무너집니다.
증류 후에는 동의어와 반의어를 구분하는 AUC가 0.85 에서 0.99 로 올랐고, 반의어 쌍의 평균 코사인은 0.92 에서 0.09 로 떨어졌으며, 동의어는 0.71 로 뭉쳐 있었습니다. 허브성(hubness)도 8.1 에서 1.3 으로 줄었습니다. 위 그림에서 왼쪽 두 패널이 20개 공간 술어의 코사인 행렬인데, 교사는 0.8 이상의 거의 균일한 블록인 반면 학생은 동의어 블록을 유지하면서 반의어 블록을 0 근처로 떨어뜨렸습니다. 학생 인코더는 오프라인에서 임베딩 뱅크를 만들 때만 쓰이고, 추론 시에는 모델이 임베딩 뱅크만 들고 다닙니다.
이 설계에는 한 가지 결과가 따라옵니다. 모델이 동의어 그룹 단위로 정렬되어 있으므로, VG150 주석이 wears 인 곳에 wearing 처럼 같은 그룹의 다른 문자열로 답하는 일이 잦습니다. 정확한 문자열 일치(exact-string)로 채점하면 이는 오답이 됩니다. 가장 뚜렷한 예가 방향 술어입니다. 주석이 to the right of 인 곳에 모델이 on the right of 로 답하면 정확한 문자열 재현율에서는 오답이지만, 주어와 목적어를 바꿔 방향 자체를 측정하면 모델의 방향 정확도는 0.97 이었습니다. 따라서 폐쇄형 어휘 기준의 수치는 이 모델에 불리하게 보수적이고, 뒤에서 다룰 A3 축이 이를 보정한 수치입니다.
RA-4M: 기하 검증을 거친 자유 텍스트 관계 코퍼스
모델만으로는 충분하지 않습니다. 벤치마크 어휘가 아닌 어휘로, 미표지 쌍이 드물 만큼 조밀하게, 그리고 오류를 검출할 수 있는 형태로 주석된 코퍼스가 필요한데, 그런 코퍼스가 없었기 때문에 저자는 직접 만들었습니다. 그 결과가 474,413장의 이미지와 4,282,531개의 관계, 10,102개의 서로 다른 자유 텍스트 술어로 이루어진 RA-4M이며, 전체 생성에 104 GPU시간이 들었습니다.
왜 비전-언어 모델을 주석자로 쓰는가
객체 박스에는 정답이 하나 있지만, 관계는 쌍에 대한 주장입니다. 객체가 N 개인 이미지에는 N(N-1) 개의 쌍이 있고, 대부분의 쌍에서 관계가 성립하는지는 판단의 문제입니다. Visual Genome 주석자들이 자유롭게 관계를 적었을 때 36,549개의 서로 다른 술어 문자열이 나왔고, 커뮤니티는 그중 가장 흔한 50개만 남겼습니다(VG150). 버려진 나머지가 바로 개방형 어휘 모델이 다뤄야 할 부분입니다.
저자의 판단은 이렇습니다. 비전-언어 모델은 어떤 관계 하나도 사람보다 잘 주석하지는 못하지만, 한계 비용이 거의 없이 더 조밀하고 균일하게 주석하며, 그 오류는 기하 검사로 검출할 수 있는 종류입니다. 그래서 VLM을 예측기가 아니라 주석자로 사용합니다.
생성: 번호 마커와 세 번의 VLM 패스
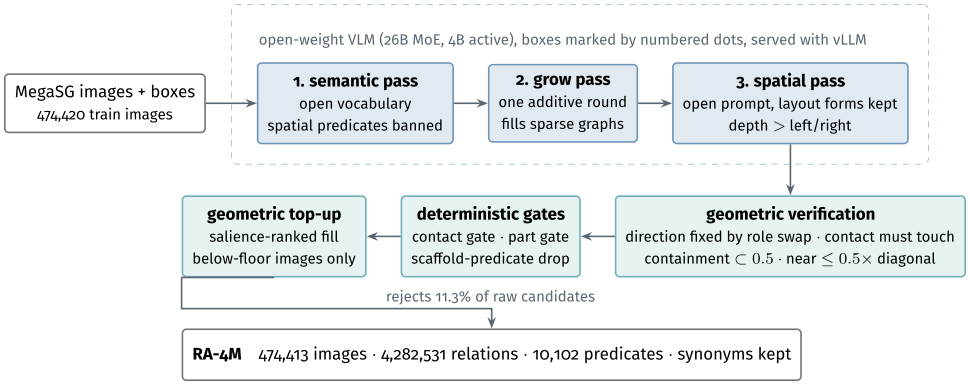
RA-4M은 MegaSG 공개본의 이미지 집합(약 50만 장, 공개된 데이터셋 기준 Objects365 56.9\% , Open Images V6 37.6\% , COCO 5.5\% )을 대상으로, 그 객체 박스는 그대로 쓰고 관계 주석만 완전히 새로 만든 것입니다. 박스를 고정했으므로 관계 지도 신호의 기여만 따로 비교할 수 있습니다.
주석자는 Gemma 4 계열의 공개 가중치 VLM(전체 26B, 토큰당 활성 4B의 전문가 혼합(MoE, Mixture-of-Experts) 모델)이며 vLLM으로 서빙합니다. 각 박스 중앙에 박스 번호가 적힌 색깔 점, 즉 번호 마커(numbered marker) 를 찍은 이미지를 보여주므로, 모델은 범주가 아니라 인스턴스를 가리켜 관계를 씁니다. 주석자의 출력에서 어떤 박스를 가리키는지 추측하는 대신, 박스를 처음부터 입력으로 지정하는 셈입니다.
패스는 세 번입니다:
- 의미 패스(semantic pass): 완전히 열린 어휘로 행동과 상호작용을 제안하되, 공간 술어는 명시적으로 금지합니다. 정밀도(Precision)보다 커버리지를 위한 프롬프트입니다.
- 성장 패스(grow pass): 같은 이미지에 한 번 더 추가 라운드를 돌려 성긴 그래프를 채웁니다. 코퍼스 밀도의 대부분과 오류의 대부분이 여기서 나오며,
man wearing human nose같은 실패 때문에 신체 부위 게이트가 따로 생겼습니다. - 공간 패스(spatial pass): 깊이, 접촉, 근접을 좌우 관계보다 먼저 묻는 열린 프롬프트로 배치 관계를 제안하고, 21가지 배치 형태로 환원되지 않는 제안은 버립니다.
그래도 공간 관계 밀도가 기준 이하인 이미지에는 두드러짐(salience) 순으로 기하 기반 보충(top-up)을 수행하며, 이것이 공간 관계의 18.4\% 를 차지합니다.
설계 비교 중 예상과 반대로 나온 결과도 두 가지 있었습니다. 관계를 내놓기 전에 정당화부터 하게 하는 검증 후 주장(verify-before-assert) 프롬프트는 정밀도를 높였지만 의미 술어 종류를 404개에서 135개로 줄였고, 결정적 게이트는 다양성 손실 없이 같은 정밀도에 도달했습니다. 반대로 순수 기하 규칙만으로 만든 공간 레이어는 비용이 없지만 표현이 6가지뿐이고 58\% 가 좌우 관계였던 반면, 제안 후 검증(propose-then-verify) 방식은 20가지 표현에 깊이 관계 32.5\% , 좌우 29\% , 근접 14\% , 접촉 13\% 를 얻었습니다.
결정적 기하 게이트와 방향 균형
모든 제안 관계는 결정적 기하 게이트를 통과해야 하며, 이 게이트가 원시 후보의 11.3\% 를 기각합니다. 설계 원칙은 "박스 기하가 술어를 논리적으로 제약하는 경우에만 게이트가 작동한다"는 것입니다. 그러면 기각은 박스 주석 오차 범위 안에서 참 음성이 되고, 기하로 제약할 수 없는 술어는 검사 없이 통과하되 잔여 위험으로 집계됩니다. 저자는 제약할 수 없는 경우까지 추측하는 게이트는 알려진 커버리지 공백을 오류율을 알 수 없는 오류로 바꿀 뿐이라고 설명합니다.
게이트는 관계를 기각하거나 역할을 바꿀 뿐, 술어 문자열은 주석자가 쓴 것을 유지합니다. 접촉 술어는 박스가 맞닿아야 하고, 포함과 근접은 박스로 확인합니다. 방향 복구는 기각하지 않는 유일한 게이트로, 좌우와 상하 관계는 박스에 맞게 주어와 목적어 역할을 바꾸고 표현은 그대로 둡니다. 게이트를 거친 뒤 포함 관계의 0\% , 접촉 관계의 0.1\% 만 박스가 떨어져 있고, 중복 삼중항과 자기 루프(self-loop)는 없습니다.
한 가지 더 눈여겨볼 단계가 있습니다. 주석자는 왼쪽과 위쪽 물체를 주어로 삼는 경향이 있어서, 검증을 통과한 좌우, 상하, 앞뒤 관계는 확률 \frac{1}{2} 로 반대편 끝점에서 다시 서술됩니다(역할을 바꾸고 술어를 반의어로 교체, to the left of → to the right of). 이렇게 하면 코퍼스의 방향이 균형을 이루는데, 저자에 따르면 모델이 의존하는 이 성질을 가진 원본 코퍼스는 없었습니다.
남은 오류는 기하로 제약할 수 없는 부류입니다. 가장 큰 것은 시선 관계로, looking at 과 watching 주석의 약 22\% 는 박스가 떨어져 있어 검증할 수 없습니다. 잘못된 인스턴스를 가리키는 경우, 아주 큰 박스에 사전 지식으로 붙인 레이블, 겹치지만 관련 없는 박스 사이의 접촉 술어(person wearing tent 는 박스가 실제로 겹치므로 접촉 게이트를 통과합니다), 원본 박스의 레이블 오류도 코퍼스에 그대로 남습니다.
RA-4M 통계
같은 이미지, 같은 박스에 대해 원래 주석(MegaSG)과 비교하면 아래와 같습니다:
| 코퍼스 | 이미지 | 관계 | 이미지당 관계 | 술어 종류 | 엔트로피(nats) |
|---|---|---|---|---|---|
| RA-4M | 474,413 | 4,282,531 | 9.03 | 10,102 | 3.99 |
| MegaSG 원본 주석 (같은 이미지) | 474,420 | 2,510,905 | 5.29 | 94 | 2.56 |
| 원본 Visual Genome | 108,077 | 2,315,906 | 22.10 | 36,549 | 3.81 |
| 누출 필터 후 Visual Genome (보조 소스) | 40,615 | 758,547 | 18.70 | 17,742 | - |
위 표를 통해 RA-4M이 같은 박스 위에서 1.7\times 더 조밀하고, 어휘는 107\times 넓으며, 술어 엔트로피가 1.4 nats 높다는 것을 알 수 있습니다. 원래의 94개 술어 클래스 중 73개는 정확히 같은 문자열로 재현되었습니다. 객체의 평균 차수(degree)는 1.88 에서 3.20 으로, 그래프 전체가 하나의 연결 요소를 이루는 이미지 비율은 70.9\% 에서 82.6\% 로 늘었습니다. 분포는 여전히 롱테일(상위 10개 술어가 질량의 57\% )이지만, 상위 술어가 near 와 on 에서 behind, in front of, wearing, to the right of, to the left of 로 바뀌었습니다.
holding, grasping, carrying 을 포함한 같은 계열의 538개 표현은 하나로 합치지 않고 서로 다른 문자열로 남겼습니다. 배포 어휘가 임의적인 모델은 텍스트 공간을 조밀하게 채우는 타깃으로 학습해야 하기 때문이며, 정규화된 그룹은 손실 함수와 게이트 안에서만 쓰입니다. 모든 평가 분할은 이미지 ID 대응표와 지각적 근사 중복(perceptual near-duplicate) 검색으로 제외했고, 이 과정에서 코퍼스 이미지 8,687장과 원본 Visual Genome 이미지 32,456장이 빠졌습니다.
공개된 Hugging Face 데이터셋의 학습 분할은 게이트에서 관계가 모두 기각된 이미지를 뺀 472,344장이고, 모든 객체에 박스를 프롬프트로 준 SAM 3 마스크가 함께 들어 있습니다. 평가 누출 때문에 학습에서 뺀 8,687장은 공개 분할에 남아 있고 그 목록(clean_train_excluded.json)이 따로 제공되므로, 해당 벤치마크에 결과를 보고하려면 먼저 걸러내야 합니다.
학습 혼합과 두 개의 타워
RA-4M 하나만으로 학습하지는 않습니다. 논문은 백본, 쌍 헤드, 학습 혼합의 조합을 타워(tower) 라고 부르고, 두 타워를 줄곧 함께 평가합니다:
-
제로샷 타워: RA-4M과 누출 필터를 거친 원본 Visual Genome 주석(VG150의 50개가 아니라 자유 텍스트 문자열 전체)으로 학습합니다. 이 논문의 어떤 평가 분할 이미지도, 어떤 벤치마크의 레이블 집합도 본 적이 없습니다.
-
공개 타워(released tower): 여기에 HICO-DET 학습 분할을 이미지 기준 21.0\% 로 더합니다. HICO-DET은 이미지당 관계가 1.94개뿐이라 관계 기준으로는 5.0\% 입니다. 소스별로 주석할 수 있었던 술어만 음성으로 쓰는 소스 인지 음성(source-aware negatives) 도 적용합니다. HICO-DET은 동사만 주석하고 공간 관계는 주석하지 않으므로, 그 소스의
holding주석이on의 반증이 될 수 없기 때문입니다.
두 타워 모두 같은 19,103개 문자열 뱅크로 점수를 매기며, HICO-DET 자체를 제외한 모든 축에서 두 타워의 차이는 1포인트 미만이었습니다. 별도 표시가 없으면 논문의 모든 표는 공개 타워의 결과입니다.
OV-SGG-Bench: 장면 그래프 재현율은 무엇을 측정하는가
이 논문에서 가장 많은 분량을 차지하고, 저자 스스로도 가장 중요하다고 꼽는 부분이 측정입니다. 저자는 측정 문제가 표준 프로토콜 안에서는 보이지 않기 때문에 세 장애물 중 가장 영향이 크다고 강조합니다. 이 절의 분석에서 모델과 코퍼스는 측정 도구로만 쓰였고, 결론은 그 설계에 의존하지 않습니다.
먼저 지표를 정리하면 다음과 같습니다. R@K 는 이미지의 주석된 ⟨주어, 술어, 목적어⟩ 삼중항 중 상위 K 개 예측에 들어간 비율의 평균으로, 모든 삼중항을 똑같이 세므로 빈도 높은 술어가 지배합니다. mR@K 는 술어별 R@K의 평균이라 드문 술어도 on 과 같은 비중을 가지며, F1@K 는 둘의 조화 평균입니다. 논문의 모든 수치는 쌍 하나가 상위 K 슬롯에 최고 점수 술어 하나만 올릴 수 있는 그래프 제약(graph-constrained) 방식입니다(제약을 풀면 이 모델 기준 VG150에서 R@50이 11.6 포인트 오릅니다). 정답 박스를 주고 관계만 채점하는 방식과, 검출기가 박스를 공급하는 검출 모드(SGDet) 두 가지로 평가합니다.
재현율이 보상하는 세 가지 사전 지식
공유 삼중항 질량(Shared Triplet Mass)
VG150 테스트 분할은 학습 분할과 똑같은 50개 술어를 쓰므로, VG150으로 학습한 모델은 어휘 측면에서 새로운 것을 전혀 만나지 않습니다. 그런데도 OvR-SGG 리더보드는 바로 이 수치로 개방형 어휘 방법들의 순위를 매깁니다.
저자는 이 교란 요인을 공유 삼중항 질량으로 정량화했습니다. 학습 코퍼스의 관계 인스턴스 중 ⟨주어 범주, 술어, 목적어 범주⟩ 삼중항이 벤치마크에도 주석되어 있는 비율입니다. 술어가 아니라 삼중항을 쓰는 이유는, 사람과 말 사이의 on 과 책과 책상 사이의 on 은 서로 다른 행위이고, 두 코퍼스가 문자열에는 동의하면서도 그 문자열이 서술하는 쌍에는 한 번도 동의하지 않을 수 있기 때문입니다.
수치를 보면 교란이 도메인 내에 몰려 있고 그 크기가 매우 큽니다. 베이스라인(OvSGTR)의 미세조정 코퍼스는 관계 질량의 90.9\% 가 VG150에도 주석된 삼중항인 반면, RelateAnything의 학습 혼합은 12.8\% 입니다. PSG에서는 각각 8.6\% 와 10.7\% 로 비슷합니다. 이 통계에는 예측력도 있습니다. 원본 Visual Genome 비중을 늘린 실험군은 VG150에서 R@50 54.3 으로 저자가 아는 한 최고의 제로샷 수치를 기록했지만, 모든 꼬리(tail) 지표에서는 저자가 학습한 모델 중 가장 나빴습니다.
객체 범주 사전 지식
⟨주어, 목적어⟩ 범주 쌍마다 학습 데이터에서 가장 흔한 술어를 돌려주는 빈도 기반 조회 테이블(freq baseline)이 강한 장면 그래프 베이스라인이라는 것은 Neural Motifs (Zellers et al., 2018) 이후 잘 알려져 있습니다. 이 테이블은 정답 객체 레이블을 읽지만 이미지는 전혀 보지 않습니다. 저자는 이를 제로샷 타워와 정답 쌍 위에서 간선(edge)별 top-1 정확도로 비교했습니다:
| 벤치마크 | 간선 수 | micro: freq | micro: RelateAnything | macro: freq | macro: RelateAnything | 우리만 맞힌 간선 |
|---|---|---|---|---|---|---|
| VG150 | 152,535 | 68.4 | 57.7 | 18.9 | 35.1 | 6.9 |
| PSG | 13,623 | 50.9 | 43.3 | 20.7 | 31.6 | 12.8 |
| IndoorVG | 29,175 | 67.9 | 57.3 | 29.8 | 38.4 | 8.2 |
위 표에서 빈도 테이블은 간선별(micro) 정확도에서 세 벤치마크 모두 약 15\% 앞서지만, 같은 예측을 술어별(macro)로 평균하면 RelateAnything이 29 ~ 86\% 앞섭니다. 빈도 테이블은 범주 쌍마다 다수 술어만 돌려주므로 micro 지표는 이를 보상하고 macro 지표는 벌합니다.
저자는 이 표를 과하게 읽지 말라고 두 가지를 짚습니다. 모델이 빈도 테이블이 틀린 간선의 6.9 ~ 12.8\% 를 맞히므로 시각 입력이 필요 없다는 뜻이 아니고, 빈도 테이블은 모델이 한 번도 보지 못하는 정답 범주를 받으므로 모델이 약하다는 뜻도 아닙니다. 결론은 좁습니다: "픽셀을 보지 않는 조회 테이블이 이길 수 있는 지표는 관계 이해를 측정하지 않으며, 그 지표가 바로 리더보드의 순위를 정한다."
주석 성향
세 번째 사전 지식은 주석이 빠뜨린 곳에 있습니다. 이미지마다 몇 쌍만 주석되고 나머지는 비어 있지만, 비어 있는 쌍이 음성인 것은 아닙니다. PSG 테스트에서 최대 F1 임계값으로 RelateAnything 체크포인트가 내놓은 간선의 78\% 는 어느 방향으로도 주석된 적 없는 쌍에 떨어졌고, 주석된 삼중항과 일치한 것은 11\% 였습니다. 어떤 쌍에 주석이 달리는지를 예측하도록 학습한 모델은 결국 주석 성향을 배우며, 이 코퍼스들에서 그것은 사실상 접촉 사전 지식입니다. RelateAnything에서는 앞서 설명한 쌍 연관성 점수가 이 항에 해당하는데, 이를 유지하면 주석 기반 벤치마크의 재현율은 오르고 사람이 판정한 음성이 있는 SpatialSense의 참/거짓 판단은 나빠졌습니다.
방법 간 차이보다 큰 두 가지 채점 관례
저자는 OvR-SGG 리더보드(VG150의 50개 술어 중 15개를 학습에서 빼고 검출 모드로 채점)를 재현하다가 두 가지 채점 관례를 발견했습니다. 먼저 재현의 충실도를 확인했는데, 공개 체크포인트를 저자의 추론 코드로 실행하고 베이스라인의 지표를 옮겨 채점했을 때 발표된 12개 수치를 모두 0.35 포인트 이내로 복원했습니다.
첫째는 매처의 중복 점수입니다. 표준 검출 모드 매처는 예측 삼중항의 주어와 목적어 박스가 각각 정답과 IoU \geq 0.5 이고 레이블 삼중항이 일치하면 점수를 줍니다. 여기에 할당 제약이 없어서, 정답 객체 하나를 검출 d 개가 덮으면 같은 관계를 맞힐 기회가 d 번 생깁니다. VG150 테스트에서 복원된 정답 박스 하나를 평균 2.99 개의 검출이 덮고 있었습니다. 객체 검출은 COCO 이후로 이를 허용하지 않습니다. 이 제약을 되살리면 발표된 모델의 R@50이 12.0\% , novel R@50이 13.5\% 떨어지는데, 이는 Base+Novel R@50 기준 2.45 포인트로, 같은 방법의 백본을 Swin-T에서 Swin-B로 바꿔 얻는 2.39 포인트(리더보드에서 별도 항목)보다 큽니다.
둘째는 보고되지 않는 검출기 작동점입니다. 검출 모드 재현율의 상한은 두 끝점이 모두 검출된 정답 관계의 비율인 쌍 재현율(pair recall) 이고, 쌍 재현율은 객체 재현율의 제곱에 비례합니다. 이 상한은 검출기 자체가 아니라 신뢰도 임계값과 박스 상한 개수에 따라 달라지는데, 이 값은 거의 보고되지 않습니다. 검출기 가중치를 고정하고 이 두 설정만 바꿔도 네 가지 검출기와 벤치마크 조합에서 상한이 상대적으로 12 ~ 49\% 움직였고, VG150에서는 19 포인트였습니다. 리더보드에 발표된 모든 방법 간의 차이는 4.3 포인트입니다. 임계값은 검출기 계열 간 비교를 뒤집기도 합니다. 베이스라인의 GroundingDINO는 임계값 없이 이미지당 박스 97개를 남겨 상한이 0.82 인 반면 YOLO 검출기는 27개로 0.64 였지만, 박스 예산을 맞추면 YOLO도 0.83 에 도달했습니다.
6개 축과 합성 점수
이런 분석을 바탕으로 OV-SGG-Bench는 6개 축의 측정값을 하나의 벡터로 함께 보고합니다. 각 축은 다른 축이 답하지 못하는 질문에 답하고, 혼자 읽었을 때 어떻게 속을 수 있는지도 함께 명시합니다:
| 축 | 측정하는 것 | 혼자 읽을 때의 함정 |
|---|---|---|
| A1 전이 | 정답 박스 위 폐쇄형 어휘 재현율, 공유 삼중항 질량이 다른 4개 소스 | 코퍼스 일치로 달성 가능 |
| A2 정밀도 | Haystack의 명시적 음성에 대한 federated AP와 P-AUC | 점수를 일괄로 낮추는 모델도 순위가 좋게 나옴 |
| A3 개방형 어휘 | 19,103개 문자열 전체를 배포하고 동의어 허용 매칭 | on, in 같은 상위 술어로의 붕괴를 보상 |
| A4 배포 | 공유 개방형 어휘 검출기 위 검출 모드 그래프, 쌍 재현율 상한 대비 | 검출기에 의해 상한이 정해짐 |
| A5 그래프 품질 | 정답 없이 VLM 판정자가 하나씩 받아들인 관계의 정보량 | 전체 그래프를 보여주면 판정자가 짧고 반복적인 그래프를 선호 |
| A6 공간 | SpatialSense의 적대적으로 수집된 참/거짓 균형 삼중항 (우연 수준 50\% ) | 이미지를 보지 않는 박스 전용 베이스라인이 68.8 을 기록 |
두 축은 구조적으로 사전 지식이 통하지 않습니다. A2는 사람이 판정한 음성으로 채점하므로 주석 성향이 도움이 되지 않고, A6는 설계상 균형이 맞춰져 있어 범주 사전 지식이 도움이 되지 않습니다. 저자는 관계 이해 능력에 대한 이 논문의 모든 주장이 이 두 축에 기대고 있다고 밝힙니다.
합성 점수 OVS 는 A1, A2, A4, A5, A6의 각 셀을 우연 수준으로 보정한 뒤 조화 평균으로 결합합니다. 조화 평균은 축 사이의 불균형을 벌하므로, 한 축만 최적화하는 모델 선택을 막는 역할을 합니다. A3는 유일하게 실행 가능한 베이스라인이 매처를 거쳐야 하는데, 매처 선택이 시스템 간 차이보다 결과를 더 크게 움직이므로 보고만 하고 합성에서는 제외했습니다.
실험 결과
아래 수치는 모두 저자가 하나의 평가기로 자체 측정해 공개한 값입니다. 모든 결과는 학습에서 이미지와 주석이 제외된 분할에서, 그 벤치마크의 레이블 집합으로 학습하지 않은 타워로 측정했습니다(HICO-DET 표시 행 제외). 하나의 평가기가 모든 시스템을 채점하고, 각 셀 옆에 공유 삼중항 질량을 함께 적었습니다.
6개 축 요약
| 축 | 측정값 | 최강 베이스라인 | RelateAnything | 베이스라인 |
|---|---|---|---|---|
| A1 전이 | VG150, F1@50 (mR@50) | 19.6 (15.2) | 36.9 (28.2) | ROBIN-3B |
| PSG, F1@50 (mR@50) | 27.9 (22.9) | 34.7 (30.6) | ROBIN-3B | |
| IndoorVG, F1@50 (mR@50) | 22.7 (21.5) | 37.8 (29.5) | ROBIN-3B | |
| HICO-DET, F1@50 (mR@50), 제로샷 타워 | 7.9 (4.5) | 18.7 (12.7) | OvSGTR | |
| A2 정밀도 | 평균 fAP (드문 술어 fAP) | 52.1 (44.6) | 72.6 (70.7) | OvSGTR |
| A3 개방형 어휘 | 19,103개 문자열 mR@50, VG150 / PSG / IndoorVG | 20.9 / 25.1 / 25.4 | 34.5 / 28.3 / 34.6 | ROBIN-3B |
| A4 검출기 | 공유 YOLO-World 위 PSG, wR@50 (mR@50) | 4.0 (6.2) | 20.0 (20.5) | OvSGTR |
| A5 그래프 품질 | 이미지당 참 비트 (주석 대비 비율) | 13.4 (0.48) | 18.6 (0.67) | OvSGTR |
| A6 공간 | SpatialSense macro AUC (pooled AUC) | 59.1 (61.7) | 69.0 (67.5) | OvSGTR |
| OVS 합성 | 우연 보정 축들의 조화 평균 | 11.8 | 40.1 | OvSGTR |
위 표를 통해 RelateAnything이 여섯 축 모두에서 각 축의 최강 베이스라인보다 높고, 합성 점수는 40.1 대 11.8 이라는 것을 알 수 있습니다. 베이스라인 열은 두 시스템을 섞은 값이라, 합성 점수는 모든 축에서 실행 가능한 OvSGTR만으로 계산했습니다. 축을 하나씩 빼고 계산해도 두 시스템의 순서는 바뀌지 않았고, 비율은 2.0 ~ 3.7\times 였습니다. 아래에서 축별로 자세히 살펴보겠습니다.
A1: 네 벤치마크에서의 교차 데이터셋 전이
A1은 정답 박스를 주고 벤치마크의 어휘를 모델에 제공한 상태에서 측정합니다. 베이스라인은 정답 객체 레이블을 받고, RelateAnything은 받지 않습니다:
| 소스 | 공유 삼중항 질량 | OvSGTR R@50 | OvSGTR mR@50 | OvSGTR 드문 술어 | RelateAnything R@50 | RelateAnything mR@50 | RelateAnything 드문 술어 |
|---|---|---|---|---|---|---|---|
| VG150 | 13% | 39.9 | 10.4 | 0.0 | 53.3 | 28.2 | 42.7 |
| PSG | 11% | 28.7 | 8.8 | 1.7 | 40.1 | 30.6 | 23.9 |
| IndoorVG | 7% | 48.1 | 12.8 | 4.0 | 52.7 | 29.5 | 21.6 |
| HICO-DET (제로샷 타워) | - | 34.0 | 4.5 | 0.2 | 35.3 | 12.7 | 4.3 |
| HICO-DET (+HICO-DET 학습 5\% ) | - | 34.0 | 4.5 | 0.2 | 45.2 | 31.4 | 23.9 |
RelateAnything은 객체 레이블 없이도 모든 소스의 모든 지표에서 OvSGTR보다 높았고, micro 재현율도 마찬가지였습니다. 다만 격차의 크기는 지표마다 다릅니다. 상위 술어 재현율은 1.04 ~ 1.40\times 이지만 평균 재현율은 2.3 ~ 3.5\times , 드문 술어 재현율은 5 ~ 21\times 입니다(VG150에서는 베이스라인이 정확히 0.0 이라 비율을 정의할 수 없습니다).
저자는 이것이 앞서 설명한 사전 지식 일치 가설이 예측하는 패턴이라고 설명합니다. VG150은 OvSGTR 자신의 벤치마크로, 삼중항 질량이 90.9\% 공유되어 있고, 그 대표 수치는 시각 입력 없이도 복원 가능한 21개 빈도 술어가 떠받치고 있습니다. 한편 A1에서 가장 강한 베이스라인은 OvSGTR이 아니라 ROBIN-3B로, 세 벤치마크의 F1@50이 19.6 / 27.9 / 22.7로 OvSGTR의 16.5 / 13.5 / 20.2보다 높았지만 RelateAnything에는 두 지표 모두에서 뒤졌습니다.
A2 ~ A4: 정밀도, 전체 어휘, 검출 모드
A2 정밀도는 재현율이 환각(hallucination)을 벌하지 않는다는 문제를 겨냥합니다. 미표지 쌍이 음성이 아니므로, 모델은 재현율 손해 없이 거짓 관계를 주장할 수 있습니다. 그래서 A2는 주석자가 직접 보고 해당 술어가 아니라고 표시한 명시적 음성을 공개하는 유일한 장면 그래프 테스트셋인 Haystack으로 평가합니다(양성 2,870개 대 명시적 음성 23,174개, 이미지 11,368장). 채점은 LVIS의 federated 방식처럼 표시된 26,044개 셀에서만 합니다.
| 지표 | OvSGTR | RelateAnything | 변화 |
|---|---|---|---|
| 평균 fAP (지지도 5 이상) | 52.1 | 72.6 | +39.2% |
| fAP, 드문 술어 | 44.6 | 70.7 | +58.6% |
| fAP, 보통 술어 | 59.5 | 76.0 | +27.8% |
| 평균 술어 ROC-AUC (P-AUC) | 83.9 | 93.7 | +11.7% |
| 쌍 커버리지 (점수를 매긴 표시 셀) | 100.0 | 89.0 | -11.0% |
RelateAnything의 샘플러는 표시된 셀의 89.0\% 에만 도달하고, 나머지는 배포 시스템이 아무것도 내놓지 않는 쌍이므로 0점으로 처리했습니다. 저자는 같은 예측이라도 모든 미표지 쌍을 거짓 양성으로 세면 AP가 0.035 , 명시적 음성으로만 세면 fAP가 0.56 이 된다는 점도 덧붙였습니다. 두 값의 차이는 전적으로 프로토콜이 미표지 쌍을 어떻게 가정하는가에서 나옵니다.
A3 개방형 어휘는 A1이 모델에 벤치마크 어휘를 알려준다는 도움을 없앤 축입니다. 모델은 19,103개 문자열 전체에서 답을 고르고, 동의어를 허용하는 매칭으로 채점합니다. 그래도 재현율은 무너지지 않았습니다. VG150에서 R@50이 56.0 으로, 50개 문자열을 제공했을 때(53.3 )보다 오히려 높았고, 19,103개 후보 중 정답 문자열의 중앙 순위는 VG150과 IndoorVG에서 1위, PSG에서 10위였습니다. 비교 기준으로, 해당 벤치마크로 학습하고 정답 객체 레이블까지 받는 폐쇄형 전문 모델의 PredCls 최고치는 VG150에서 R@50 68.2 (PE-Net), mR@50 37.0 (VCTree+IETrans+Rwt)입니다.
| 소스 | R@50 | mR@50 | 드문 술어 | MRR(Mean Reciprocal Rank) | 중앙 순위 |
|---|---|---|---|---|---|
| VG150 | 56.0 | 34.5 | 39.6 | 0.68 | 1 / 19,103 |
| PSG | 30.5 | 28.3 | 20.8 | 0.39 | 10 / 19,103 |
| IndoorVG | 53.3 | 34.6 | 34.6 | 0.65 | 1 / 19,103 |
OvSGTR은 이 축에 참여할 수 없습니다. 술어 이름을 하나의 캡션으로 함께 인코딩하므로 어휘가 약 150개 문자열로 제한되고, 19,103개를 140개 캡션으로 나눠도 각 이름의 임베딩이 같은 캡션의 다른 이름에 의존하므로 측정이 되지 않습니다. 저자의 설명대로 이 축은 모델이 처음부터 그렇게 설계되어 있어야 참여할 수 있습니다.
A4 배포는 정답 박스 대신 공유 개방형 어휘 검출기(YOLO-World, 신뢰도 0.05 , 이미지당 최대 60개 박스)가 영역을 공급하는 조건입니다. 두 모델은 같은 쌍 재현율 상한 0.696 에 묶이고, 베이스라인은 검출기의 예측 레이블까지 추가로 사용합니다.
| 모델 | R@50 | mR@50 | 드문 술어 | wR@50 |
|---|---|---|---|---|
| OvSGTR (검출기 레이블 사용) | 17.7 | 6.2 | 1.2 | 4.0 |
| RelateAnything | 25.4 | 20.5 | 17.0 | 20.0 |
A1의 모든 격차가 같은 구조로 유지되었습니다(mR@50 3.3\times , 드문 술어 14\times ). 관계 모델은 박스 소스가 바뀌어도 영향을 받지 않았고, 가장 큰 손실은 검출기에서 나왔습니다. 검출된 클래스를 무시하는 일대일 매처 기준으로 정답 박스 대비 유지율은 PSG에서 62 ~ 63\% , IndoorVG에서 31 ~ 32\% 였습니다. 두 끝점이 모두 검출되지 않으면 관계를 복원할 수 없고, 더 좋은 관계 모델도 더 많은 관계 주석도 쌍 재현율을 올려 주지는 못합니다. 두 모델이 같은 박스로 채점되므로 비교 자체는 작동점의 영향을 받지 않지만, 같은 검출기도 박스 예산을 맞추면 상한이 0.876 까지 오르므로 절대 수치는 신뢰도 0.05 라는 설정에 한정됩니다.
자유 텍스트 시스템(VLM)과의 비교
자유 텍스트로 답하는 시스템은 구조상 A3 축에 참여할 수 있으므로, 다른 축에서는 받아들일 수 없는 베이스라인 계열이 여기서 등장합니다. ROBIN-3B와, 같은 출력을 프롬프트로 요청한 범용 멀티모달 모델 Qwen3-VL, InternVL3.5, GLM-4.6V-Flash입니다. 모두 정답 영역 위에서 평가해 위치 추정(localisation)과 분리된 관계 예측만 측정했습니다. 한 모델의 행들은 같은 생성 결과를 서로 다른 매처로 읽은 것입니다(PSG 테스트 2,179장):
| 모델 | 매처 | R@20 | R@50 | mR@20 | mR@50 | 쌍 커버리지 |
|---|---|---|---|---|---|---|
| RelateAnything (53M) | 정확한 문자열 | 12.3 | 13.6 | 12.4 | 13.0 | 99.7 |
| RelateAnything (53M) | 동의어, \tau = 0.60 | 31.7 | 36.8 | 29.1 | 31.3 | 99.7 |
| ROBIN-3B | 정확한 문자열 | 25.8 | 26.2 | 19.9 | 20.0 | 45.6 |
| ROBIN-3B | SBERT(Sentence-BERT) argmax | 30.4 | 35.7 | 21.1 | 22.9 | 77.4 |
| ROBIN-3B | 동의어, \tau = 0.60 | 35.1 | 37.9 | 24.1 | 25.1 | 65.6 |
| Qwen3-VL-32B | 동의어, \tau = 0.60 | 15.0 | 15.6 | 5.1 | 5.2 | 35.5 |
| Qwen3-VL-8B | 동의어, \tau = 0.60 | 10.2 | 10.2 | 3.3 | 3.3 | 23.6 |
| InternVL3.5-8B | 동의어, \tau = 0.60 | 9.5 | 9.6 | 4.5 | 4.5 | 23.1 |
| GLM-4.6V-Flash | 동의어, \tau = 0.60 | 8.9 | 9.1 | 2.1 | 2.2 | 23.4 |
저자는 매처를 방법 간 차이보다 결과를 더 크게 움직이는 세 번째 채점 관례로 꼽습니다. 자유 텍스트를 벤치마크 단어에 대응시키는 것만으로 ROBIN의 R@50이 +11.7 ( 26.2 → 37.9 ), RelateAnything은 +23.2 올랐습니다. 19,103개 문자열로 답하는 모델일수록 정확한 문자열 매칭에서 가장 크게 손해를 보기 때문입니다. 매처는 평균 재현율의 순서도 정합니다. 정확한 문자열에서는 ROBIN이 20.0 대 13.0 으로 앞서고, 동의어를 허용하는 모든 매처에서는 RelateAnything이 앞섭니다( \tau = 0.60 에서 31.3 대 25.1 ). micro 재현율은 뒤집히지 않아 ROBIN이 계속 앞섰습니다.
매처와 무관하게 남는 사실은 두 가지입니다. 하나는 시스템이 어떤 쌍을 언급하는가, 즉 쌍 커버리지입니다. RelateAnything은 99.7\% , ROBIN은 45.6 ~ 77.4\% , 범용 모델은 23.1 ~ 35.5\% 였고, 한 번도 언급되지 않은 쌍은 맞는 술어를 가질 수 없습니다. 모델 크기를 8B에서 32B로 키워 얻는 것도 주로 이 커버리지(+11.9 포인트)였습니다. 다른 하나는 PSG 밖의 결과입니다. 세 벤치마크를 각자의 프로토콜로 실행하면 RelateAnything이 ROBIN을 두 지표 모두에서 앞섰고, micro 재현율 격차는 VG150에서 1.9\times , IndoorVG에서 2.2\times 인 반면, 이런 시스템들이 주로 비교되는 PSG에서는 1.1\times 에 그쳤습니다.
A5: 정답 없이 판정하는 그래프 품질
A5는 정답 없이 VLM 판정자(judge)가 그래프 품질을 평가하는 축인데, 여기서 저자는 판정자에게 무엇을 물어야 하는가라는 문제를 정면으로 다룹니다. 판정자는 세 가지 판정을 내렸고, 그중 둘은 베이스라인에 유리했습니다.
관계를 하나씩 보여주고 참인지만 물으면, 판정자는 베이스라인의 관계를 약간 더 많이 받아들였습니다(이미지당 4.33 대 4.07 ). 그러나 참 여부만 보면 on 이 유리합니다. on 은 거의 항상 참이고 거의 아무 정보도 없기 때문에, 모든 쌍에 on 이라고 답하는 시스템이 두 모델보다 더 많이 받아들여질 것입니다. 판정자에게 정보량을 평가하게 해도 해결되지 않았습니다. 판정자는 베이스라인의 on 관계에 0~3 척도로 1.05 점을, 다른 술어에는 0.72 점을 주어 의도와 반대의 순서를 매겼습니다. 저자는 이를 "500번째 on의 중복성은 그것이 등장하는 분포의 성질이라, 관계를 하나씩 보는 판정자는 관찰할 수 없다"고 설명합니다.
그래서 A5는 판정자가 참으로 받아들인 관계들의 놀라움(surprisal) 총합으로 정의합니다:
두 요소는 서로의 약점을 보완합니다. 놀라움만 쓰면 무작위로 내놓은 드문 술어가 보상받지만 판정자가 이를 거짓으로 기각하고, 참 여부만 쓰면 on(2.31비트)이 riding(7.04비트)과 같은 대접을 받습니다. 어느 쪽도 반복으로 늘릴 수 없습니다.
| 모델 | 깊이 | 이미지당 주장 | 이미지당 수락 | 수락당 비트 | 이미지당 참 비트 |
|---|---|---|---|---|---|
| RelateAnything | 동일 깊이 (상위 10쌍) | 9.8 | 4.07 | 4.57 | 18.6 |
| OvSGTR | 동일 깊이 (상위 10쌍) | 9.8 | 4.33 | 3.09 | 13.4 |
| RelateAnything | 배포 깊이 | 18.3 | 6.53 | 4.39 | 28.7 |
| OvSGTR | 배포 깊이 | 10.3 | 4.64 | 3.04 | 14.1 |
동일 깊이에서 RelateAnything은 이미지당 18.6 비트, 베이스라인은 13.4 비트이며, 같은 199장의 정답 관계가 담은 27.9 비트 대비로는 0.67 대 0.48 입니다. 판정자의 거짓 수락률을 재는 대조군(같은 이미지의 다른 술어로 바꿔치기한 관계)은 동일 깊이에서 0.201 , 배포 깊이에서 0.135 였습니다.
그래프 전체를 두 개 보여주고 고르게 하면 판정자는 제한 어휘 조건에서 결정적 비교 58번 중 49번 베이스라인을 골랐습니다. 하지만 RelateAnything의 그래프가 더 길고(관계 18.3 개 대 10.3 개), 각 시스템이 상위 10쌍만 내게 하면 결과가 64번 중 40번 RelateAnything 쪽으로 뒤집혔습니다. 또 베이스라인 관계의 66\% 가 on 이었고, 그래프당 최빈 술어 비중이 0.85 대 0.52 였습니다. 그래프 단위 판정으로는 추가 관계가 거짓이라는 해석과 판정자가 짧은 텍스트를 선호한다는 해석을 구분할 수 없어, 저자는 그래프 길이에 의존하지 않는 위 식을 채택했습니다.
A6: 적대적 음성에 대한 공간 관계
A6는 빈도 사전 지식이 도움이 되지 않는 축이며, 저자 스스로 여전히 가장 약한 축이라고 인정하는 부분입니다.
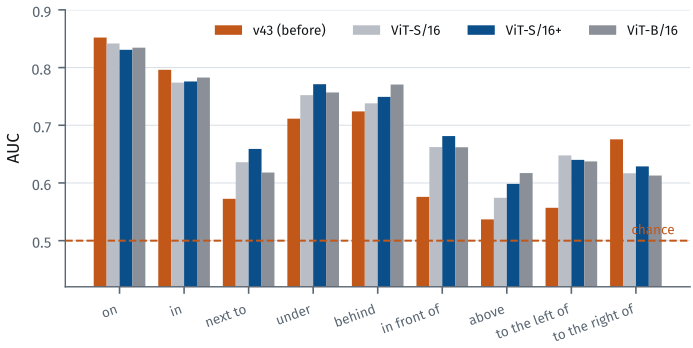
위 그림은 SpatialSense 9개 공간 술어의 술어별 AUC로, 이전 레시피(v43)와 세 가지 백본의 공개 레시피를 비교합니다. on 과 in 은 어느 레시피에서나 학습되었지만, 이전 레시피에서는 above, to the left of, next to 가 우연 수준 근처에 머물렀습니다. 저자에 따르면 재현율을 수십 퍼센트씩 움직인 변경들도 이 투영 술어들은 거의 움직이지 못했고, 이 축이 없었다면 그런 변경이 관계 이해의 개선처럼 보였을 것입니다. 이들을 움직인 것은 셀 단위 시그모이드 보조 손실과 변형 가능 장면 읽기의 조합으로, 공개 타워에서 in front of 가 0.58 → 0.68 , above 가 0.54 → 0.60 , to the left of 가 0.56 → 0.64 로 올라 macro AUC 0.690 , pooled AUC 0.675 가 되었습니다.
OvSGTR은 같은 2,758개 셀에서 macro AUC 0.591 , pooled 0.617 로, RelateAnything은 9개 술어 모두에서 앞섰습니다. 베이스라인은 above(0.495 ), to the right of(0.489 ), under(0.515 )에서 우연 수준이거나 그 이하였습니다. 다만 두 모델 모두 이미지를 보지 않는 SpatialSense 원 저자들의 박스 전용 베이스라인(68.8\% )에 미치지 못했습니다(RelateAnything 62.5\% , 베이스라인 59.0\% ). 따라서 저자는 AUC 0.69 가 시각적 공간 추론의 증거는 아니라고 명확히 밝히며, 남은 격차는 용량이 아니라 지도 신호의 한계라고 해석합니다(백본 크기를 키워도 변하지 않았습니다).
OvR-SGG 리더보드 재현
마지막으로 저자는 OvR-SGG 리더보드 자체에서도, 즉 베이스라인의 매처와 Swin-T 검출기 박스, 예측 레이블, 순위 규칙을 그대로 써서 결과를 보고했습니다(VG150 테스트, 검출 모드, 기본 35개 / 신규 15개 술어, 아래는 주요 행 발췌):
| 방법 | Base+Novel R@50 | Novel R@50 | Base+Novel mR@50 | Novel mR@50 | 맞힌 클래스 |
|---|---|---|---|---|---|
| OvSGTR (Swin-T, 발표값) | 20.5 | 13.5 | n/r | n/r | n/r |
| OvSGTR + MegaSG (Swin-T, 발표값) | 25.4 | 17.0 | n/r | n/r | n/r |
| INOVA (Swin-B, 발표값) | 24.8 | 20.0 | n/r | n/r | n/r |
| OvSGTR (Swin-T, 재실행) | 20.4 | 13.2 | 4.1 | 1.9 | 13/50, 신규 3/15 |
| RelateAnything (신규 15개 제외 재학습) | 22.4 | 11.8 | 14.9 | 7.2 | 40/50, 신규 8/15 |
| RelateAnything (공개 타워, 신규 술어 학습됨) | 27.9 | 24.1 | n/r | n/r | n/r |
신규 15개 술어와 그 동의어 그룹을 빼고 재학습한 모델은 리더보드의 micro 지표에서 중간 정도이며, 저자도 이 열에서 앞선다고 주장하지 않는다고 밝힙니다. 그러나 같은 예측의 평균 재현율은 베이스라인의 거의 4배이고, 50개 술어 중 40개로 답했습니다(베이스라인은 13개). 이 불일치는 분할 구성에서 설명됩니다. 신규 15개 술어가 테스트 관계의 55\% 를 차지하는데, on, of, in 이 신규 질량의 93\% 를 차지합니다. 즉 신규 재현율은 사실상 Visual Genome에서 가장 흔한 세 문자열의 재현율입니다. 전체 어휘 모델과의 격차(R@50 -5.5 , -12.3 )는 이 프로토콜의 신규 성능 중 얼마가 이 세 단어에 대한 지도 신호인지를 보여줍니다.
분석: 객체 예측과 관계 예측을 분리해도 되는가
주류 장면 그래프 구조는 하나의 백본으로 객체와 관계를 함께 예측하고, 관계 헤드를 예측된 객체 클래스에 조건화합니다. RelateAnything은 둘 다 하지 않습니다. 그렇다면 '결합하면 도움이 되지 않았을까?'라는 질문이 자연스럽게 따라옵니다. 저자는 네 가지 실험으로 이에 답합니다.
관계 헤드는 얼마나 객체 레이블에 의존하는가
두 모델을 같은 박스와 예측 레이블(베이스라인의 Swin-T 검출기) 위에서 비교하고, 각 모델이 레이블 쌍마다 가장 자주 내놓는 술어로 만든 자기 조회 테이블(self-lookup) 이 예측을 얼마나 재현하는지 측정했습니다:
| 모델 | 자기 조회 재현율 | 레이블 쌍 조건부 엔트로피(nats) | 빈도 일치율 | 등장한 술어 |
|---|---|---|---|---|
| OvSGTR Swin-T | 87.7 | 0.41 | 65.1 | 20 / 50 |
| OvSGTR Swin-T + MegaSG | 89.9 | 0.37 | 74.3 | 31 / 50 |
| RelateAnything (제로샷) | 68.6 | 1.24 | 52.8 | 50 / 50 |
| RelateAnything | 69.7 | 1.19 | 53.9 | 50 / 50 |
베이스라인 예측의 88 ~ 90\% 는 자기 조회 테이블로 재현되고, 출력 엔트로피는 레이블 쌍이 거의 다 설명해 0.4 nats만 남으며, 50개 술어 중 20~31개만 등장합니다. 개입 실험도 있습니다. 레이블을 박스 사이에서 섞어도 베이스라인의 자기 조회 재현율은 85 로 그대로여서, 베이스라인의 술어는 이미지가 아니라 레이블의 함수입니다. RelateAnything에 남은 69\% 는 사람은 옷을 입고 컵은 탁자 위에 있다는 식으로 범주가 결정하는 몫인데, 입력으로 주어진 것이 아니라 픽셀에서 복원한 것입니다.
영역 소스를 바꿔도 같은 모델이 동작한다
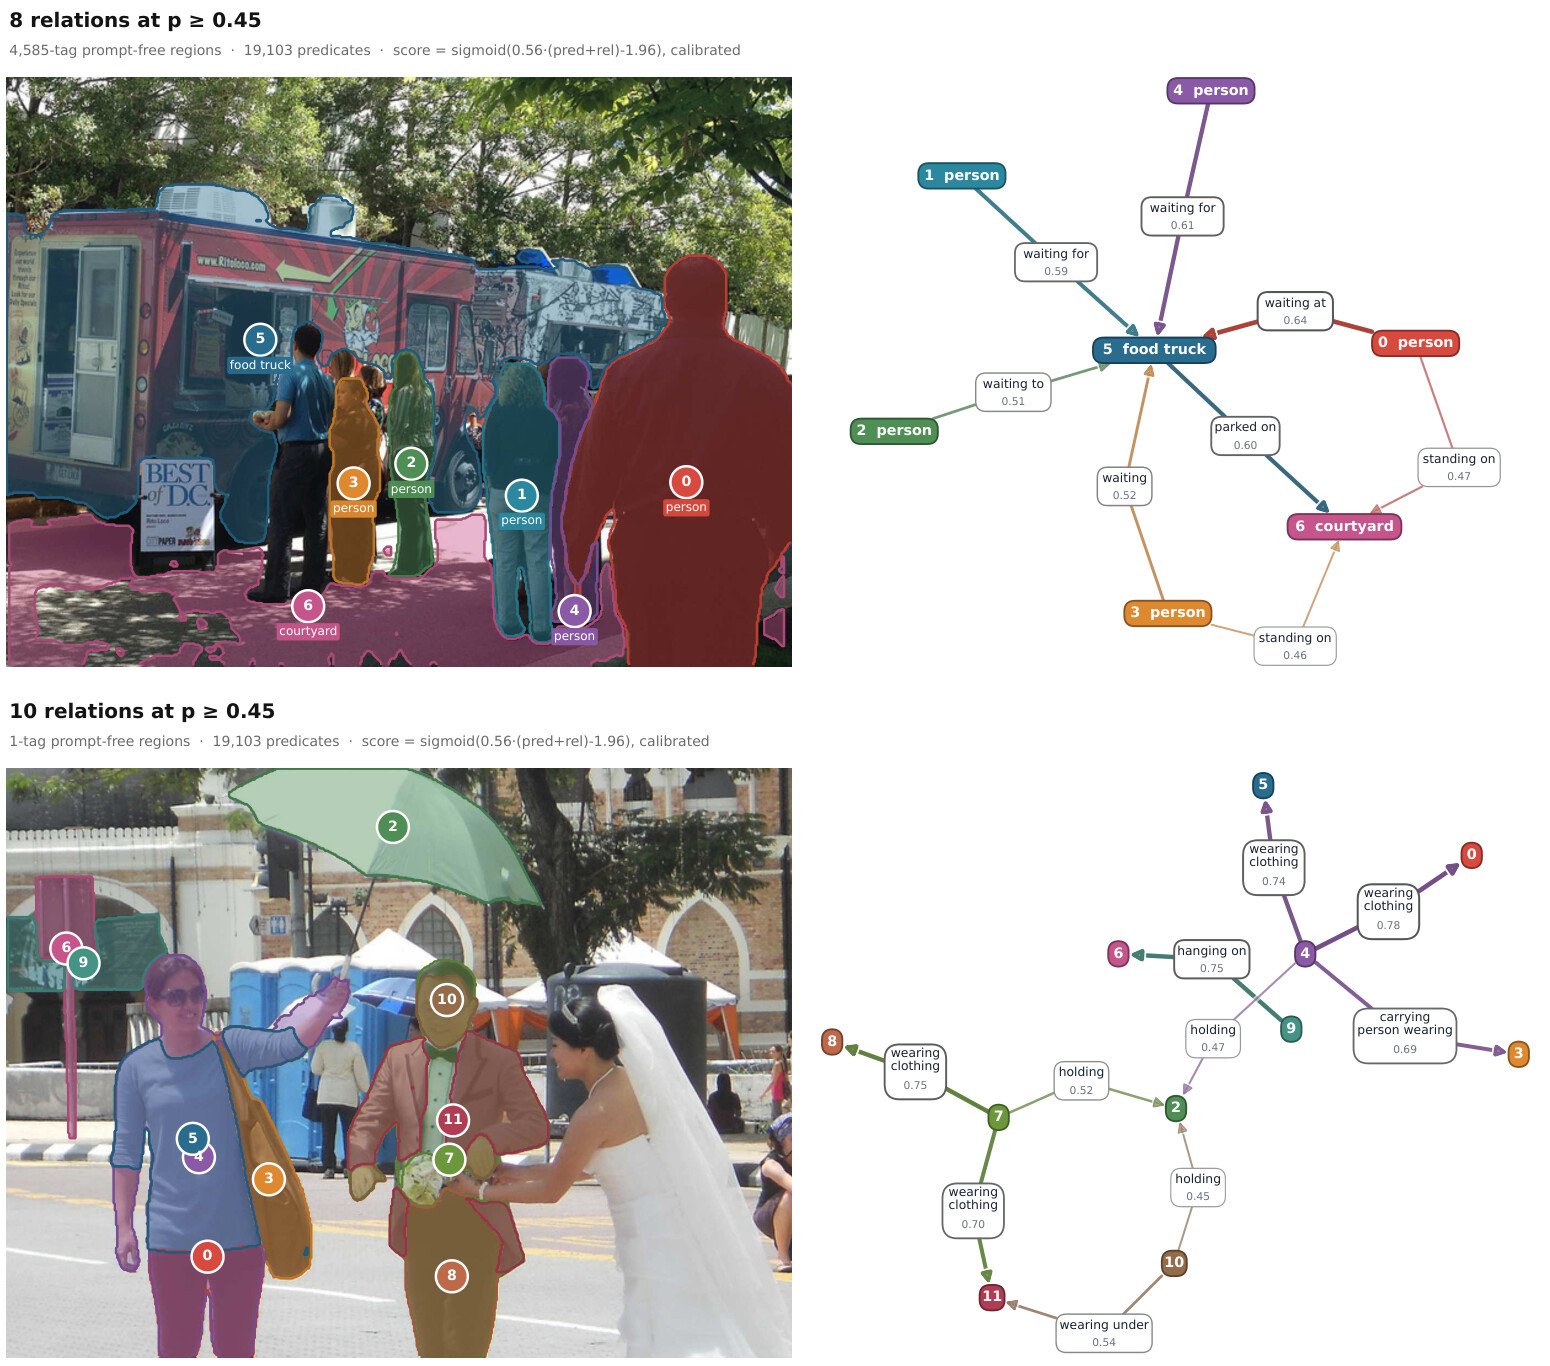
위 그림은 체크포인트 하나를 같은 보정 작동점(p \geq 0.45 )과 19,103개 어휘로 고정하고 영역 소스만 바꾼 결과입니다. 위쪽은 프롬프트 없이 4,585개 태그로 동작한 YOLOE가 7개 영역을 돌려준 경우로, 모델은 여기서 8개 간선을 읽었습니다. food truck 이나 courtyard 는 기존 장면 그래프 어휘에 없는 이름입니다. 아래쪽은 클래스가 하나뿐이라 영역에 이름 없이 번호만 붙는 FastSAM의 결과인데, 모델은 여전히 wearing clothing, holding, carrying person wearing 같은 관계를 돌려줍니다. 위쪽 그림의 이름은 독자를 위해 그린 것이고 모델에는 전달되지 않습니다(두 패널 모두 개발용 소형 체크포인트로 인터페이스를 보여주기 위한 예시입니다).
이 구조가 물려받는 약점도 분명합니다. 검출기가 가구 박스 11개를 돌려주면, 관계 모델은 상호작용이 적은 조밀한 배치 그래프를 만들 수밖에 없습니다. 관계 모델은 입력 박스보다 선택적일 수 없기 때문입니다.
관계 지도 학습이 백본 특징에 남기는 것
하나의 백본이 두 작업을 모두 수행하려면, 관계 지도 학습이 관계를 인코딩하는 특징을 만들어야 합니다. 저자의 탐침(probe) 실험은 그렇지 않다고 말합니다. 미세조정은 백본을 크게 바꾸지만(마지막 레이어에서 사전 학습 모델과의 선형 CKA 0.58 ), 바뀌는 것은 객체 사이가 아니라 객체 내부의 구조였습니다.
주어 패치에서 쿼리해 코사인 유사도를 재면, 미세조정 후 클래스 선택성은 0.242 에서 0.281 로 올랐지만 관계 선택성은 0.133 에서 0.138 로 거의 그대로였습니다. 관계 상대가 같은 클래스의 무관한 객체보다 주어와 더 유사할 확률은 오히려 0.469 에서 0.385 로 떨어졌습니다(우연 수준 0.500 ). 물체가 맞닿는 상호작용 영역은 변했는데(예: 손과 새가 맞닿은 장면에서 손 쪽 패치로 쿼리하면, 미세조정 전에는 사람 전체가, 후에는 손과 새가 부각됨), 그 특징에서 객체 클래스는 0.761 로 검색되었지만 동사 검색은 0.269 로 다수 클래스 우연 수준(0.424 )보다도 낮았습니다. 즉 그 영역은 어떤 물체를 다루는지를 인코딩할 뿐, 그 물체로 무엇을 하고 있는지는 인코딩하지 않았습니다.
관계 로짓은 어디서 오는가
제로샷 타워에서 입력 채널을 하나씩 제거하며 간선별 top-1 정확도가 얼마나 떨어지는지를 측정한 결과입니다(첫 행은 절대 정확도, 나머지는 상대 변화 \% ):
| 제거한 채널 | micro VG150 | micro PSG | micro IndoorVG | macro VG150 | macro PSG | macro IndoorVG |
|---|---|---|---|---|---|---|
| 전체 모델 (절대값) | 57.7 | 43.3 | 57.3 | 35.1 | 31.6 | 38.4 |
| 객체 → 텍스트 경로 | -0.1 | -0.0 | -0.1 | -4.4 | -0.2 | +0.6 |
| 박스 기하 | -16.8 | -23.6 | -6.0 | -36.1 | -33.3 | -29.6 |
| 픽셀 (다른 이미지로 교체) | -57.5 | -68.3 | -44.3 | -87.2 | -91.1 | -85.3 |
| 모든 입력 | -99.3 | -90.5 | -98.5 | -94.3 | -94.4 | -93.0 |
의미 로짓 분산을 정확히 분해하면 쌍 맥락(pair context)이 87 ~ 93\% 를, 주어와 목적어 특징은 0.1\% 와 0.0\% 를 차지했습니다. 주어와 목적어 특징이 술어 어휘를 직접 참조하는 선택적 경로의 게이트는 초기값 0.1 에서 학습 후 0.014 ~ 0.044 로 줄었습니다. micro와 macro의 격차는 앞선 빈도 테이블 결과와 같은 비대칭으로, 사전 지식은 상위 술어를 공급하고 시각 증거는 꼬리에서 기여합니다.
정리하면 관계 지도 학습은 관계 특징을 만들지 않고, 관계 로짓은 객체 정체성에 의존하지 않으며, 객체 레이블은 리더보드 지표를 부풀리지만 전이되지 않는 사전 지식을 제공합니다. 저자는 여기서 공유 백본을 정당화할 공유 표현이 없다고 결론짓습니다. 그 결과 검출기는 관계 모델을 재학습하지 않고 교체할 수 있고, 관계 모델은 검출기의 레이블 분포를 물려받지 않습니다.
분석: 도메인 내 측정은 전이 성능 향상을 약 5배 과대평가한다
이 논문의 또 다른 핵심 발견입니다. 저자는 모든 절제 실험(Ablation Study)을 두 번씩, 즉 코퍼스 자신의 검증 분할(도메인 내)과 한 번도 학습하지 않은 벤치마크(교차 데이터셋)에서 읽었습니다. 각 실험은 변수 하나만 바꾸며, 부록의 잡음 한계 1.3\% 와 비교해 판단합니다.
코퍼스 규모를 두 배로 늘리면 도메인 내에서는 micro 재현율(R@50)이 +15\% , macro 재현율(mR@50)이 +56\% 올랐지만, 교차 데이터셋(VG150, PSG)에서는 각각 +2.5 ~ +3.8\% 와 +9.9 ~ +11.9\% 였습니다. 도메인 내 기울기가 전이 기울기를 약 5\times 과대평가하는 셈입니다. 추가된 이미지가 가르치는 것은 코퍼스의 주석 스타일이고, 도메인 내 분할은 구조상 그 스타일을 공유하기 때문입니다.
두 번째 실험은 부호 자체가 바뀌었습니다. 자동으로 생성된 좌우 관계 과잉분을 학습 혼합에서 빼면, 도메인 내 지표는 모든 에폭에서 개선되었지만(micro +2.0\% , macro +27.0\% ) 교차 데이터셋 macro 재현율은 최대 -5.9\% 떨어졌습니다. 이 변경은 PSG 테스트 56개 술어에 대한 학습 질량을 27.3\% 에서 39.4\% 로 올렸는데도 전이 성능이 떨어졌으므로, 목표 벤치마크 어휘와의 분포 정렬로는 설명되지 않습니다.
여기서 두 가지 실무적 결론이 나옵니다. 데이터 규모 결정은 전이 측정으로 내려야 합니다. 저자는 추가 50만 장 주석의 외삽 이득이 절대값 약 1포인트에 불과해 이를 생성하지 않았습니다. 체크포인트 선택도 마찬가지로, 최고 에폭보다 마지막 에폭으로 실험군의 순위를 매기는 편이 분포 밖 성능을 더 잘 예측했습니다(순위 상관 \rho = 0.77 대 0.66 ).
희소한 주석은 없는 것보다 나쁩니다. 평가 중복을 검수한 Open Images V6 확장분 62,589장을 의도적으로 25\% 관계 비중으로 섞었더니, 모든 축에서 악화되었습니다(개발용 합성 점수 약 -6\% , 최악 셀인 HICO-DET 꼬리 재현율 -40.2\% ). Open Images는 이미지당 관계가 4.33개로 RA-4M(9.03개)의 절반 수준이라, 미표지 쌍이 앞서 설명한 PU 구조에서 거짓 음성으로 학습에 들어갔습니다. 저자는 이 현상이 일어나는 임계점을 정하는 것은 데이터가 아니라 손실 함수라고 설명합니다.
백본 용량도 합성 점수를 올리지 않았습니다. 세 백본(ViT-S/16, ViT-S/16+, ViT-B/16) 사다리를 두 가지 레시피로 학습했을 때, 합성 점수는 모델 크기에 단조롭게 증가하지 않았고, 공개 타워보다 파라미터가 +114\% 많은 가장 큰 타워는 합성 점수를 -0.1\% 바꿨을 뿐입니다. 두 사다리 모두 공간 축에서는 가장 작은 타워가 가장 좋았습니다. 크기를 키우면 박스 기하에 대한 의존은 줄고 픽셀 의존은 늘었지만, 가장 큰 타워의 개별 축 우위는 이미지당 5~7개 간선만 내보내는 배포 작동점에서 사라졌습니다. 그래서 저자는 ViT-S/16+를 공개하고, 다음으로 개선해야 할 구성요소는 검출기라고 결론짓습니다.
추론 비용과 배포
개방형 어휘 장면 그래프 모델은 보통 계산 비용 없이 보고됩니다. 저자는 같은 프로토콜로 베이스라인과 비교했습니다(배치 1, 중앙값 지연 시간, 양쪽 모두 eager PyTorch, 검출기 포함 전체 시스템):
| 시스템 | 파라미터 | 이미지당 박스 | A40 (ms) | A100 (ms) | H100 (ms) | A40 FPS |
|---|---|---|---|---|---|---|
| OvSGTR Swin-T | 177M | 98 | 194.0 | 179.9 | 128.1 | 5.1 |
| OvSGTR Swin-B | 237M | 98 | 228.5 | 195.1 | 134.3 | 4.3 |
| RelateAnything + YOLO-World | 231M | 20 | 25.0 | 35.0 | 25.6 | 40.0 |
RelateAnything 시스템은 Swin-T 베이스라인보다 파라미터가 많은데도 A40에서 전체 7.8\times 빠릅니다(231M 중 관계 모델은 53.2M). 배치 1의 비용은 파라미터 수가 아니라 커널 디스패치가 좌우하기 때문입니다. 베이스라인은 800/1333 해상도, fp32로 98개 박스 사이의 약 9,500개 쌍을 모두 점수 매기고, RelateAnything은 448 px, bf16으로 20개 박스 중 최대 128쌍만 봅니다. 저자는 같은 박스 예산이라면 두 시스템의 차이가 훨씬 줄 것이라고 덧붙입니다.
폐쇄형 실시간 전문 모델인 REACT와 REACT++(각 벤치마크에서 학습)와의 비교에서는, REACT++가 21 ~ 23 ms로 RelateAnything(35 ~ 36 ms, eager 미융합 헤드 기준)보다 빠르고, 두 전문 모델은 학습한 모든 벤치마크에서 micro 재현율이 더 높았습니다. RelateAnything은 PSG를 제외한 모든 곳에서 macro가 더 높았고, F1@K는 세 벤치마크 모두 REACT보다, VG150에서는 REACT++보다 높았으며, IndoorVG에서 0.2 , PSG에서 3.7 낮았습니다. 이 벤치마크들의 주석을 하나도 보지 않고, 임의의 어휘로 답하며, 객체 레이블도 받지 않는 모델의 결과입니다. 해당 벤치마크로 미세조정하면 세 벤치마크 모두에서 표의 최고 micro 재현율을 기록했지만, VG150과 IndoorVG에서는 macro 재현율을 일부 잃었습니다.
배포 구성과 관련된 측정도 세 가지가 있습니다:
-
배치 1에서 관계 헤드는 연산이 아니라 커널 디스패치에 묶입니다. 세 타워 모두 FLOPs 차이가 2.5\times 인데도 A40에서 19~20ms로 비슷했습니다.
-
컴파일이 가장 큰 단일 이득으로, 모든 GPU에서 1.5 ~ 1.8\times 빨라졌습니다. 공개 타워는 검출기와 디코딩까지 포함해 프레임당 20.3 ms(49 FPS, A40), H100에서 18.1 ms입니다. 19,103개 문자열을 50개 대신 점수 매기는 비용은 배치 1에서 1ms 미만입니다.
-
텍스트 인코더가 추론 그래프 밖에 있고 검출기도 모델에 포함되지 않으므로, 같은 그래프가 CPU에서도 돌아갑니다. OpenVINO로 8개 스레드에서 7 FPS이며, fp32와의 top-1 일치율은 95.5\% 입니다.
모델은 술어 뱅크를 입력 텐서로 받는 단일 ONNX 그래프로 내보낼 수 있어서, 재내보내기 없이 임의의 문자열 목록으로 바꿀 수 있습니다. 이 덕분에 브라우저 데모가 WebGPU나 WASM(WebAssembly)으로 사용자 기기에서 직접 추론합니다. 프로젝트 페이지에 따르면 브라우저 WASM 기준으로 관계 헤드가 약 600ms, 검출기가 80~500ms이고, 모델 다운로드는 105MB(검출기는 5~27MB)이며, 두 개의 부동소수점 값만으로 하는 보정(Calibration)으로 ECE가 0.176 에서 0.004 로 줄었습니다.
한계점 및 향후 연구 방향
저자는 논문 곳곳에서 불리한 결과를 함께 보고했고, 한계 절에서도 이를 구체적으로 정리했습니다.
보류된 개념(held-out concepts) 평가가 부족합니다. 표시가 없는 모든 결과는 교차 데이터셋이라 이미지, 객체 분포, 주석 스타일은 처음 보는 것이지만, 술어 문자열은 그렇지 않습니다. 모든 벤치마크 술어가 학습 어휘 안에 있습니다. OvR-SGG 분할에서는 신규 술어를 빼고 재학습해 평가했지만, 네 벤치마크 전반에서 개념을 보류하는 일반적인 실험은 아직 하지 않았습니다. 술어 행렬을 학습하지 않는 구조이므로 이 실험이 가능하다는 점은 저자도 밝히고 있습니다. 또 여러 결론이 시드 하나에 기대고 있어, 잡음 한계 1.3\% 안쪽의 차이는 그렇게 표시했습니다.
코퍼스 정밀도는 구조적 주장에 그칩니다. 게이트가 후보의 11.3\% 를 기각하고, 기각은 박스 오차 범위에서 참 음성이며, 기하가 제약하지 못하는 술어는 이름을 붙여 집계했다는 것까지가 RA-4M의 정밀도에 대해 저자가 말할 수 있는 전부입니다. 사람이 생성 관계의 표본을 읽고 채점한 정밀도 추정치는 없습니다. 저자는 "430만 개의 기계 생성 주석에 의존하기 전에 독자가 기대해야 할 측정이며, 가장 먼저 추가할 측정"이라고 적었습니다.
분리 결과의 범위도 제한적입니다. 이 논문의 관계 지도 학습이 관계적인 밀집 특징을 만들지 않았다는 것이지, 어떤 방법으로도 만들 수 없다는 뜻은 아닙니다. 현재 레시피에는 패치 수준의 관계 목적 함수가 없고, 탐침 결과는 공유 백본에 바로 그런 목적 함수가 필요하다는 것을 시사합니다.
관계별 정밀도는 실제 약점입니다. A5에서 판정자는 관계를 하나씩 볼 때 베이스라인의 관계를 약간 더 많이 받아들였고, 두 번째 판정자도 같은 결과를 냈습니다. 저자는 어느 깊이에서든 베이스라인이 덜 과장하며, 잘못된 간선을 허용할 수 없는 배포에서는 더 짧은 그래프를 선호해야 한다고 인정합니다.
검출기 재현율이 가장 큰 손실입니다. 벤치마크 수치와 실제 배포 시스템 사이의 가장 큰 손실은 객체 검출기 재현율입니다. 쌍 재현율은 객체 재현율의 제곱에 비례하므로 어떤 관계 모델도 이를 넘을 수 없고, 더 큰 관계 모델은 배포에서 내보내지 않는 순위 구간의 정확도만 올립니다.
저자는 비용이 적게 들면서도 이 논문의 결론을 실제로 바꾼 보고 관행들도 권고합니다. 모든 재현율 수치 옆에 코퍼스와 벤치마크의 공유 삼중항 질량을 적을 것, 매처가 일대일 할당을 강제하는지 밝힐 것, 검출기의 임계값과 박스 상한 그리고 그에 따른 쌍 재현율 상한을 적을 것, 재현율이 그래프 제약인지 밝힐 것, 사람이 판정한 음성으로 채점하는 축을 하나 이상 포함할 것입니다. 그중에서도 가장 싼 관행으로 공유 삼중항 질량을 꼽았는데, 이 수치는 모델의 지도 신호 중 얼마가 벤치마크와 같은 종류의 물체에 대해 같은 관계를 주장하는지를 알려줍니다.
객체 검출과 분할이 분류체계를 모델 밖으로 꺼낸 것처럼, RelateAnything은 관계 예측에서도 어휘를 입력으로 옮길 수 있다는 것을 모델, 코퍼스, 벤치마크 세 가지를 모두 공개하며 보여주었습니다. 동시에 이 연구는 장면 그래프 분야가 오랫동안 써 온 재현율 리더보드가 상당 부분 사전 지식 일치 점수였다는 점을 수치로 드러냈고, 저자가 세 장애물 중 측정 문제를 가장 영향이 큰 것으로 꼽은 이유도 여기에 있습니다.
RelateAnything 설치 및 사용 방법
RelateAnything은 Python 3.12 이상에서 동작하며, NVIDIA GPU 추론에는 CUDA 빌드의 PyTorch가 필요합니다(CPU에서는 device="cpu" 로 실행할 수 있습니다). 먼저 저장소를 복제하고 설치합니다:
git clone https://github.com/Maelic/RelateAnything.git
cd RelateAnything
pip install -e ".[hub]"
저장소 루트에서 아래 예제를 실행하면 포함된 예시 사진에서 사람과 말 박스 사이의 관계를 예측합니다. 박스는 원본 이미지 픽셀 기준 [x1, y1, x2, y2] 이며, box_labels 는 출력을 읽기 쉽게 할 뿐 모델 입력으로는 쓰이지 않습니다:
import numpy as np
from PIL import Image
from relsgg import RelateAnything

model = RelateAnything.from_pretrained("maelic/relsgg-vits16plus", device="cuda")
image = Image.open("assets/reel/images/horse.jpg").convert("RGB")
boxes = np.array([[470, 130, 650, 630], [90, 310, 1010, 875]], dtype=np.float32)

for triplet in model.predict(image, boxes, box_labels=["person", "horse"], topk=5):
    print(triplet)

# 재학습 없이 찾을 관계 어휘를 바꿉니다.
model.set_vocabulary(["riding", "carrying a rider", "beside", "in front of"])
graphs = model.predict(image, boxes, box_labels=["person", "horse"], decompose=True)
print(graphs["spatial"])
print(graphs["semantic"])
set_vocabulary() 로 어휘를 바꾸고, decompose=True 로 앞서 설명한 공간 그래프와 의미 그래프를 따로 받을 수 있습니다. 공개 체크포인트에는 백본 설정과 텍스트 인코더가 함께 들어 있어, 추론에는 DINOv3 게이트 로그인이 필요 없습니다. API는 박스 대신 masks= 로 이진 마스크를 넘기는 입력도 지원하며, from_pretrained(..., full_vocabulary=True) 로 불러오면 가중치와 함께 배포된 임베딩을 읽어 19,103개 학습 어휘 전체로 답합니다.
공개된 체크포인트는 세 가지이며, 학습 레시피는 같고 비전 백본만 다릅니다:
| 체크포인트 | 백본 | 파라미터 |
|---|---|---|
relsgg-vits16 |
DINOv3 ViT-S/16 | 46.1M |
relsgg-vits16plus (권장) |
DINOv3 ViT-S/16+ | 53.2M |
relsgg-vitb16 |
DINOv3 ViT-B/16 | 113.8M |
배포 경로는 PyTorch(CPU/CUDA), 공개 ONNX 그래프로 로컬 FP32 엔진을 빌드하는 TensorRT 10, 노트북용 ONNX 또는 OpenVINO, 그리고 설치 없이 쓰는 브라우저 데모가 있습니다. README에 따르면 RTX 3080 Laptop GPU에서 ViT-S/16+ 모델은 TensorRT FP32로 이미지당 17.2ms(배치 1, 관계 35종, 전처리와 전송, 삼중항 디코딩 포함)이고, YOLO26m 검출까지 포함한 전체 파이프라인은 36.5ms입니다. 관계 모델은 영역을 입력받을 뿐 스스로 객체를 검출하지 않으므로, 데모용 검출기는 배포 가이드에 따라 로컬에서 따로 빌드해야 합니다:
# CPU 이미지 데모, --image 를 빼면 웹캠을 사용합니다.
python deploy/demo_webcam.py --dist deploy/dist/relsgg-vits16plus --image photo.jpg

# TensorRT 엔진 두 개를 빌드한 뒤 NVIDIA GPU에서 실행
python deploy/demo_webcam.py --dist deploy/dist/relsgg-vits16plus \
  --backend tensorrt --device cuda --image photo.jpg --decompose
결과를 다른 방법과 비교하거나 채점 경로를 바꾸려면, 저장소의 평가 함정(evaluation pitfalls) 문서와 평가 프로토콜 명세를 먼저 읽어 보기를 권합니다. 저자는 README에서 OV-SGG-Bench 평가 팩을 Hugging Face 데이터셋으로 안내하고 있지만, 2026년 9월 28일 확인 시점에는 해당 페이지가 공개되어 있지 않았습니다. 평가 코드는 저장소의 benchmark/ 디렉토리에 있습니다.
직접 사용할 때 알아 둘 점도 저장소 문서에 정리되어 있습니다. 출력 헤드가 균형 잡힌 사전 분포로 학습되어 원시 점수가 [0.9, 1.0) 구간에 몰리므로, 임계값은 각 체크포인트에 함께 배포된 Platt 보정값과 임계값 파일을 써야 하고 다른 체크포인트로 옮길 수 없습니다. 쌍 연관성 점수는 주석 기반 벤치마크의 재현율은 올리지만 사람이 판정한 음성에서는 참/거짓 판단을 떨어뜨리므로, pair_weight 는 목적에 맞게 골라야 합니다. 또 torch.compile 은 배포용으로만 쓰고, 컴파일한 모델로는 벤치마크하지 않도록 권합니다. 컴파일하면 평가 지표가 잡음 한계의 약 40배만큼 움직이기 때문이며, 논문의 정확도 수치도 모두 컴파일하지 않은 추론으로 얻은 것입니다.
RelateAnything의 라이선스
라이선스는 구성요소마다 다릅니다. 코드는 Apache-2.0이고, 모델 가중치는 Meta DINOv3의 파생물이라 DINOv3 라이선스를 따릅니다. RA-4M의 주석과 마스크는 CC BY-NC 4.0이며 Gemma 이용 약관 고지를 함께 지닙니다. 저장소 README와 데이터 문서에는 이미지를 ID로만 참조한다고 되어 있지만, 현재 Hugging Face 데이터셋 카드에 따르면 원본 JPEG를 비상업 연구용으로 함께 배포하며 이미지는 각 원본 코퍼스(Objects365, Open Images V6, COCO)의 약관을 따릅니다. 데모용 검출기 중 ultralytics 파생 구성요소는 AGPL-3.0이며 관계 모델 배포물에서는 제외되어 있습니다.
 RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs 논문
 RelateAnything 프로젝트 홈페이지
 RelateAnything GitHub 저장소
 RelateAnything 모델 컬렉션 (Hugging Face)
 RA-4M 데이터셋 (Hugging Face)
더 읽어보기
-
DINOv3: 자기 지도 학습(SSL)을 활용한 초대규모의 범용 비전 백본(Vision Backbone) 모델(feat. Meta AI)
-
SAM2: 이미지와 비디오 모두에 적용 가능한 Segment Anything Model (feat. Meta)
-
Meta Segment Anything Model 3 (SAM 3): 프롬프트 기반의 개방형 어휘(Open-Vocabulary) 기반 개념적 분할 모델
-
Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개
-
Qwen3-VL: Alibaba Qwen팀이 공개한 더 선명한 시각, 더 깊은 생각, 더 넓은 행동이 가능한 Multimodal LLM
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
