Sentence Transformers 멀티 벡터 모델 학습 가이드 소개
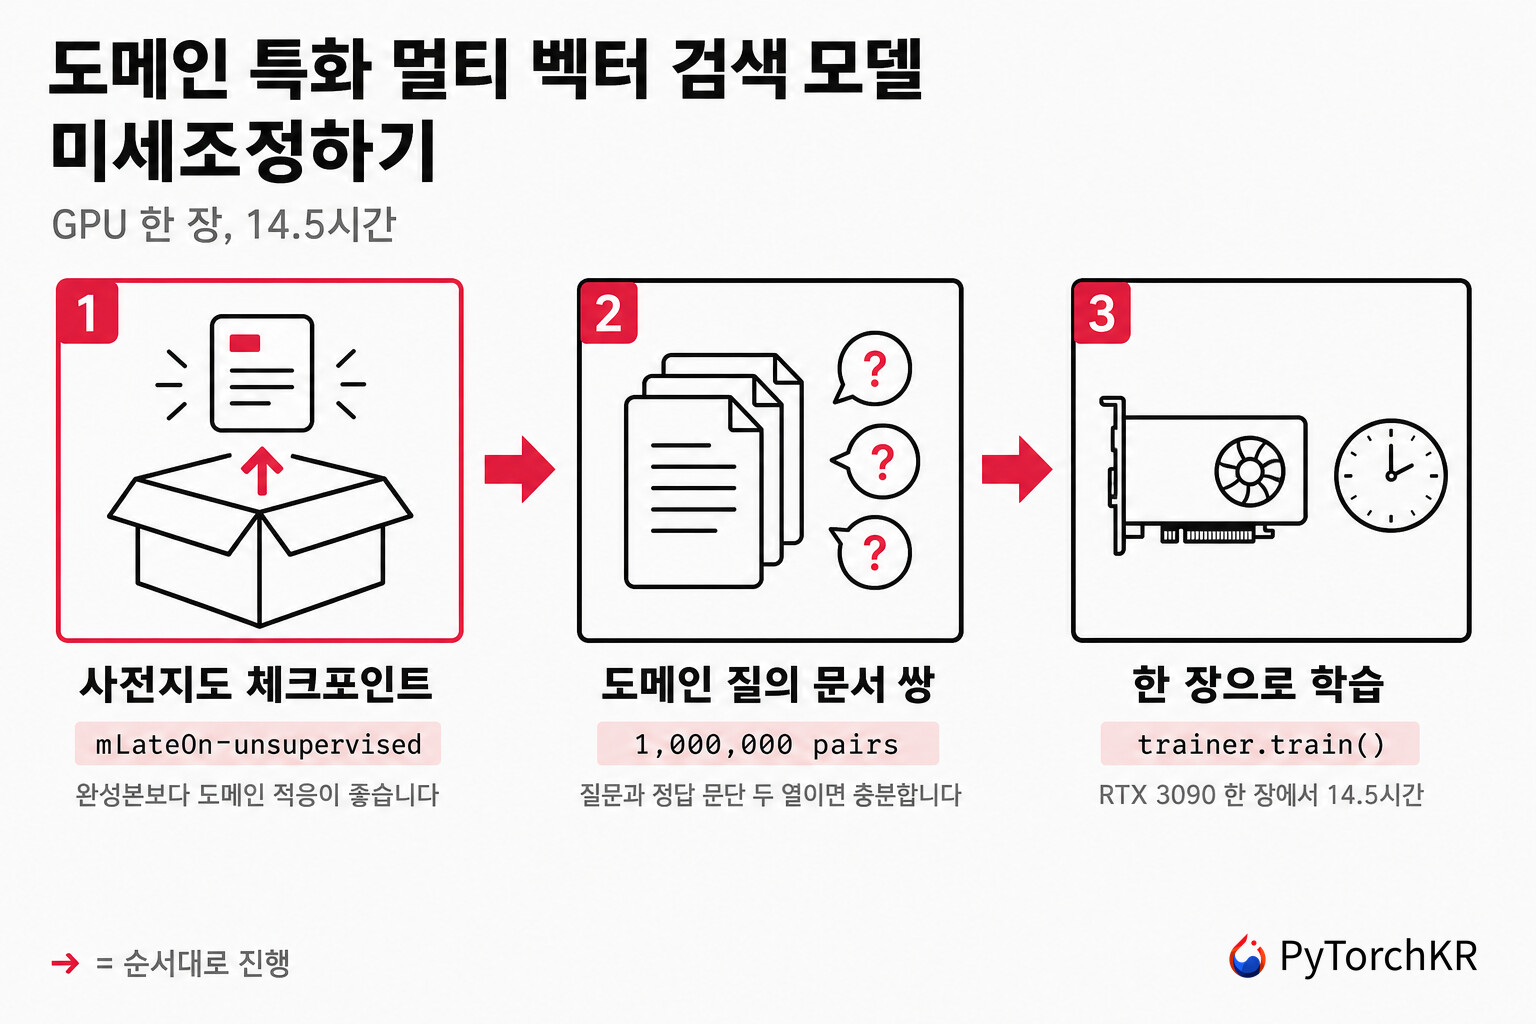
Sentence Transformers는 검색 증강 생성(RAG), 의미 기반 검색(Semantic Search), 의미적 텍스트 유사도(Semantic Textual Similarity) 같은 곳에 쓰이는 임베딩 모델과 재정렬(Reranking) 모델을 쓰고 학습시키는 Python 라이브러리이고, v6.0에서 추가된 MultiVectorEncoder 는 ColBERT 계열의 Late Interaction 검색 모델을 이 라이브러리 안에서 학습까지 할 수 있게 해 줍니다. 이번에 소개할 글은 그 학습 절차를 처음부터 끝까지 정리한 Tom Aarsen의 2026년 8월 26일 Hugging Face 블로그 포스트로, 소비자용 GPU인 RTX 3090 한 장에서 14.5시간을 돌려 만든 의료 검색 모델이 밀집(Dense), 희소(Sparse), 어휘(Lexical), 멀티 벡터를 통틀어 저자가 구할 수 있었던 모든 범용 검색 모델을 앞선 과정을 담고 있습니다.
이 주제가 중요한 이유는 간단합니다. 공개된 검색 모델 대부분은 웹 검색 분포에 맞춰져 있습니다. 어휘도, 질의를 쓰는 방식도, 무엇이 관련 있는 문서인가 라는 기준 자체도 웹 검색과 법률 문서 검토, 코드 검색, 과학 문헌 조사에서 각각 다릅니다. 게다가 널리 쓰이는 체크포인트들은 짧은 문단을 전제로 설정되어 있어서, 문서가 길면 점수를 매기기도 전에 대부분을 잘라 버립니다. 그런데 의료, 법률, 금융, 사내 문서처럼 구체적인 도메인마다 공식 모델이 나오는 일은 없습니다. 원문은 그 공백을 직접 메우는 방법을 다룹니다.
원문 저자는 같은 시기에 멀티 벡터 모델을 쓰는 방법을 다룬 컴패니언 글을 따로 썼고, 그쪽은 PyTorchKR에도 이미 정리되어 있습니다. 모델을 불러와 인코딩하고 벡터 데이터베이스에 색인하는 이야기가 필요하다면 그 글을 먼저 보는 편이 좋습니다. 아래 정리는 학습 쪽만 다루므로, 구조와 점수 계산은 짧게 복습만 하고 넘어갑니다.

 멀티 벡터 모델을 쓰는 방법은 다음 글(Sentence Transformers v6.0, ColBERT 스타일 멀티 벡터 검색을 표준 API로)을 참고해주세요:
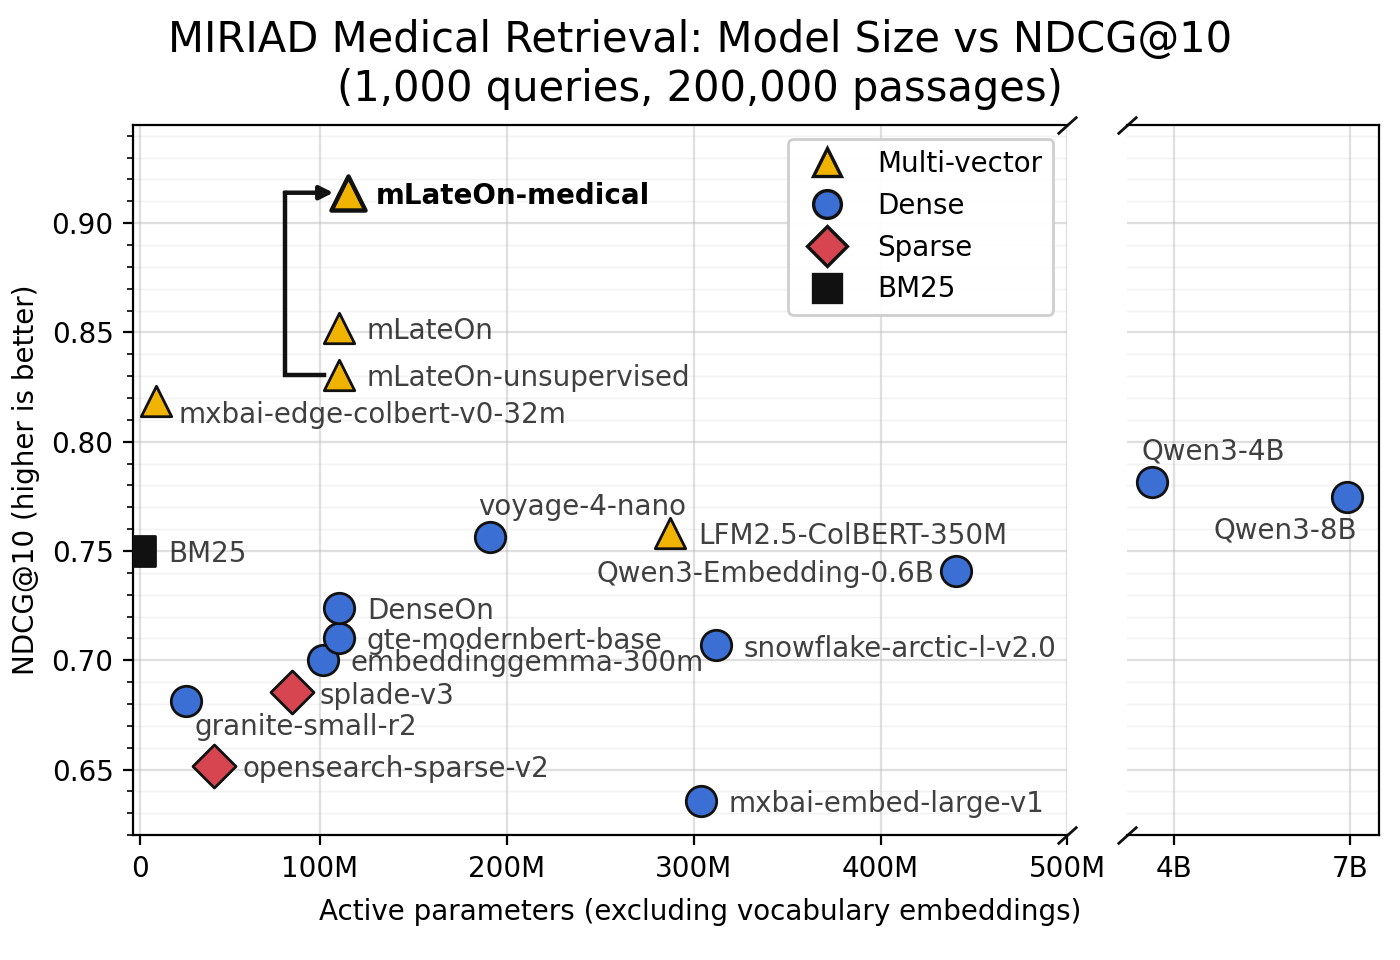
아래 그래프가 이 글의 결론을 한 장으로 보여줍니다. 가로축은 활성 파라미터 수, 세로축은 의료 검색 평가의 NDCG@10입니다. NDCG(Normalized Discounted Cumulative Gain)는 정답 문서가 검색 결과의 얼마나 앞쪽에 놓였는지를 0에서 1 사이 값으로 재는 검색 품질 지표이고, 뒤에 붙은 10은 상위 10건까지만 본다는 조건을 가리킵니다. 그래프에서 저자가 학습한 mLateOn-medical 이 훨씬 큰 범용 모델들을 제치고 맨 위에 있습니다.
여기서 다루는 방법은 기존 모델을 자기 데이터에 맞추는 미세조정뿐 아니라, 강한 멀티 벡터 모델을 처음부터 학습시키는 데에도 그대로 쓸 수 있습니다. 아래 내용은 모두 pip install -U "sentence-transformers[train]" 만으로 돌아갑니다.
토큰마다 벡터를 남기는 멀티 벡터 모델, 짧게 다시 보기
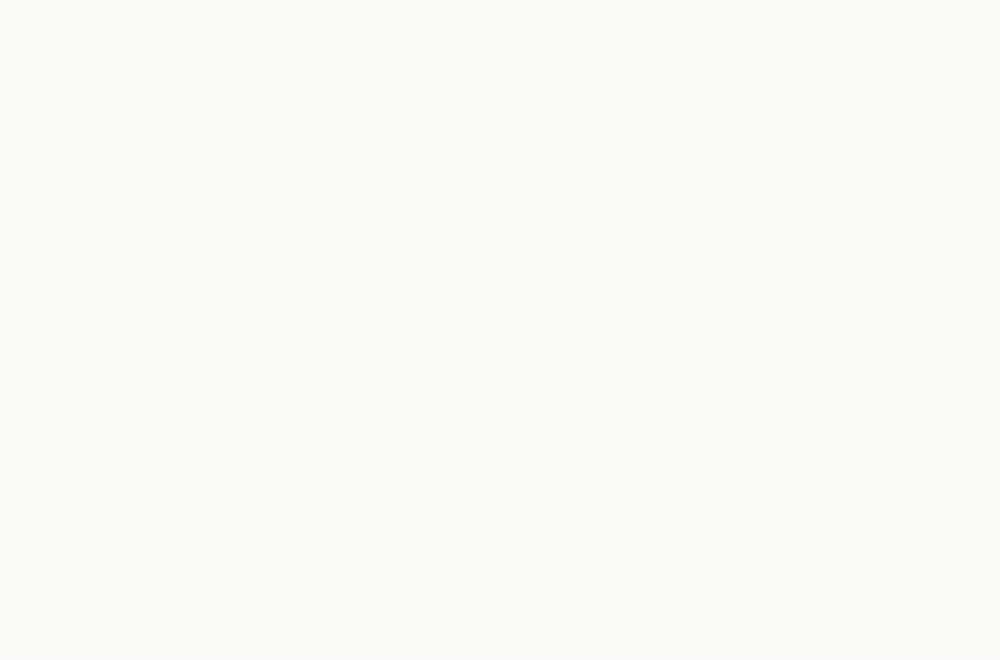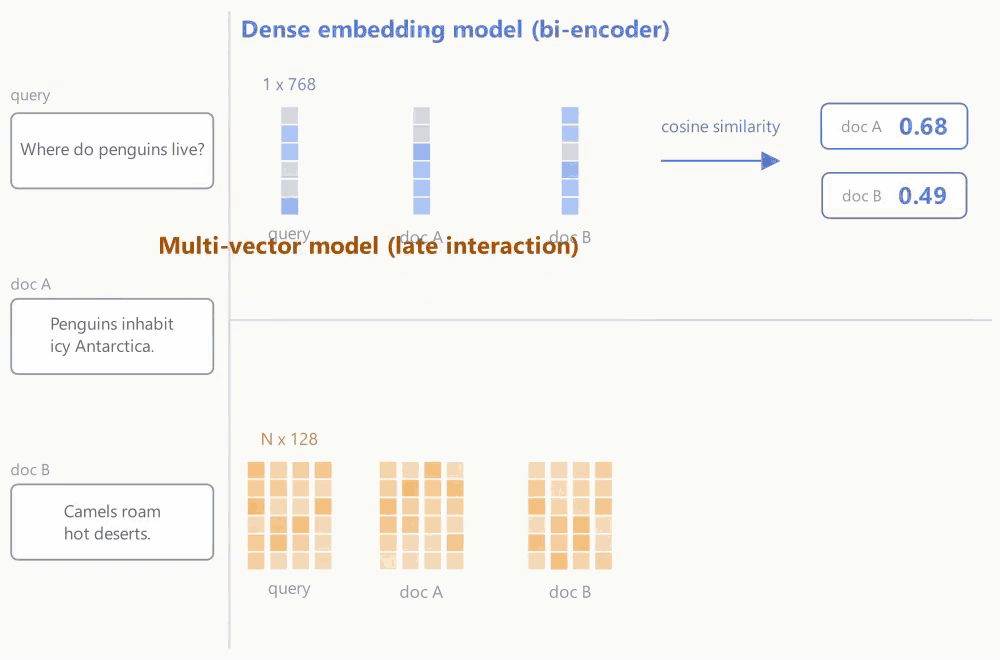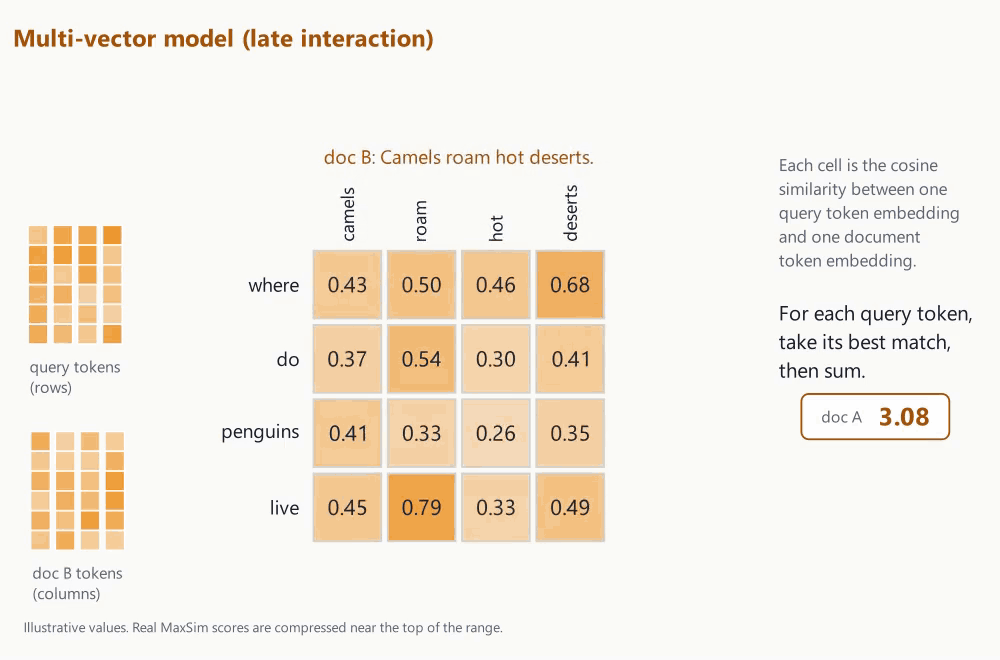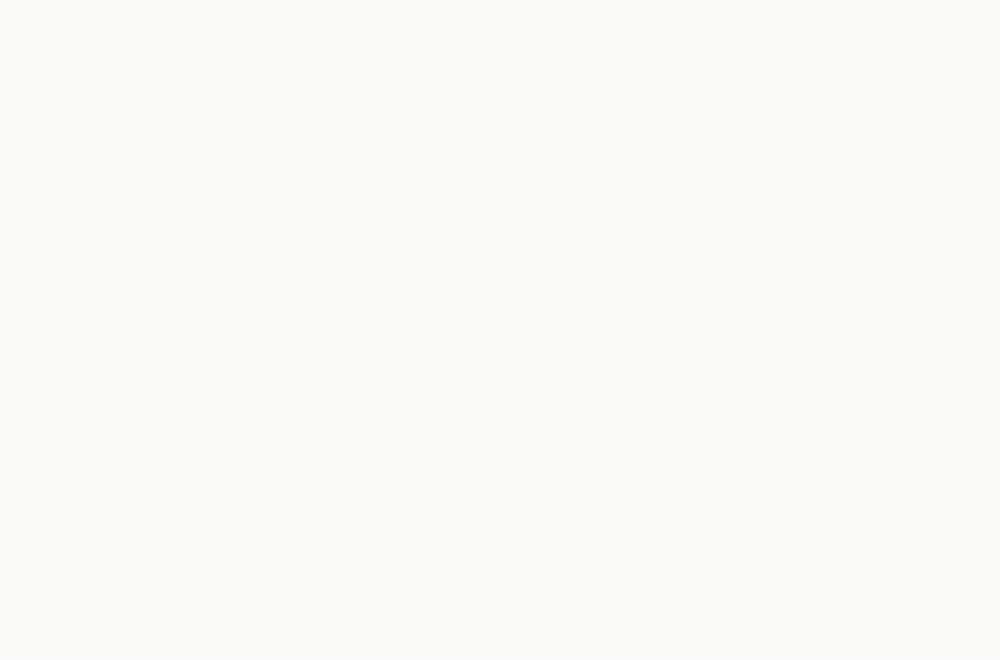
밀집 임베딩 모델은 텍스트 하나를 벡터 하나로 압축하고, 유사도는 그렇게 만들어진 두 요약 사이의 내적 한 번으로 결정됩니다. 멀티 벡터 모델(Multi-Vector Model) 은 그 압축 단계를 건너뜁니다. 토큰마다 작은 벡터 하나를 그대로 남긴 뒤, MaxSim 연산자로 질의와 문서의 점수를 계산합니다. 질의 토큰 각각이 자기와 가장 잘 맞는 문서 토큰을 찾고, 그 점수를 전부 더하는 방식입니다.
벡터 하나로 평균 내면서 사라지던 토큰 단위 대응 정보가 보존되므로 검색 품질이 올라가고, 그 대가로 색인(Index)이 커집니다. 상호작용을 점수 계산 시점까지 미룬다는 뜻에서 Late Interaction이라고 부르고, 2020년 ColBERT 논문에서 출발했기 때문에 ColBERT 스타일 모델이라고도 합니다. 아래에서는 세 이름을 하나로 읽으면 됩니다.
왜 직접 학습해야 하는가: 180 토큰에서 잘려 나가는 문서들
미세조정(Fine-tuning)이 멀티 벡터 모델에서 특히 효과가 큰 이유는 점수 계산 방식 자체에 있습니다. 질의와 문서를 토큰 단위로 맞춰 보기 때문에, 단일 벡터 모델이 평균 내며 흘려보내는 도메인 고유의 세밀한 신호를 집어냅니다. 그래서 도메인 학습 데이터가 아주 많지 않아도 성능이 잘 올라갑니다.
여기에 더 실질적인 문제가 하나 있습니다. 공개된 검색 모델 대부분은 짧은 문단을 전제로 설정되어 있습니다. 고전적인 ColBERT 체크포인트는 문서를 180 토큰이나 300 토큰에서 자르고, 인기 있는 밀집 모델 상당수도 256 토큰이나 512 토큰에서 자릅니다. MS MARCO 계열 학습 데이터에 그보다 긴 문서가 거의 없기 때문입니다. 문서가 길면 이 모델들은 점수를 매기기 전에 문서 대부분을 조용히 버립니다. 저자의 의료 평가에서 문단 길이는 평균 941 토큰이었고, 이 절단(Truncation)이 최대 0.24 NDCG@10까지 손해를 냈습니다. 모델 구조 사이의 어떤 차이보다도 큰 폭입니다. 직접 학습하면 이 값을 남이 정해 둔 상한이 아니라 자기 데이터가 요구하는 길이로 설정할 수 있습니다.
같은 상황을 LightOn도 코드 검색에서 겪었습니다. 범용 LateOn으로는 부족해서 LateOn-Code를 따로 학습시켰습니다. 자기 도메인 전용 공식 모델이 나오기를 기다리는 대신 직접 만드는 쪽이 현실적이라는 이야기입니다.
한국어 문서를 다루는 입장에서는 여기서 선택지를 한 번 더 따져 볼 필요가 있습니다. 한국어를 지원 언어로 명시한 멀티 벡터 체크포인트가 없지는 않습니다. 아래 평가에도 등장하는 jina-colbert-v2는 모델 카드에 94개 언어를 적어 두었고, LFM2.5-ColBERT-350M은 11개 언어 목록에 일본어와 한국어를 포함합니다. 그런데 라이선스를 함께 보면 사정이 달라집니다. jina-colbert-v2는 CC BY-NC 4.0이라 상업적 사용이 막혀 있고, LFM2.5-ColBERT-350M은 lfm1.0 이라는 자체 라이선스를 씁니다. 아래 의료 평가에서 두 모델의 점수도 각각 0.6218(문서 길이 상한을 1,024 토큰까지 푼 조건)과 0.7582로, 한국어가 목록에 없는 mLateOn의 0.8520보다 한참 아래입니다. 영어 의료 검색 기준이라 한국어 성능을 그대로 말해 주지는 않지만, 지원 언어 목록에 한국어가 적혀 있다는 사실이 곧 강한 출발점이라는 뜻은 아니라는 정도는 보여 줍니다.
반대로 이 글이 출발점으로 권하는 mLateOn 계열은 Apache 2.0인데, 모델 카드가 명시한 지원 언어는 영어, 프랑스어, 독일어, 이탈리아어, 스페인어, 포르투갈어, 스웨덴어, 노르웨이어, 아랍어, 코드 열 가지이고 한국어는 목록에 없습니다. 다만 그 백본인 jhu-clsp/mmBERT-base는 카드에 1,811개 언어를 적어 두었고 여기에 한국어(kor)가 포함됩니다. 사전학습 단계에서 한국어를 본 백본 위에 도메인 데이터로 투사층과 검색 능력을 얹는 경로가 열려 있다는 뜻이므로, 한국어 도메인이라면 지원 언어 목록만 보고 고르기보다 라이선스와 백본의 사전학습 범위까지 놓고 후보를 추리는 편이 낫습니다. 한국어 임베딩 모델 전반의 현황은 ko-embedding-leaderboard에 정리되어 있습니다.
학습을 이루는 6가지 구성요소
MultiVectorEncoder 학습은 여섯 조각으로 나뉩니다. 아래에서 하나씩 살펴봅니다.
| 구성요소 | 역할 | 필수 여부 |
|---|---|---|
| Model | 미세조정할 모델 또는 새로 조립할 구조 | 필수 |
| Dataset | 학습과 평가에 쓰는 데이터 | 필수 |
| Loss Function | 성능을 수치화해 최적화를 이끄는 함수 | 필수 |
| Training Arguments | 학습 속도, 추적, 디버깅에 영향을 주는 인자 | 선택 |
| Evaluator | 학습 전후와 도중에 모델을 평가하는 클래스 | 선택 |
| Trainer | 위 요소를 모두 묶어 실행 | 필수 |
어디서 출발할 것인가: 완성된 체크포인트보다 -unsupervised가 낫습니다
멀티 벡터 학습에서는 출발점을 고를 여지가 실제로 있고, 그 선택이 생각보다 결과를 많이 바꿉니다.
기존 멀티 벡터 모델을 이어서 학습하기
이미 있는 멀티 벡터 모델을 이어서 학습한다면 구조는 신경 쓸 필요가 없습니다.
from sentence_transformers import MultiVectorEncoder

# Loading in fp32 is preferred for training if your memory can handle it
model = MultiVectorEncoder(
    "lightonai/mLateOn-unsupervised",
    model_kwargs={"torch_dtype": "float32"},
    processor_kwargs={"model_max_length": 8192},  # the tokenizer-level token limit
)
체크포인트는 자기 레시피를 같이 가지고 옵니다. 질의와 문서를 구분하는 마커 토큰, 투사층(Projection), 점수 계산에서 제외할 토큰 목록이 모두 딸려 옵니다. 미세조정에서는 대체로 그것들을 그대로 두고 데이터가 요구하는 부분만 바꿉니다. 가장 먼저 확인할 것은 길이 설정입니다. 앞서 본 것처럼 공개 체크포인트 상당수가 문서를 180 토큰에서 512 토큰 사이로 제한하는데, 저자의 의료 문단은 1,400 토큰까지 갑니다. mLateOn 계열은 이미 백본의 8,192 토큰 컨텍스트를 그대로 쓰지만, 출발 체크포인트에 제한이 걸려 있다면 풀어 줍니다.
# Let the model read full documents instead of the caps it was trained with,
# e.g. GTE-ModernColBERT-v1 ships with query_length=48 and document_length=300
model[0].query_length = None
model[0].document_length = None
작업별 제한을 풀면 절단 기준이 토크나이저의 model_max_length 로 넘어가고, 그래서 위에서 모델을 불러올 때 그 값을 지정해 둔 것입니다.
저자는 여기에 한 가지를 더 바꿨습니다. 문장 부호 토큰을 문서 쪽 점수 계산과 저장에서 빼는 스킵리스트(Skiplist)를 넣었습니다. 아무것도 넣지 않은 경우, 문장 부호만 뺀 경우, 불용어(Stopwords)만 뺀 경우, 둘 다 뺀 경우를 비교한 4방향 실험에서 문장 부호만 뺀 설정이 품질에서 근소하게 앞섰고, 덤으로 이 데이터에서 문서 색인이 9.6% 작아졌습니다.
import string

# model[2] is the MultiVectorMask module
model[2].skiplist_words = list(string.punctuation)
model[2].resolve_with_tokenizer(model.tokenizer)  # token ids are cached, so re-resolve after changing
위 주석의
model[2]는 바로 아래에서 볼 ModernBERT 예시처럼 모듈이 네 개인 구성에 해당하는 인덱스입니다. mLateOn 계열은Dense모듈이 세 개라MultiVectorMask가 인덱스 4에 놓입니다. 실제로 저자가 공개한 mLateOn-medical 모델 카드의 모듈 목록도(4): MultiVectorMask(...)로 저장되어 있습니다. 체크포인트마다 다르므로print(model)로 모듈 순서를 확인한 뒤 인덱스를 지정하는 편이 안전합니다.
일반 트랜스포머에서 새로 조립하기
MultiVectorEncoder 에 아무 베이스 트랜스포머나 지정하면, 무작위로 초기화된 토큰 단위 투사층이 뒤에 자동으로 추가됩니다.
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("answerdotai/ModernBERT-base", model_kwargs={"torch_dtype": "float32"})
# MultiVectorEncoder(
#   (0): Transformer({..., 'architecture': 'ModernBertModel'})
#   (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
#   (2): MultiVectorMask({'skiplist_words': [], 'skiplist_tasks': ['document'], ...})
#   (3): Normalize({...})
# )
고전적인 ColBERT 파이프라인이 그대로 보입니다. 문맥을 반영한 토큰 임베딩을 만드는 Transformer, 각 토큰을 128차원으로 낮추는 토큰 단위 Dense, 점수 계산에 어떤 토큰을 셀지 정하는 MultiVectorMask, 그리고 토큰 단위 Normalize 입니다. 투사층이 무작위 상태에서 시작하므로 학습을 거치기 전에는 쓸 수 없습니다.
흥미로운 점은 강한 밀집 임베딩 백본에서도 이 방식이 통한다는 것입니다. Alibaba-NLP/gte-modernbert-base 위에 새 투사층을 얹은 구성이, 투사층과 학습 쌍 25,000개만으로 기존 체크포인트에서 출발한 경우와 0.03 이내까지 따라붙었습니다.
[MASK] 질의 확장, [Q]와 [D] 접두 토큰, 문서 길이 상한, 문장 부호 스킵리스트 같은 고전적인 ColBERT 토큰화 기법은 모두 기본값이 꺼짐이고 필요하면 켤 수 있습니다. 전체 목록은 Creating Custom Models 문서에 있습니다. 참고로 저자는 도메인 미세조정에서 [MASK] 질의 확장을 네 가지 설정으로 시험해 봤지만 측정 가능한 차이를 만든 설정이 하나도 없었다고 적었습니다.
6개 출발점을 같은 레시피로 비교한 결과
저자는 이 글을 준비하면서 출발점 여섯 개를 같은 레시피로 학습시켜 직접 비교했습니다. MIRIAD에서 뽑은 의료 질문과 문단 쌍 25,000개로 학습한 뒤, 따로 떼어 둔 질문 1,000개를 문단 50,000개짜리 말뭉치(Corpus)에서 검색하게 하고 점수를 쟀습니다.
| 출발점 | 학습 전 NDCG@10 | 25,000쌍 학습 후 | 변화 |
|---|---|---|---|
| lightonai/mLateOn-unsupervised | 0.9087 | 0.9398 | +0.0311 |
| lightonai/mLateOn | 0.9277 | 0.9319 | +0.0042 |
| lightonai/LateOn-unsupervised | 0.9026 | 0.9206 | +0.0180 |
| lightonai/LateOn | 0.9185 | 0.9105 | -0.0080 |
| lightonai/GTE-ModernColBERT-v1 | 0.9198 | 0.9007 | -0.0191 |
| gte-modernbert-base에 새 투사층 | - | 0.9177 | - |
위 표를 통해 두 가지를 알아볼 수 있습니다. 첫째, -unsupervised 체크포인트는 학습 전 점수가 더 낮은데도 학습 후에는 완성된 형제 모델을 앞질렀고, 이 결과가 두 모델 계열에서 똑같이 재현됐습니다. 이 체크포인트들은 대규모 대조 학습(Contrastive Pretraining)까지는 마쳤지만 범용 검색에 대한 지도 미세조정은 거치지 않은 상태라, Late Interaction 구조는 갖추고 있으면서, 도메인 학습이 되돌려야 할 범용 검색용 튜닝은 아직 적용되지 않았습니다. 둘째, 완성된 체크포인트들은 거의 움직이지 않거나 오히려 점수가 떨어졌고, 저자가 시도한 모든 학습률에서 그랬습니다.
그래서 마음에 드는 모델 계열이 지도 미세조정 이전 체크포인트를 공개하고 있다면 거기서 출발하는 것이 좋고, 없다면 검색용으로 사전학습된 강한 백본 위에 새 투사층을 얹는 쪽이 근소한 차이의 차선입니다. 가장 자연스러워 보이는 선택인 완성된 체크포인트 이어 학습이 도메인 적응에서는 가장 약했습니다.
데이터셋: 질의와 정답 문단 두 열이면 충분합니다
MultiVectorEncoderTrainer는 학습과 평가에 datasets.Dataset이나 datasets.DatasetDict를 씁니다. Hugging Face Datasets Hub에서 불러와도 되고 CSV, JSON, Parquet, Arrow, SQL 같은 로컬 파일을 써도 됩니다. Sentence Transformers와 바로 맞물리는 공개 데이터셋에는 sentence-transformers 태그가 붙어 있어서 태그 페이지에서 찾아볼 수 있습니다.
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train")

print(train_dataset)
"""
Dataset({
    features: ['question', 'passage_text'],
    num_rows: 4467542
})
"""
이 글에서 쓰는 데이터셋이 바로 이것입니다. MIRIAD에서 가져온 의료 질문 440만 개가, 각각 그 답이 들어 있는 원본 문단과 짝지어져 있습니다. 문단 평균 길이는 941 토큰입니다. 이렇게 단순한 (질의, 관련 문단) 쌍은 자기 도메인에서 모으기 가장 쉬운 형태의 검색 학습 데이터이고, 아래에서 보듯 이것만으로 충분합니다.
로컬 파일은 형식 이름을 첫 인자로 넘겨 같은 함수로 읽습니다.
from datasets import load_dataset

dataset = load_dataset("csv", data_files="my_file.csv")
# or
dataset = load_dataset("json", data_files="my_file.json")
로컬 데이터를 전처리해서 넣어야 한다면 datasets.Dataset.from_dict로 리스트를 넘기면 됩니다.
from datasets import Dataset

queries = []
documents = []
# Open a file, perform preprocessing, filtering, cleaning, etc.
# and append to the lists

dataset = Dataset.from_dict({
    "query": queries,
    "document": documents,
})
데이터셋 형식은 손실 함수와 맞아야 합니다
데이터셋의 열 구성이 손실 함수가 요구하는 입력과 맞는지 확인하는 절차는 두 단계입니다. 먼저 Loss Overview 표에서 그 손실 함수가 Label 을 요구한다면, 데이터셋에 label 또는 score 라는 이름의 열이 있어야 하고 그 열이 자동으로 정답으로 쓰입니다. 그 두 이름이 아닌 나머지 열은 전부 Inputs 로 취급되며, 남은 열의 개수가 손실 함수가 받는 입력 개수와 맞아야 합니다. 열 이름은 상관없고 순서만 의미가 있습니다.
여기에 멀티 벡터에만 있는 규칙이 두 가지 더 있습니다.
- 위치로 정해지는 질의와 문서 배정: 열 이름과 무관하게 첫 번째 열이 질의로, 그 뒤의 모든 열이 문서로 인코딩됩니다. 열마다 다르게 지정하고 싶으면
router_mapping학습 인자로 덮어쓸 수 있습니다. - 지식 증류(Knowledge Distillation) 형식: 후보 문서 하나당 열 하나를 두어
(query, document_1, ..., document_N, scores)형태로 만들고,scores에는 행마다 교사 모델의 점수 N개를 리스트로 넣습니다. 질의와 문서를 텍스트가 아닌 ID로 저장하고 본문은 별도 데이터셋에 둔 lightonai/ms-marco-en-bge 같은 경우에는resolve_ids로 ID를 즉석에서 텍스트로 바꿔 줄 수 있습니다.
손실 함수: 배치 내 부정 예제와 GradCache
질문과 답변, 질문과 문단 쌍이라는 흔한 경우에 주력이 되는 것은 배치 내 부정 예제(In-batch Negatives) 학습입니다. MultiVectorMultipleNegativesRankingLoss는 배치 안의 다른 모든 문서를 각 질의에 대한 오답으로 씁니다. 배치가 클수록 오답이 많아지고 학습이 강해지므로, 실제로는 GPU에 올라가는 크기와 실질 배치 크기를 분리해 주는 GradCache 변형 CachedMultiVectorMultipleNegativesRankingLoss를 쓰게 됩니다.
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

model = MultiVectorEncoder("lightonai/mLateOn-unsupervised", model_kwargs={"torch_dtype": "float32"})

loss = CachedMultiVectorMultipleNegativesRankingLoss(
    model=model,
    mini_batch_size=16,  # how many documents to encode per chunk: bounds memory, not quality
)
mini_batch_size 는 문서를 이 크기의 덩어리로 나눠 인코딩해서 메모리 사용량의 상한을 잡아 줄 뿐이고, 실질 대조 배치 크기는 자유롭게 고를 수 있습니다. 저자의 학습에서는 128이었고, 실험상 그보다 키워도 더 얻는 것은 없었습니다. GradCache는 덩어리 크기와 무관하게 동일한 결과를 보장하므로, GPU가 작으면 이 값만 낮추면 되고 대가는 벽시계 시간뿐입니다. 문서 길이 편차가 크다면 개수 대신 토큰 예산으로 덩어리를 채우는 형제 인자 mini_batch_num_tokens 를 쓸 수 있습니다. 유난히 긴 문서가 몰린 덩어리 때문에 메모리 사용량이 급증하는 일을 막아 줍니다. 저자 기준으로 문서당 약 940 토큰에서 mini_batch_size=16 은 mini_batch_num_tokens=15_000 에 해당합니다.
멀티 벡터에만 있는 함정이 하나 있습니다. 대조 손실 함수들의 scale 기본값이 1.0인데, 밀집 임베딩 쪽 대응 함수는 20.0입니다. 밀집 쪽에서 20.0이 필요한 이유는 코사인 유사도가 [-1, 1] 범위의 값 하나여서 소프트맥스를 날카롭게 만들기에는 폭이 너무 좁기 때문입니다. 반면 MaxSim 점수는 질의 토큰마다 최적 대응 유사도를 하나씩 더한 값이라 이미 대략 [0, |Q|] 범위를 가집니다. 토큰 32개짜리 질의는 최대 32점까지 나옵니다. 그러니 밀집 학습 스크립트에서 scale=20.0 을 그대로 복사해 오면 안 됩니다. 소프트맥스가 포화되어 그래디언트가 죽습니다.
더 강한 교사 모델에서 증류하는 방식은 범용 Late Interaction 모델 중 가장 강한 것들이 실제로 쓰는 방법입니다. MultiVectorDistillKLDivLoss와 Training Overview 문서의 Knowledge Distillation 탭을 참고하면 됩니다.
학습 인자: max_length를 비워 두는 이유
학습 과정은 MultiVectorEncoderTrainingArguments 클래스로 조정합니다. 학습 속도에 영향을 주는 인자와 학습 중 무슨 일이 일어나는지 파악하는 데 쓰는 인자가 함께 들어 있고, 저자는 Training Overview의 Training Arguments 절을 한 번 읽어 볼 것을 권합니다. 아래는 저자가 실제 학습에서 쓴 값입니다.
from sentence_transformers import MultiVectorEncoderTrainingArguments
from sentence_transformers.base.sampler import BatchSamplers

args = MultiVectorEncoderTrainingArguments(
    # Required parameter:
    output_dir="models/mLateOn-medical",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=128,  # the effective contrastive batch, thanks to GradCache
    per_device_eval_batch_size=16,
    learning_rate=1e-4,
    warmup_steps=0.05,
    prompts={"question": "[Q] ", "passage_text": "[D] "},  # the checkpoint's markers, keyed by training column
    fp16=False,  # Set to True if you have a GPU that supports FP16
    bf16=True,  # Set to True if you have a GPU that supports BF16
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # in-batch negatives benefit from no duplicates
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.05,
    logging_steps=0.01,
    run_name="mLateOn-medical",  # Will be used in e.g. Trackio, W&B, etc.
)
세 가지는 설명이 필요합니다.
prompts: 학습은 모델에 저장된 프롬프트를 자동으로 적용하지 않습니다. 그래서 학습에 쓰는 열 이름에 직접 대응시켜 줘야 합니다. 여기서는 체크포인트의 [Q] 마커를 질문 열에, [D] 마커를 문단 열에 대응시켜 학습과 추론(Inference)의 조건을 맞췄습니다.
max_length(일부러 지정하지 않음): 이 인자는 학습 시점에만 토큰화를 자릅니다. 모델이 실제 서빙에서 쓰는 길이보다 싸게 학습하고 싶을 때 쓰는 인자입니다. 저자는 그 지름길의 비용을 직접 쟀습니다. 512 토큰으로 학습하면 속도는 약 2배가 되지만 NDCG@10이 약 0.015 떨어졌고, 데이터를 늘려도 그 격차가 줄지 않았습니다. 잘려 나간 부분을 모델이 아예 본 적이 없기 때문입니다. 속도가 품질보다 급한 상황이 아니라면 지정하지 않고 두어 학습과 추론을 맞추는 편이 낫습니다.
learning_rate=1e-4: 5e-6에서 2e-4까지 훑어본 결과, 통상적인 값보다 높은 이 학습률이 가장 좋았습니다.
평가기: 점수가 포화되면 방해 문단을 넣습니다
학습 중 성능을 보려면 eval_dataset 을 넘겨 평가 손실을 볼 수도 있지만, 실제 검색 지표가 훨씬 많은 것을 알려줍니다. Sentence Transformers는 멀티 벡터 모델용 평가기를 다섯 가지 제공합니다.
| 평가기 | 필요한 데이터 |
|---|---|
MultiVectorInformationRetrievalEvaluator |
질의, 말뭉치, 관련 문서 매핑 |
MultiVectorNanoBEIREvaluator |
필요 없음 |
MultiVectorTripletEvaluator |
(anchor, positive, negative) 삼중항 |
MultiVectorRerankingEvaluator |
{'query': '...', 'positive': [...], 'negative': [...]} 딕셔너리 목록 |
MultiVectorDistillationEvaluator |
질의, 후보 문서, 교사 점수 |
도메인 미세조정에서 의미가 있는 것은 자기 데이터에서 떼어 낸 평가 집합으로 만든 MultiVectorInformationRetrievalEvaluator 입니다. 만들 때 한 가지 요령이 있는데, 말뭉치가 모델을 구분할 수 있을 만큼 어려워야 한다는 점입니다. MIRIAD의 질문은 자기 원본 문단에서 생성된 것이라 검색이 유난히 쉽습니다. 정답 문단 10,000개만 놓고 재면 거의 모든 모델이 0.97 NDCG@10을 넘겼습니다. 이렇게 점수가 포화되면 점수가 벌어질 때까지 방해 문단(Distractor) 을 채워 넣습니다. 저자는 학습 분할에서 중복을 제거한 문단을 방해 문단으로 썼습니다.
from datasets import load_dataset
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator

dataset = load_dataset("tomaarsen/miriad-4.4M-split")

# Gold: 1,000 evaluation questions, each mapping to its own passage, with the
# eval split's full ~10k unique passages as the initial corpus
corpus = {}
queries = {}
relevant_docs = {}
passage_to_id = {}
for idx, row in enumerate(dataset["eval"]):
    if row["passage_text"] not in passage_to_id:
        passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
        corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
    if idx < 1_000:
        queries[f"q{idx}"] = row["question"]
        relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}

# Distractors: unique train passages that make the haystack realistic
seen = set(passage_to_id)
for row in dataset["train"]:
    if len(corpus) >= 200_000:
        break
    if row["passage_text"] not in seen:
        seen.add(row["passage_text"])
        corpus[f"d{len(corpus)}"] = row["passage_text"]

evaluator = MultiVectorInformationRetrievalEvaluator(
    queries=queries,
    corpus=corpus,
    relevant_docs=relevant_docs,
    name="miriad-dev",
    batch_size=16,
)
# results = evaluator(model)
전체 학습 스크립트
앞의 조각들이 MultiVectorEncoderTrainer에서 하나로 묶입니다. 아래가 multi-vector-encoder/mLateOn-medical을 실제로 학습시킨 스크립트 전체입니다.
import logging
import string
import traceback

from datasets import load_dataset

from sentence_transformers import (
    MultiVectorEncoder,
    MultiVectorEncoderModelCardData,
    MultiVectorEncoderTrainer,
    MultiVectorEncoderTrainingArguments,
)
from sentence_transformers.base.sampler import BatchSamplers
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

logging.basicConfig(format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO)

def main():
    # 1. Load the starting checkpoint: contrastively pretrained, not yet supervised
    # Loading in fp32 is preferred for training if your memory can handle it
    model = MultiVectorEncoder(
        "lightonai/mLateOn-unsupervised",
        model_kwargs={"torch_dtype": "float32"},
        processor_kwargs={"model_max_length": 8192},
        model_card_data=MultiVectorEncoderModelCardData(
            language="en",
            license="apache-2.0",
            model_name="mLateOn finetuned on MIRIAD medical retrieval",
        ),
    )

    # 2. Lift the per-task length caps so training and inference see full medical passages
    model[0].query_length = None
    model[0].document_length = None

    # 3. Skip punctuation tokens during scoring: a small quality win and a 9.6% smaller index
    model[2].skiplist_words = list(string.punctuation)
    model[2].resolve_with_tokenizer(model.tokenizer)

    # 4. Load 1 million medical question-passage pairs
    train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train").select(range(1_000_000))

    # 5. In-batch negatives with GradCache: large effective batch, memory-bounded chunks
    loss = CachedMultiVectorMultipleNegativesRankingLoss(model=model, mini_batch_size=16)

    # 6. A light dev evaluator to watch progress during training: 500 held-out questions
    # against the eval split's ~10k unique passages. The full 200k protocol runs afterwards.
    eval_split = load_dataset("tomaarsen/miriad-4.4M-split", split="eval")
    corpus, queries, relevant_docs, passage_to_id = {}, {}, {}, {}
    for idx, row in enumerate(eval_split):
        if row["passage_text"] not in passage_to_id:
            passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
            corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
        if idx < 500:
            queries[f"q{idx}"] = row["question"]
            relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}
    dev_evaluator = MultiVectorInformationRetrievalEvaluator(
        queries=queries, corpus=corpus, relevant_docs=relevant_docs, name="miriad-dev", batch_size=16
    )

    # 7. Training arguments, as discussed above
    run_name = "mLateOn-medical"
    args = MultiVectorEncoderTrainingArguments(
        output_dir=f"models/{run_name}",
        num_train_epochs=1,
        per_device_train_batch_size=128,
        per_device_eval_batch_size=16,
        learning_rate=1e-4,
        warmup_steps=0.05,
        prompts={"question": "[Q] ", "passage_text": "[D] "},
        fp16=False,  # Set to True if you have a GPU that supports FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,
        eval_strategy="steps",
        eval_steps=0.1,
        save_strategy="steps",
        save_steps=0.05,
        logging_steps=0.01,
        run_name=run_name,
    )

    # 8. Create a trainer & train
    trainer = MultiVectorEncoderTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        loss=loss,
        evaluator=dev_evaluator,
    )
    trainer.train()

    # 9. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 10. (Optional) Push it to the Hugging Face Hub
    try:
        model.push_to_hub(run_name)
    except Exception:
        logging.error(f"Error uploading model to the Hugging Face Hub:\n{traceback.format_exc()}")

if __name__ == "__main__":
    main()
레시피는 이 스크립트가 전부입니다. 지도 미세조정 이전 체크포인트, 도메인 쌍 100만 개, 배치 내 부정 예제, 문서 전체 길이, 그리고 통상보다 높은 학습률입니다. 이 학습은 RTX 3090 한 장에서 14.5시간이 걸렸고 VRAM 사용량은 최대 17.5GB였으며, 위 선택지 하나하나가 추측이 아니라 측정으로 고른 결과입니다.
예산이 더 적다면 규모를 줄여도 됩니다. 저자의 규모 실험에서 쌍 100,000개(학습 75분)는 100만 쌍 학습과 NDCG@10 기준 0.012 이내였습니다. 향상의 대부분이 첫 한 시간에 나옵니다.
심화 학습: 멀티 벡터 학습 예제 모음
MIRIAD (영문): 이 글의 레시피보다 앞선, 더 단순한 형태의 의료 도메인 학습 예제
- MS MARCO (영문): 대조 학습과 지식 증류 레시피
- Multimodal (영문): ColPali 방식의 시각 문서 검색 학습
- PEFT Adapters (영문): LoRA를 이용한 파라미터 효율적 미세조정
- Distributed Training (영문): GPU 여러 장으로 확장할 때
콜백과 다중 데이터셋 학습
MultiVectorEncoder 트레이너는 transformers.TrainerCallback의 여러 하위 클래스를 지원합니다. wandb 가 설치되어 있으면 학습 지표를 W&B로 보내는 WandbCallback, TensorBoard로 보내는 TensorBoardCallback, 학습 중 탄소 배출량을 추적하는 CodeCarbonCallback이 있습니다. report_to=["wandb", "codecarbon"] 처럼 지정해 켜고, 기본값은 "none" 이며 report_to="all" 은 의존성이 설치된 모든 통합을 켭니다.
성능이 좋은 범용 모델은 보통 여러 데이터셋을 동시에 써서 학습합니다. 형식이 제각각이라 까다로운 작업인데, MultiVectorEncoderTrainer 는 형식을 통일하지 않아도 여러 데이터셋을 받을 수 있고 데이터셋마다 다른 손실 함수를 걸 수도 있습니다. train_dataset 에 datasets.Dataset 딕셔너리나 DatasetDict 를 넘기고, 필요하면 데이터셋 이름을 손실 함수에 대응시킨 딕셔너리를 함께 넘기면 됩니다. 배치 하나에는 한 데이터셋의 표본만 들어가며, 어느 데이터셋에서 배치를 뽑을지는 MultiDatasetBatchSamplers로 정합니다. ROUND_ROBIN 은 하나가 소진될 때까지 번갈아 뽑아 모든 데이터셋을 똑같이 쓰는 대신 일부 표본은 쓰이지 않고, 기본값인 PROPORTIONAL 은 크기에 비례해 뽑아 모든 표본을 쓰는 대신 큰 데이터셋이 더 자주 등장합니다.
50개가 넘는 검색 모델 설정과 겨뤄 본 평가 결과
저자는 완성된 모델을 네 가지 구조 계열에 걸쳐 50개가 넘는 검색 모델 설정과 비교했습니다. 평가 방식은 위 평가기 절과 같고, 따로 떼어 둔 의료 질문 1,000개가 고유 문단 200,000개를 검색합니다. 정답 문단 10,000개가 학습 분할에서 중복 제거한 방해 문단 190,000개 사이에 숨어 있는 구성입니다. 이 말뭉치는 출발점 비교에 썼던 50,000개 말뭉치의 네 배라서, 앞의 표와 아래 표의 점수를 서로 비교하면 안 됩니다.
아래는 계열별 대표만 추린 것이고, 순서는 원문 표 그대로입니다. 55개 행 전체는 원문의 접힌 표에서 볼 수 있습니다. 맨 윗줄을 뺀 나머지는 모두 미세조정 없이 그대로 평가한 제로샷 결과이며, acc@1 은 정답 문단이 검색 결과 1위로 올라온 질의의 비율입니다.
@N 이 붙은 모델은 문서 길이 상한을 N 토큰까지 풀어서 평가한 것입니다. 원래 상한인 180에서 512 토큰 사이 값을 그대로 두면 평균 941 토큰짜리 문단이 잘려 나가기 때문입니다. 모든 멀티 벡터 모델에서 이 조치가 NDCG@10을 0.08에서 0.24까지 올렸고, 밀집 모델인 DenseOn조차 같은 조치로 0.03을 얻었습니다.
미세조정한 모델이 표 맨 위에 있고, 구조를 가리지 않고 제로샷(Zero-shot) 상태에서 가장 강한 모델보다 0.062 NDCG@10 앞섭니다. 다르게 말하면, 가장 강한 제로샷 모델은 질의의 75.8%에서 정답 문단을 첫 번째 결과로 돌려주는데 미세조정한 모델은 84.9%에서 그렇게 하고, 1순위 오류가 3분의 1 넘게 줄어듭니다.
구조에 따른 경향도 뚜렷합니다. 표 위쪽은 전부 Late Interaction입니다. 긴 문서에서는 문서당 벡터 하나보다 토큰당 벡터 하나가 낫고, 학습 조건과 백본을 맞춰도 그렇습니다. DenseOn과 LateOn은 머리 부분만 빼면 학습 데이터와 구조가 같은데 Late Interaction 쪽이 0.12 앞서고, 다국어 짝인 mDenseOn과 mLateOn에서도 0.13으로 같은 결과가 나옵니다. 규모를 키운다고 단일 벡터가 따라잡히는 것도 아닙니다. 밀집 모델 중 가장 강한 Qwen3-Embedding-4B는 저자 모델의 약 33배에 달하는 활성 파라미터(임베딩 제외)를 쓰고도 0.13 뒤에 있고, 8B 버전은 4B보다 점수가 낮습니다.
표에 이름을 올린 모델 중에는 PyTorchKR에 소개 글이 있는 것도 여럿입니다. 엣지 환경을 겨냥한 Liquid AI의 LFM2.5-ColBERT-350M, 밀집과 Late Interaction 두 형태를 함께 낸 Perplexity의 pplx-embed, 온디바이스용 소형 모델인 Google의 EmbeddingGemma, 여러 모달리티를 한 공간에 담은 Jina AI의 jina-embeddings-v5 계열이 여기에 해당합니다.
BM25의 성적도 예상보다 좋습니다. 모든 희소 모델, 절단 상한이 걸린 모든 멀티 벡터 모델, 그리고 밀집 모델 중 세 개를 뺀 전부를 앞섰습니다. BM25를 넘긴 밀집 모델은 수십억 파라미터 규모의 Qwen3-Embedding-4B와 8B, 그리고 voyage-4-nano 셋뿐이고, voyage-4-nano는 32k 토큰 컨텍스트를 전부 읽고도 0.006 차이로 겨우 앞섰습니다. 그러나 저자는 이 결과를 자기 데이터에 그대로 옮기지 말라고 밝히고 있습니다. MIRIAD의 질문은 문단에서 생성된 것이라 질의와 정답 문단 사이의 어휘 중복이 일반적인 검색보다 훨씬 크고, BM25는 컨텍스트 길이 제한이 없어서 그 중복 단어를 하나도 빠짐없이 쓰는 반면 신경망 체크포인트 대부분은 문서를 자릅니다. BM25 기준선은 값싸고 언제나 돌려 볼 가치가 있지만, 이 정도 격차를 기대하지는 말라는 이야기입니다.
표에서 눈여겨볼 행이 하나 더 있습니다. 저자가 같은 MIRIAD 데이터로 미세조정해 둔 밀집 모델 embeddinggemma-300m-miriad-unsloth와 희소 모델 splade-modernbert-base-miriad가 각각 0.6705와 0.6142로 올라 있습니다. 앞의 밀집 모델은 미세조정하지 않은 embeddinggemma-300m의 0.7000보다도 낮습니다. 원문이 이 두 모델의 학습 조건을 설명하지 않으므로 구조 사이의 통제된 비교로 읽을 수는 없지만, 도메인 데이터로 미세조정했다는 사실 자체가 상위권을 보장하지는 않는다는 점은 표에 그대로 남아 있습니다.
아래 그래프는 평가한 모델 전체를 점수순으로 늘어놓고 구조 계열별로 색을 입힌 것입니다. 모델마다 막대 하나이고, 문서 길이 상한을 풀 수 있는 모델은 푼 쪽 점수가 쓰였습니다. 세로축은 위 표의 값에 100을 곱한 백분율 표기입니다.
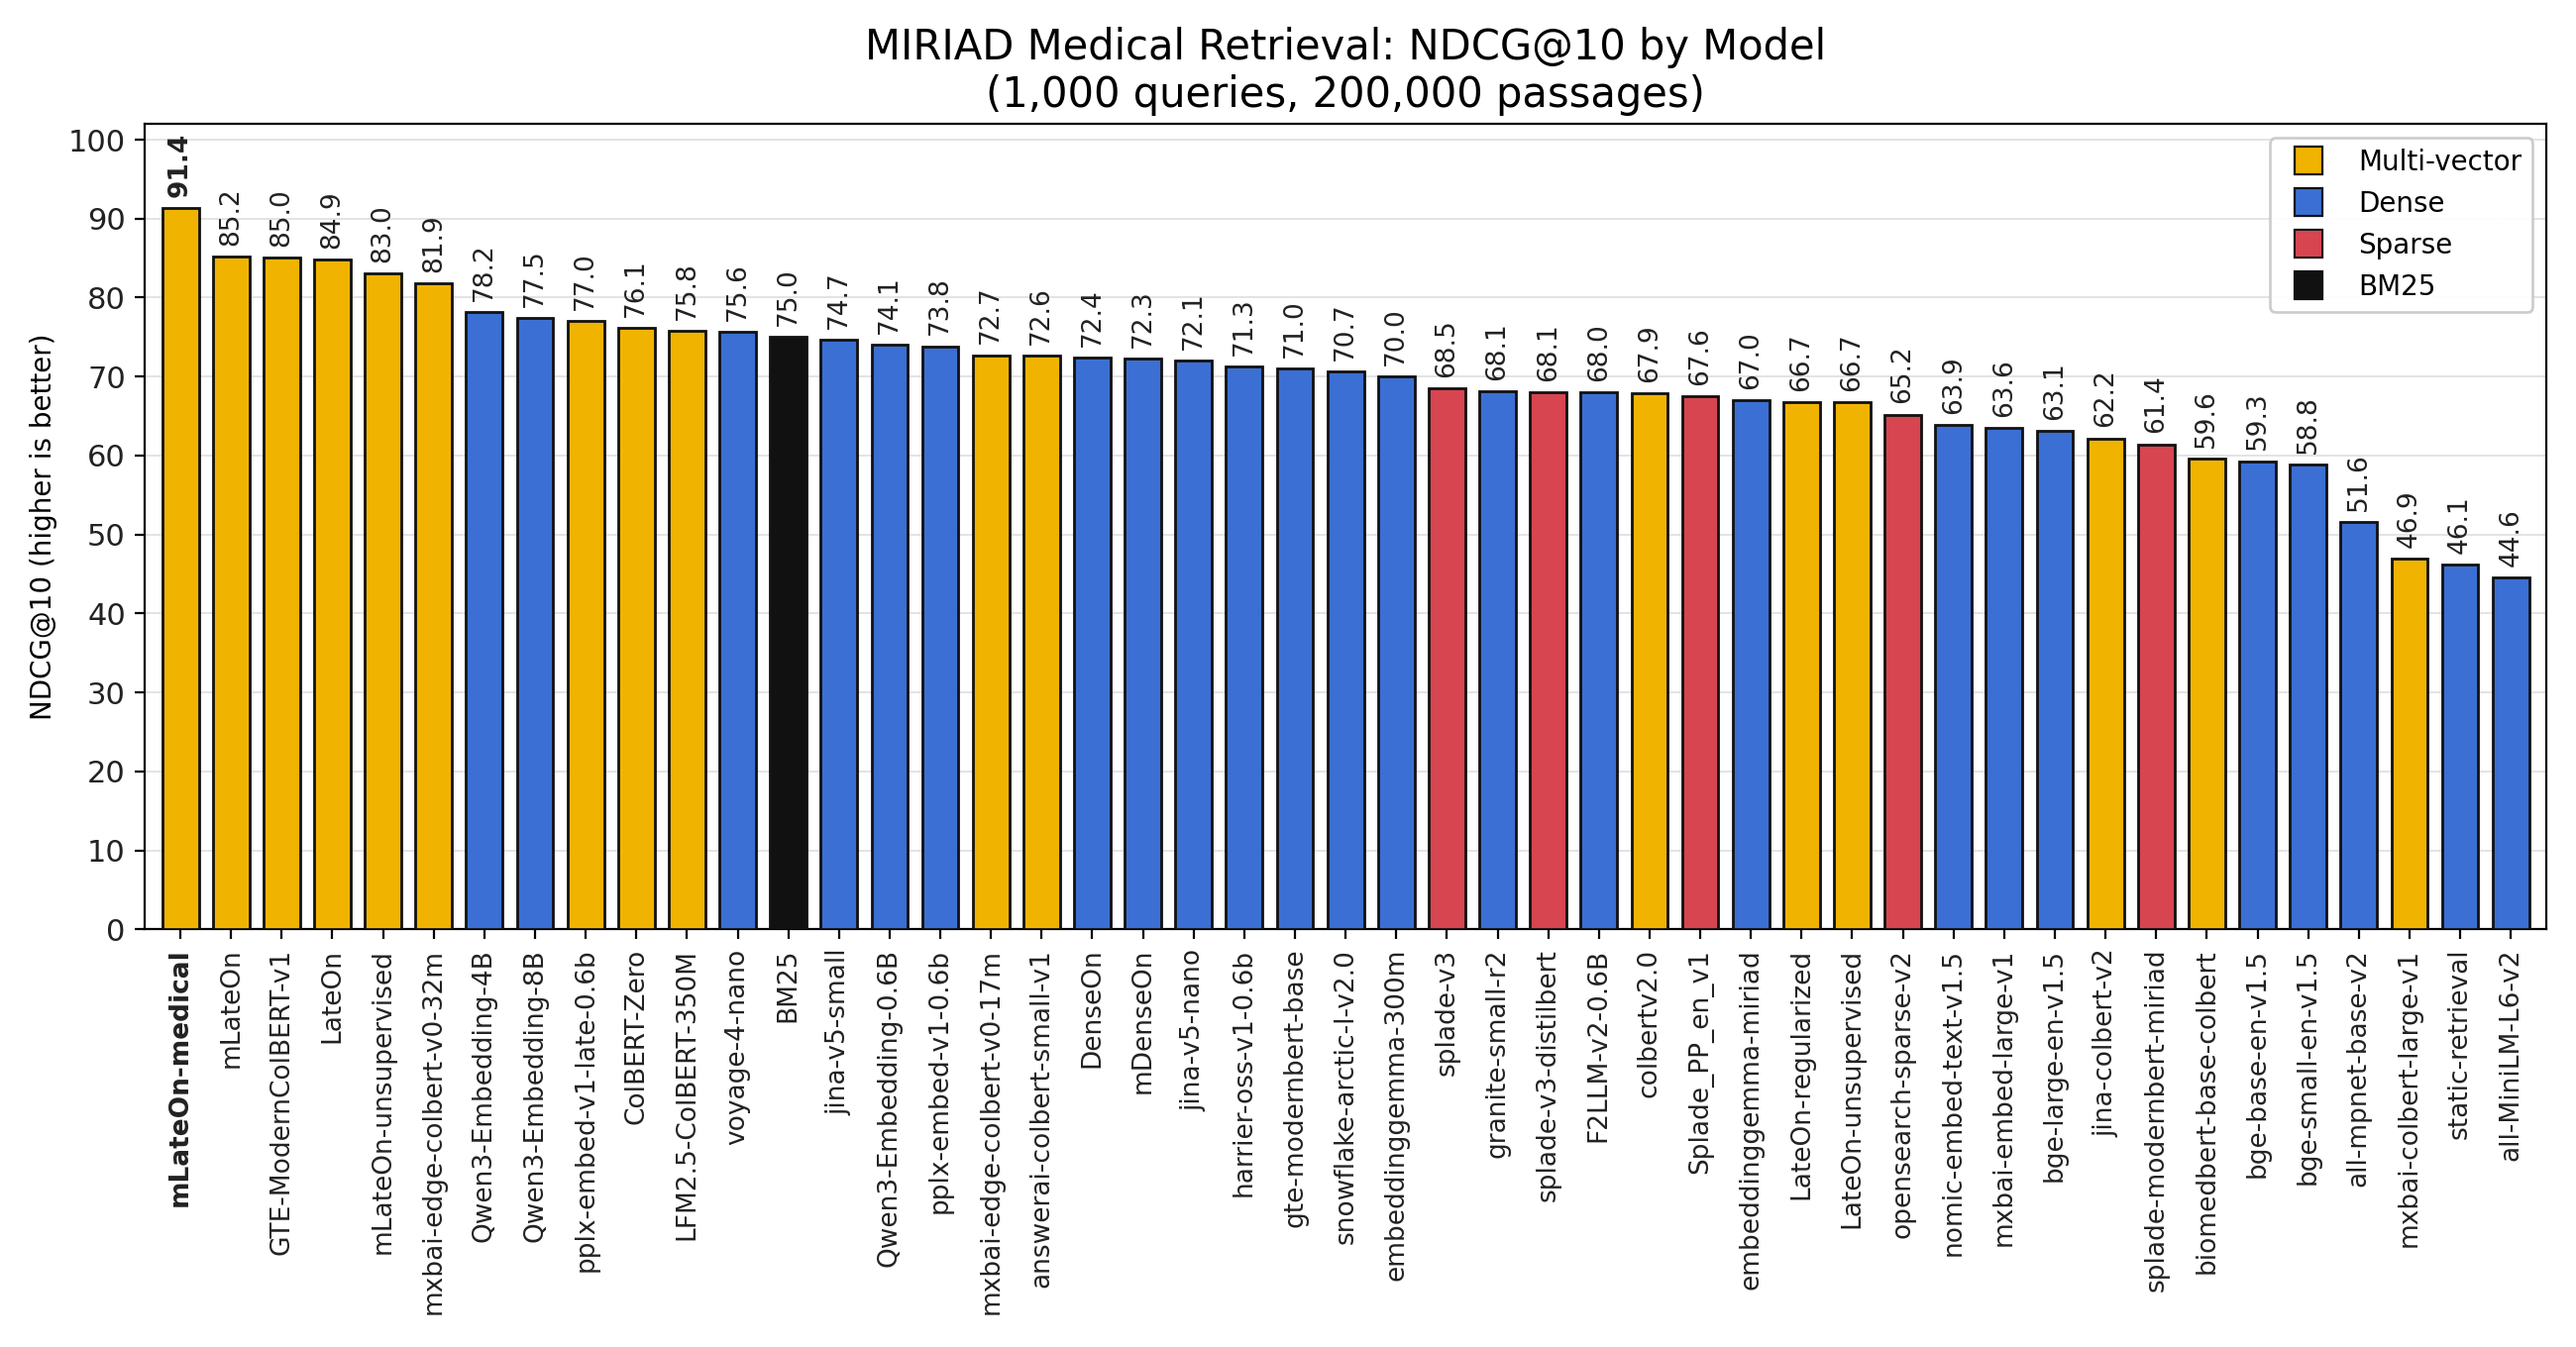
저자는 이 결과가 mLateOn-medical 이 모든 도메인에서 가장 강하다는 뜻은 아니라고 분명히 적어 두었습니다. 자기 도메인에서 가장 강할 뿐이고, 자기 데이터에서 잘 동작하는 모델이 필요했으므로 그것으로 충분하다는 것입니다.
색인 크기라는 대가, 그리고 토큰 풀링과 PLAID 양자화
멀티 벡터 검색을 두고 나오는 정당한 반론은 색인 크기이고, 이 도메인은 그 반론에 가장 불리한 조건에 가깝습니다. 토큰마다 벡터 하나를 저장하므로 저자의 모델은 문단당 약 878개의 벡터가 필요하고, 문단 200,000개짜리 말뭉치는 fp16 기준으로 대략 45GB가 됩니다. 밀집 모델이라면 1GB도 채 쓰지 않습니다.
이 격차를 그렇게까지 벌리는 것은 문서 길이입니다. 컴패니언 글에서 쓴 Natural Questions 문단은 토큰 벡터가 평균 125개 정도로 일곱 배쯤 적습니다. 짧은 문단으로 이뤄진 말뭉치라면 애초에 훨씬 작은 색인에서 출발합니다. HierarchicalTokenPooling 모듈은 바로 이 부분을 줄입니다. 문서마다 토큰 임베딩을 군집화하고 군집 평균만 저장해서, 벡터 개수를 대략 1 / pool_factor 로 유지합니다.
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
document_embeddings = model.encode_document(passages, token_pooling=pooling)
저자는 풀링을 고려한 학습 없이 완성된 모델에 사후로 적용해 측정했습니다. 결과는 아래 그래프에 정리되어 있습니다. 가로축은 200,000개 문단을 저장하는 데 드는 용량(로그 눈금), 세로축은 NDCG@10입니다.
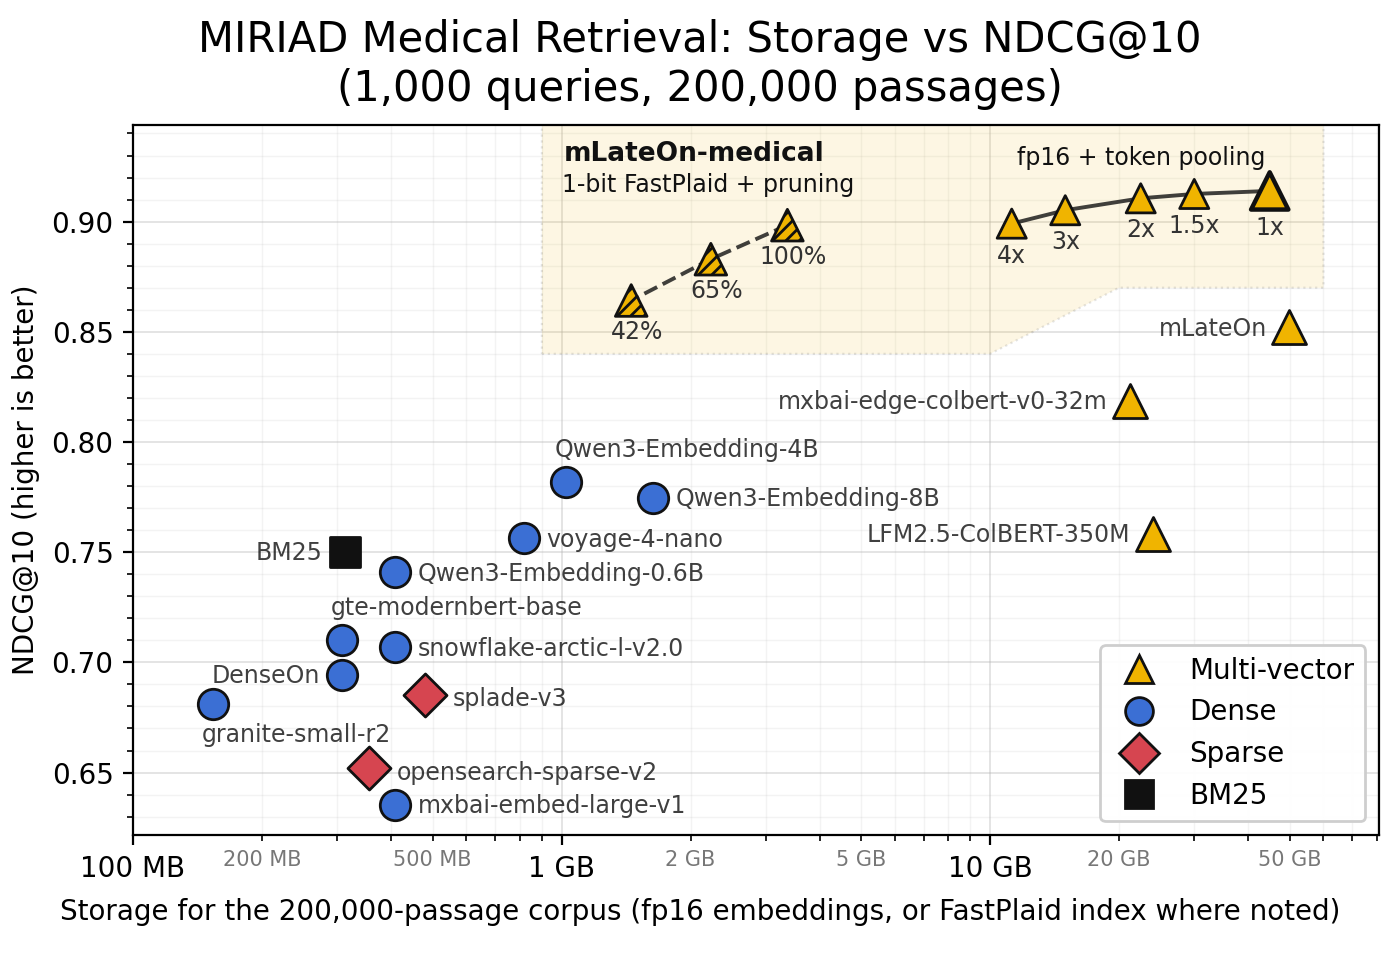
이 그래프에는 세 가지가 함께 그려져 있습니다.
빗금이 없는 단색 점들 은 각 모델의 압축하지 않은 임베딩입니다. 모든 계열을 같은 기준으로 세고 정확 검색으로 점수를 매긴 값입니다. 실제 배포에서 이대로 쓰는 경우는 없습니다. 밀집 색인은 보통 int8이나 이진 양자화(Quantization)에 재채점(Rescoring)을 함께 쓰고, 희소 색인은 포스팅 리스트를 압축하며, 멀티 벡터 색인은 PLAID 방식의 잔차 압축을 씁니다. 그러니 이 점들은 준비해야 할 디스크 용량이 아니라 상대적인 저장 비용으로 읽어야 합니다.
오른쪽 위의 실선 이 토큰 풀링 궤적이고, 1x 부터 4x 까지의 라벨이 벡터를 몇 분의 1로 줄였는지를 가리킵니다. 긴 문서에서는 그 대가가 상당히 작았습니다. 벡터 개수를 절반으로 줄이면 NDCG@10이 0.0033 떨어지고 1순위 정확도는 그대로였으며, 4분의 1만 남긴 11.2GB 구성도 0.8991을 냈습니다. 곡선은 더 이어져서 10분의 1까지 밀어붙여도 0.8765였습니다. 다만 양자화가 선택지에 들어오는 순간 풀링을 그렇게까지 밀어붙일 이유는 별로 없고, 그 이야기가 아래 점선입니다.
점선 은 실제 배포에 가까운 구성입니다. 저자는 ColBERT 논문의 저자인 Omar Khattab에게 모델과 벤치마크를 미리 제공했고, Omar Khattab이 fast-plaid로 아래 설정들을 측정했습니다. 1비트 잔차 양자화에, 통상적인 64비트 정수 대신 17비트 군집 ID와 18비트 문서 ID를 쓰고, 문서 쪽 가지치기(Pruning)를 더한 구성입니다.
| 설정 | 남긴 벡터 비율 | 색인 크기 | NDCG@10 |
|---|---|---|---|
| 1비트 PLAID, 전체 벡터 | 100% | 3.37 GB | 0.8984 |
| 1비트 PLAID + 가지치기 | 65% | 2.23 GB | 0.8830 |
| 1비트 PLAID + 가지치기 | 42% | 1.45 GB | 0.8642 |
첫 행은 원본 임베딩보다 13배 작으면서 NDCG@10을 0.0155만 내줍니다. 풀링 곡선의 어느 지점보다도 유리한 교환입니다. 양자화는 벡터 하나의 크기를 줄이고 풀링과 가지치기는 벡터 개수를 줄이므로 둘은 함께 쓸 수 있고, 먼저 적용해야 할 쪽은 양자화입니다. 더 밀어붙인 마지막 행은 1.45GB인데, 이는 Qwen3-Embedding-8B의 fp16 임베딩(1.64GB)보다 작으면서 점수는 0.0895 높습니다. 다만 여기 쓰인 가지치기는 양자화 위에 토큰 감축이 얹힌다는 것만 보이려는 단순한 방식이라, 아래 두 행은 도달 가능한 최선이 아니라 하한으로 읽어야 합니다. 양자화를 직접 조율하고 싶지 않다면 컴패니언 글의 Indexing 절이 fast-plaid와 Qdrant, Weaviate, Vespa를 각각 다룹니다. 저자는 이 절을 두고 멀티 벡터 색인이 너무 크다는 반론은 제대로 설정한 색인 앞에서는 성립하지 않는다고 정리합니다.
어디서부터 시작하면 좋을까
이 글의 절차를 자기 도메인에 옮길 때 결정해야 할 것은 많지 않습니다. 출발 체크포인트는 지도 미세조정 이전 버전이 있으면 그것을, 없으면 검색용으로 사전학습된 백본에 새 투사층을 얹습니다. 데이터는 (질의, 정답 문단) 두 열이면 되고, 교사 모델도 따로 찾아낸 어려운 오답(Hard Negatives)도 필요 없습니다. 문서가 길다면 길이 상한을 먼저 풀고, 학습에서도 그 길이를 그대로 씁니다. 손실 함수는 GradCache 변형을 쓰되 scale 을 밀집 쪽에서 복사해 오지 않습니다.
규모는 예산에 맞춰 줄여도 됩니다. 저자의 측정으로는 쌍 100,000개와 75분이 100만 쌍 학습의 0.012 이내까지 따라옵니다. 색인은 체크포인트만큼 신경 써야 하는 부분이고, 양자화까지 제대로 설정하면 원본 임베딩의 최소 7분의 1 크기에서 거의 같은 정확도가 나옵니다. 한국어 문서를 다룬다면 앞서 본 것처럼 지원 언어 목록에 한국어가 적혀 있다는 사실만으로 출발점을 고르기 어려우므로, 라이선스와 백본의 사전학습 범위를 함께 보고 후보를 두세 개 추린 뒤 저자가 한 것처럼 같은 레시피로 붙여 비교해 보는 것이 첫 단계가 될 것입니다.
 Training and Finetuning Multi-Vector Embedding Models with Sentence Transformers 소개 블로그
Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers 컴패니언 블로그
 Sentence Transformers GitHub 저장소
Multi-Vector Encoder 학습 공식 문서
 mLateOn-medical 모델 (Hugging Face)
MIRIAD 학습용 분할 데이터셋 (Hugging Face)
라이선스
Sentence Transformers는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 출발점으로 쓰인 lightonai/mLateOn-unsupervised 역시 모델 카드에 Apache 2.0을 명시하고 있습니다. 다만 결과물인 mLateOn-medical 의 모델 카드에는 라이선스 항목이 비어 있으므로, 그대로 가져다 쓰기 전에 저자에게 확인하는 편이 안전합니다.
더 읽어보기
-
Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers (영문)
-
Hugging Face, 최대 400배 빠른 CPU 기반 정적 임베딩(Static Embedding) 모델 공개 (feat. Sentence Transformers)
-
NVIDIA, RTEB 1위 오픈 임베딩 모델 Nemotron 3 Embed 공개 (feat. RAG, 에이전트 검색)
-
Liquid AI, 엣지용 350M 모델 LFM2.5와 다국어 검색 리트리버 LFM2.5 Retrievers 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글이 유용하셨다면 아래 쪽 좋아요
 를 눌러주세요. 파이토치 한국 사용자 모임
 이 새로운 소식을 정리하고 공유하는 데 힘이 됩니다!
