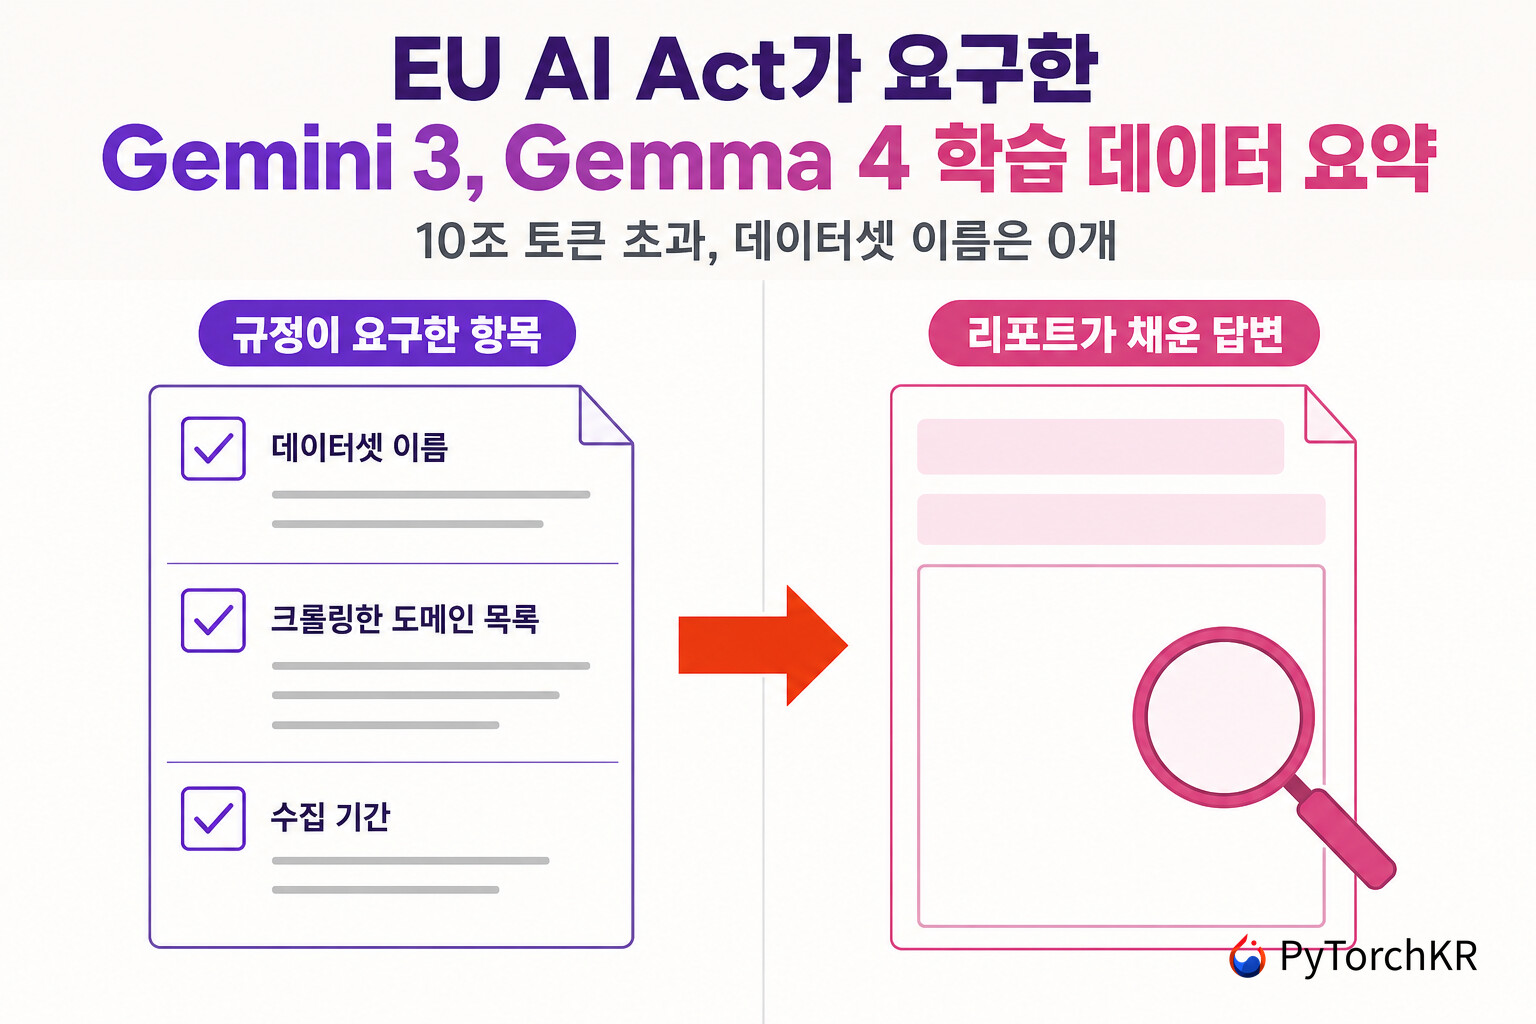
Gemini 3와 Gemma 4의 학습 데이터 공개 요약 소개
Google의 Gemini 3 Pro 계열과 Gemma 4 계열이 각각 무엇으로 학습되었는지를 Google이 직접 문서로 밝힌 자료 두 건이 Google 투명성 보고서 사이트에 올라와 있습니다. 각각 8쪽짜리 영문 PDF이고, 제목은 둘 다 Public Summary of Training Content for General-Purpose AI models 입니다. 홍보 문서도 기술 보고서도 아니고, EU 인공지능법(EU AI Act, Regulation (EU) 2024/1689) 제53조 제1항 (d)호가 범용 AI 모델(General-Purpose AI, GPAI) 제공자에게 의무로 부과한 학습 콘텐츠 공개 요약(Public Summary of Training Content) 을 EU AI Office가 배포한 양식에 채워 넣은 제출물입니다.
프런티어 모델의 학습 데이터는 지금까지 거의 공개되지 않았습니다. 모델 카드는 벤치마크 점수를 말하고 기술 보고서는 아키텍처와 학습 절차를 말하지만, 어떤 데이터셋을 썼는가 와 어느 웹사이트를 긁었는가 는 영업비밀로 남아 왔습니다. EU가 이 조항을 만든 이유가 바로 여기에 있습니다. AI Act 전문(Recital) 107조는 이 요약의 목적을 저작권자를 비롯해 "정당한 이익을 가진 당사자가 EU법상 권리를 행사하고 집행할 수 있도록" 하는 데 두고, 그래서 요약은 "기술적으로 상세하기보다 범위 면에서 전반적으로 포괄적" 이어야 한다고 적었습니다. 학습 레시피를 통째로 내놓으라는 것이 아니라, 권리자가 자기 저작물이 쓰였는지 짚어 볼 수 있을 만큼은 구체적이어야 한다는 요구입니다.
그런데 실제로 제출된 두 문서를 읽어 보면, 그 구체성의 눈금이 EU가 그어 둔 곳보다 한참 왼쪽에 찍혀 있습니다. 학습 데이터의 양 은 확실히 드러납니다. 텍스트는 10조 토큰 초과, 이미지는 10억 장 초과, 오디오와 비디오는 각각 100만 시간 초과라는 최상단 구간에 체크가 되어 있습니다. 규제기관에 제출된 문서에 적힌 값이라는 점에서 추정치와는 무게가 다릅니다. 반면 학습 데이터의 이름 은 한 건도 나오지 않습니다. 양식이 개별 식별자와 링크를 요구하는 대규모 공개 데이터셋 목록 칸에도, 크롤링(Crawling)한 도메인의 상위 10퍼센트 목록을 요구하는 칸에도 구체적인 고유명사가 없습니다. 이 글은 두 리포트를 항목별로 읽으면서, EU 양식이 무엇을 요구했고 Google이 무엇을 채웠으며 그 사이에 어떤 칸이 비어 있는지를 정리합니다.
읽기 전 전제: 이 문서들은 학습 데이터의 세부 구성을 밝힌 기술 보고서가 아니라 규제 제출용 요약본 입니다. 뒤에서 보겠지만 EU 양식 자체가 데이터 혼합 비율(mixture)을 요구하지 않기 때문에, 데이터셋별 비율이나 커리큘럼 순서를 여기서 알아낼 수는 없습니다. 무엇이 빠졌는지를 판단할 때는 Google이 숨긴 것 과 양식이 애초에 묻지 않은 것 을 구분해서 읽어야 합니다.
이 문서를 만들어 낸 법: EU AI Act 제53조 제1항 (d)호
EU 인공지능법은 2024년 8월 1일 발효되었고, 제5장 제2절이 범용 AI 모델 제공자의 의무를 정합니다. 그중 제53조 제1항 (d)호의 문장은 짧습니다.
"범용 AI 모델의 제공자는 (중략) AI Office가 제공하는 양식에 따라, 해당 범용 AI 모델의 학습에 사용된 콘텐츠에 관한 충분히 상세한 요약을 작성하여 공개적으로 이용 가능하게 하여야 한다."
"Providers of general-purpose AI models shall […] draw up and make publicly available a sufficiently detailed summary about the content used for training of the general-purpose AI model, according to a template provided by the AI Office."
핵심은 "충분히 상세한(sufficiently detailed)" 이라는 한 낱말과, "AI Office가 제공하는 양식" 이라는 조건입니다. 무엇이 충분히 상세한지를 제공자가 스스로 정하지 못하도록, 위원회가 양식으로 기준을 정해 두는 구조입니다.
2025년 7월에 확정된 공개 요약 양식
그 양식은 2025년 7월 24일 유럽 위원회가 학습 콘텐츠 공개 요약 설명서 및 양식(Explanatory Notice and Template)이라는 이름으로 확정했습니다(문서 번호 C(2025) 5235 final ANNEX). 2024년 7월 30일부터 9월 18일까지 진행된 다자 협의에 430건이 넘는 의견이 접수되었고, 이후 모델 제공자, 업계 단체, 권리자 단체, 학계, 시민사회, 공공기관 등 111곳의 서면 의견을 반영해 다듬어진 결과물입니다.
양식은 3개 절로 이루어져 있고, 두 리포트도 이 구조를 그대로 따릅니다.
| 절 | 요구하는 것 |
|---|---|
| 1. 일반 정보 | 제공자와 모델 식별, 모달리티별 학습 데이터 규모(광범위한 구간 선택), 학습 데이터의 언어와 일반적 특성 |
| 2. 데이터 출처 목록 | 공개 데이터셋, 상용 라이선스 데이터셋, 제3자 비공개 데이터셋, 크롤링 및 스크래핑 데이터, 사용자 데이터, 합성 데이터, 기타 |
| 3. 데이터 처리 사항 | 텍스트 및 데이터 마이닝(TDM) 예외에 대한 권리 유보 존중 조치, 불법 콘텐츠 제거 조치 |
설명서는 이 요약이 무엇을 위한 것인지도 다섯 갈래로 밝혀 두었습니다. 저작권과 지식재산권 행사, 개인정보 보호법상 정보주체의 권리 지원, 하위 개발자가 데이터 다양성을 평가해 차별 완화 조치를 취할 수 있게 하는 것, 연구자가 모델의 한계와 위험을 비판적으로 평가할 수 있게 하는 것, 그리고 마지막으로 시장 경쟁 입니다. 설명서는 "공개된 범용 AI 모델이 특히 모델 증류(Model Distillation)를 통해 다른 모델을 학습시키는 데 쓰였는지, 또는 모델이 제공자 자신의 제품과 서비스에서 수집한 사용자 데이터로 학습되었는지에 관한 정보" 가 이용자와 기업의 종속 효과(lock-in) 판단을 돕는다고 적었습니다. 뒤에서 보겠지만 이 두 가지는 두 리포트에서 모두 예 로 체크되어 있습니다.
오픈소스 예외가 통하지 않는 유일한 조항
Gemma 4는 Apache License 2.0으로 배포되는 개방형 가중치 모델입니다(
 Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개). AI Act 제53조 제2항은 자유 오픈소스 라이선스로 공개되고 가중치와 아키텍처, 사용 정보가 공개된 모델에 대해서는 같은 조 제1항 (a)호(기술 문서)와 (b)호(하위 제공자용 문서) 의무를 면제합니다. 그래서 오픈 모델은 이 규제에서 자유롭다고 오해하기 쉬운데, 설명서 각주 4는 그 예외가 (d)호에는 적용되지 않는다 고 못 박았습니다.
즉 학습 콘텐츠 공개 요약은 폐쇄형 모델과 개방형 모델을 가리지 않고 모든 범용 AI 모델 제공자에게 부과되는 의무입니다. Gemma 4 리포트가 존재하는 이유가 이것입니다. 가중치를 공개하는 것과 학습 데이터를 공개하는 것은 서로 다른 문제이고, AI Act는 후자를 개방형 모델과 폐쇄형 모델 양쪽에 똑같이 요구합니다.
시간표: 2025년 8월 적용, 2026년 8월 집행
날짜가 여러 개 얽혀 있어 정리해 둡니다.
| 시점 | 내용 |
|---|---|
| 2024년 8월 1일 | AI Act 발효 |
| 2025년 7월 24일 | 위원회가 공개 요약 양식과 설명서 확정 |
| 2025년 8월 2일 | 범용 AI 모델 관련 규정 적용 개시. 이 날 이후 시장에 출시되는 모델은 출시 시점까지 요약을 공개해야 함 |
| 2026년 8월 2일 | AI Office의 감독과 집행 권한 개시 |
| 2027년 8월 2일 | 2025년 8월 2일 이전에 출시된 모델의 요약 공개 기한 |
설명서는 요약을 늦어도 모델이 EU 시장에 출시되는 시점에 공개해야 하고, 제공자의 공식 웹사이트에 명확히 보이는 방식으로 게시하며, 모델이 배포되는 모든 공개 채널에도 함께 두어야 한다고 정했습니다. 이후에도 추가 학습이 있으면 6개월 간격 또는 실질적 변경이 생긴 시점 중 빠른 쪽으로 갱신해야 합니다. 위반 시 제재는 직전 회계연도 전 세계 총 매출의 3퍼센트 또는 1,500만 유로 중 높은 금액까지의 과징금입니다.
이른바 디지털 옴니버스(Digital Omnibus)가 2026년 7월 27일 발효되면서 AI Act의 고위험 AI 시스템 의무 기한이 상당 기간 연기되었지만, 범용 AI 모델 관련 의무는 그 조정 대상이 아니었습니다. 이 글을 쓰는 2026년 8월 시점에서 AI Office의 집행 권한은 이미 개시된 상태이고, 두 리포트는 그 직전인 2026년 7월에 갱신 날짜가 찍혀 있습니다.
두 리포트의 겉모습: 문서 두 건이 사실상 한 건인 이유
먼저 문서 자체의 신원 정보입니다.
| 항목 | Gemini 리포트 | Gemma 리포트 |
|---|---|---|
| 제공자 | Google Ireland Limited (Gordon House, Barrow Street, Dublin 4, Ireland) | 동일 |
| 대상 모델 | The Gemini 3 Pro family of models | The Gemma 4 family of models |
| 요약 버전 | v1 | v1 |
| 최종 갱신 | 2026년 7월 2일 | 2026년 7월 31일 |
| EU 시장 출시 | 2025년 11월 | 2026년 4월 |
| 지식 컷오프 | 2025년 1월 | 2025년 1월 |
| 분량 | 8쪽 | 8쪽 |
제공자 칸에는 미국 본사가 아니라 아일랜드 법인이 적혀 있습니다. 양식의 "EU 역내 대리인" 칸은 제공자가 EU 밖에 설립된 경우에만 채우게 되어 있는데(AI Act 제54조), 두 리포트 모두 이 칸이 비어 있습니다. AI Act상의 규제 대응 주체는 Google Ireland Limited입니다.
한 가지 짚어 둘 것은 양식 1.2절이 모델 이름과 함께 "모델 카드처럼 공개적으로 이용 가능한 추가 문서로 연결되는 링크를, 가능한 경우 제공하라" 고 안내한다는 점입니다. 두 리포트의 해당 칸에는 계열 이름만 적혀 있고 링크가 없습니다. PDF에 심긴 하이퍼링크를 전부 뽑아 보면 1쪽부터 4쪽까지는 링크가 한 건도 없고, 링크는 5쪽 이후의 크롤러 문서와 Gemini 앱 안내 페이지에만 붙어 있습니다. 뒤에서 보겠지만 Google은 이 리포트를 내기 전부터 모델 카드를 공개해 왔으므로, 링크가 없어서 못 넣은 것은 아닙니다.
모델 계열의 범위도 문서에 명시되어 있습니다. Gemini 리포트는 Gemini 3 Pro가 이전 모델의 수정본이나 미세조정(Fine-tuning) 결과가 아니며, 계열의 후속 모델들이 모두 Gemini 3 Pro를 기반으로 한다고 밝히면서 Gemini 3 Pro Image, Gemini 3 Flash, Gemini 3.1 Pro, Gemini 3.1 Flash Image, Gemini 3.1 Flash-Lite, Gemini 3.1 Flash Live, Gemini 3.5 Flash를 예로 듭니다. Gemma 리포트는 같은 문장 구조로 Gemma 4 E2B, Gemma 4 E4B, Gemma 4 12B, Gemma 4 26B A4B, Gemma 4 31B를 나열합니다. 하나의 요약본이 여러 모델과 버전을 포괄하는 것은 각 요약의 내용이 동일한 경우에 한해 양식이 명시적으로 허용하는 방식입니다. 목록에 들어 있는 12B는 2026년 4월 출시 당시의 네 가지 크기에는 없던 모델이므로, 이 요약본은 나중에 추가된 모델까지 함께 덮고 있습니다(가중치는 Hugging Face의 Gemma 4 컬렉션에서 받을 수 있습니다).
그리고 두 문서의 서술 부분은 모델 이름과 날짜를 빼면 글자 단위로 같습니다. 두 PDF에서 텍스트를 추출해 공백을 정규화한 뒤 비교해 보면, 차이가 나는 곳은 Gemini 3 Pro 와 Gemma 4 라는 이름, 계열 모델 목록, 시장 출시 날짜, 그리고 뒤에서 볼 합성 데이터 모달리티 체크 한 칸뿐입니다. 크롤러 설명도, 데이터 필터링 설명도, 저작권 조치 설명도 같은 문장입니다. 심지어 크롤러 동작을 설명하는 칸의 "are used to to discover" 라는 오타까지 두 문서에 똑같이 들어 있습니다.
이것 자체가 규정 위반은 아닙니다. 폐쇄형 프런티어 모델과 개방형 온디바이스 모델이 같은 사내 데이터 파이프라인을 공유한다면 요약이 같아지는 것이 오히려 자연스럽습니다. 다만 독자 입장에서는 이 두 문서가 각 모델의 개별 사정을 반영한 서술이 아니라 회사 차원의 공통 답변 한 벌이라는 점을 알고 읽어야 합니다.
버전 정보에서 읽히는 것
양식의 첫 두 줄은 "요약본의 버전(해당하는 경우 이전 버전 링크 포함)" 과 "최종 갱신 DD/MM/YY" 입니다. 두 리포트 모두 버전 칸에 v1 이라고만 적혀 있고 이전 버전 링크는 없습니다. 최종 갱신일은 각각 2026년 7월 2일과 7월 31일입니다.
Google은 같은 문서에서 Gemini 3 Pro 계열이 2025년 11월에 EU 시장에 출시되었다고 밝히고 있으므로, 출시 시점과 이 문서에 찍힌 날짜 사이에는 여덟 달가량의 간격이 있습니다. 이 간격을 어떻게 해석해야 하는지는 문서만으로 확정할 수 없습니다. v1 이 2025년 11월에 처음 게시되었고 이후 내용 변경 없이 날짜만 갱신된 것일 수도 있고, 이번이 첫 게시일 수도 있습니다. 다만 양식이 이전 버전 링크 자리를 마련해 둔 이유가 바로 이 판단을 독자가 할 수 있게 하려는 것이고, 그 칸이 비어 있으면 외부에서는 갱신 이력을 추적할 방법이 없습니다. 두 리포트의 갱신일이 AI Office의 집행 권한 개시일인 2026년 8월 2일 직전에 몰려 있다는 점도 함께 기록해 둘 만합니다.
학습 데이터의 종류와 분량: 네 모달리티 모두 최상단 구간
양식 1.3절은 전처리 후 학습 직전 상태의 데이터를 기준으로, 존재하는 모달리티에 체크하고 각 모달리티마다 세 구간 중 하나를 고르게 합니다. 두 리포트의 답은 동일합니다.
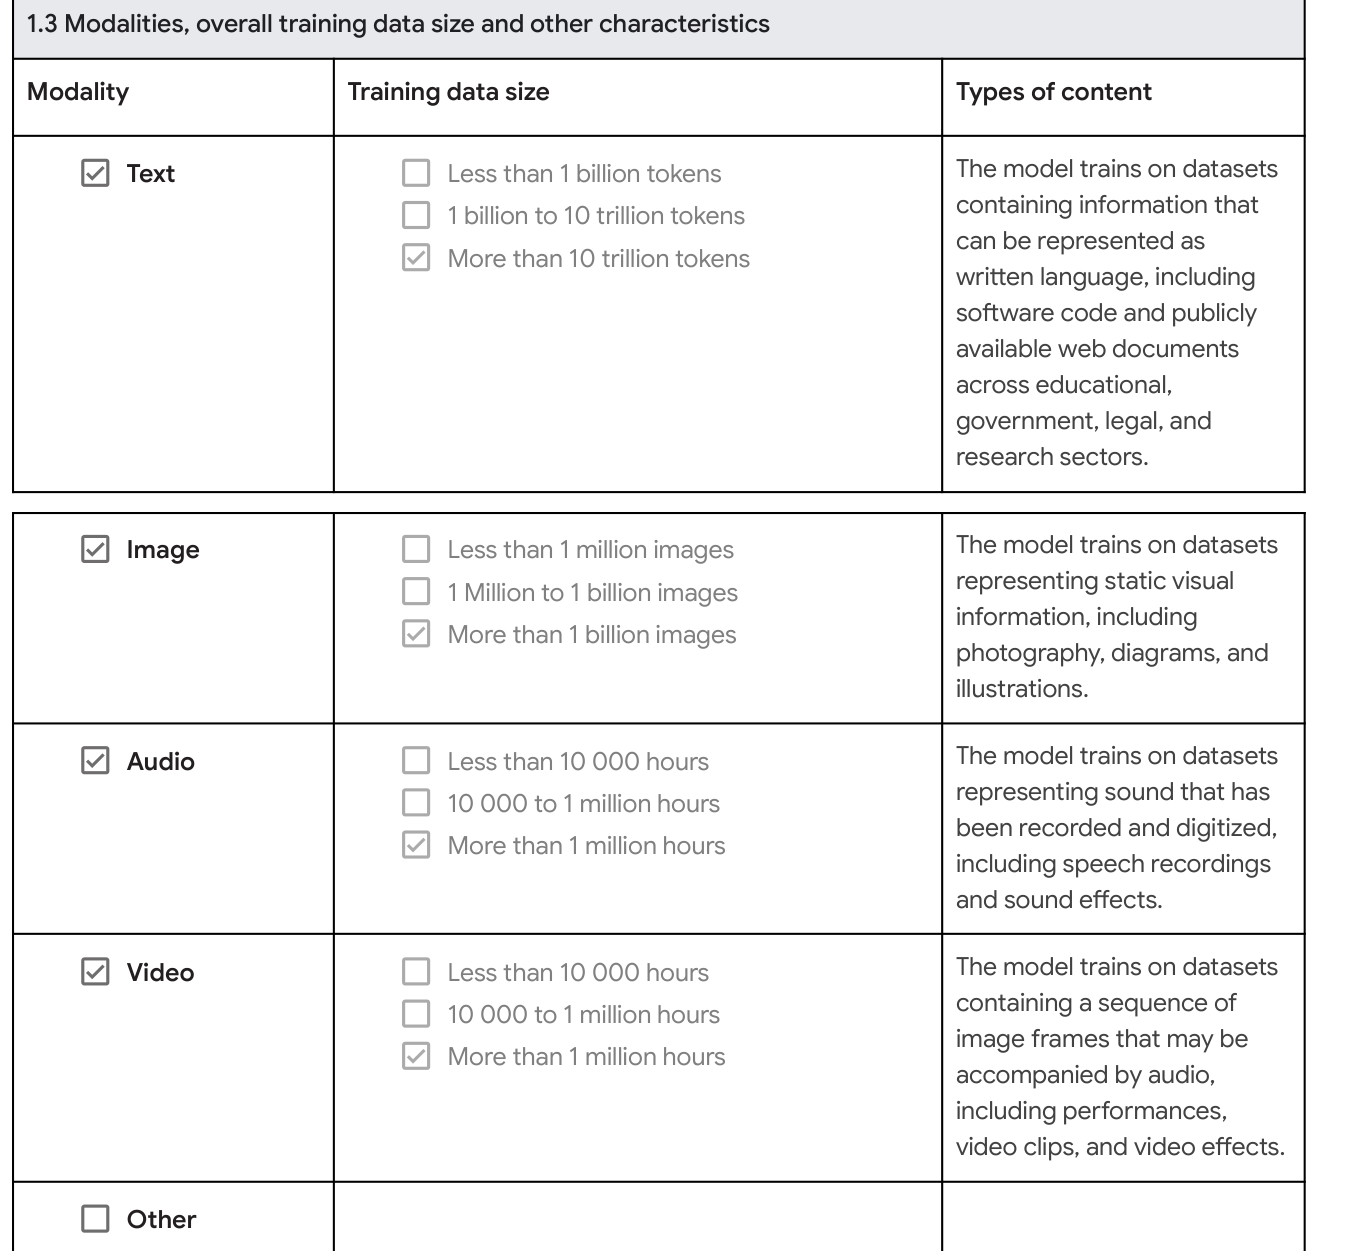
| 모달리티 | 선택 가능 구간 | 체크된 구간 |
|---|---|---|
| 텍스트 | 10억 토큰 미만 / 10억~10조 토큰 / 10조 토큰 초과 | 10조 토큰 초과 |
| 이미지 | 100만 장 미만 / 100만~10억 장 / 10억 장 초과 | 10억 장 초과 |
| 오디오 | 1만 시간 미만 / 1만~100만 시간 / 100만 시간 초과 | 100만 시간 초과 |
| 비디오 | 1만 시간 미만 / 1만~100만 시간 / 100만 시간 초과 | 100만 시간 초과 |
| 기타 | 자유 기술 | 체크 없음 |
네 모달리티 모두 가장 위 구간입니다. 구간이 열려 있는 형태라 상한이 없고, 따라서 이 표에서 알 수 있는 것은 최소한 이만큼은 넘는다 는 하한선뿐입니다. 양식에는 "다른 측정 단위로 대략적인 크기를 명시" 할 수 있는 대안 칸이 텍스트 모달리티에 마련되어 있는데, 두 리포트 모두 이 칸을 쓰지 않았습니다.
그래도 하한선만으로 읽어 낼 것이 있습니다. 오디오 100만 시간은 24시간 연속 재생으로 약 114년 분량이고, 비디오도 같은 구간입니다. 텍스트 10조 토큰은 공개된 대규모 코퍼스 여러 개를 합쳐야 도달하는 규모입니다. 개방형 온디바이스 모델인 Gemma 4가 폐쇄형 프런티어 모델인 Gemini 3 Pro와 같은 구간에 체크되어 있다는 점도 눈에 띕니다. Gemma 4 모델 카드와 발표 블로그가 "Gemini 3와 동일한 연구와 기술로 만들어졌다" 고 밝힌 것과 일관된 그림이고, 모델 크기가 작다고 학습 데이터가 작은 것은 아니라는 통념을 문서로 확인해 주는 대목이기도 합니다.
각 모달리티의 콘텐츠 유형 서술은 다음과 같습니다.
- 텍스트: 소프트웨어 코드와, 교육, 정부, 법률, 연구 분야에 걸친 공개 웹 문서를 포함해 문자 언어로 표현될 수 있는 정보를 담은 데이터셋
- 이미지: 사진, 도표, 삽화를 포함해 정적 시각 정보를 나타내는 데이터셋
- 오디오: 음성 녹음과 음향 효과를 포함해 녹음되고 디지털화된 소리를 나타내는 데이터셋
- 비디오: 공연, 비디오 클립, 비디오 효과를 포함해 오디오가 동반될 수 있는 이미지 프레임 시퀀스를 담은 데이터셋
양식이 예시로 든 콘텐츠 유형과 비교해 보면 서술의 결이 드러납니다. 양식은 텍스트 항목에 "픽션과 논픽션 텍스트, 과학 텍스트, 언론 출판물, 법률 및 공문서, 소셜 미디어 댓글, 소스 코드" 를, 이미지 항목에 "사진, 시각 예술 작품, 인포그래픽, 소셜 미디어 이미지, 로고, 브랜드" 를, 오디오 항목에 "음악 작곡과 녹음, 오디오북, 라디오 프로그램과 팟캐스트, 사적 음성 통신" 을 예시로 제시합니다. Google의 답변에는 언론 출판물, 시각 예술 작품, 음악, 오디오북처럼 권리자가 뚜렷한 범주 가 하나도 등장하지 않고, 대신 교육, 정부, 법률, 연구라는 네 분야 표현이 문서 전체에서 반복됩니다.
언어에 관해서는 "우리 모델은 EU 공식 언어를 포함해 폭넓은 언어로 작동하도록 학습되었으며, 이는 인터넷 전반을 대표한다" 는 한 문장이 전부입니다. 언어별 비중이나 한국어를 포함한 개별 언어의 분포는 없습니다.
그 아래 칸의 이름은 "모델 학습을 위한 데이터 취득 및 수집의 최종 일자" 이고, 양식은 MM/YYYY 형식으로 적은 뒤 그 이후에도 새 데이터나 동적 데이터로 계속 학습하는지를 덧붙이라고 안내합니다. 두 리포트의 답변은 "Gemini 3 Pro의 지식 컷오프 날짜는 2025년 1월입니다. 이 날짜 이후에도 주기적으로 모델을 갱신할 수 있습니다" 입니다. 뒷문장은 질문에 답하지만, 앞문장의 지식 컷오프는 데이터에 담긴 정보가 어디까지 최신인지를 가리키는 값이라 데이터를 언제까지 모았는지와 같은 값이 아닙니다. 같은 치환이 뒤의 2.3절에서 한 번 더 나타납니다.
전체 학습 데이터의 성격을 설명하는 칸에는 사전학습(Pre-training)과 사후학습(Post-training)을 나눈 서술이 들어 있습니다. 사전학습 데이터셋은 공개 웹 문서, 코드, 이미지, 오디오(음성 및 기타 오디오 유형), 비디오를 아우르는 대규모 다양 데이터의 집합이고, 사후학습 데이터셋에는 여러 유형의 지시 미세조정(Instruction Tuning) 데이터, 강화학습(Reinforcement Learning) 데이터, 인간 선호(Human-preference) 데이터가 포함되었다고 적혀 있습니다. 학습 파이프라인에 관해 두 리포트가 담고 있는 내용은 여기까지입니다.
데이터 출처 여섯 갈래: 전부 '예'로 체크된 목록
양식 2절은 데이터 출처를 여섯 갈래로 나누고, 그 안에서 예/아니오 질문 여덟 개를 던집니다(2.2절과 2.4절은 질문이 각각 두 개입니다). 두 리포트는 여덟 개 전부 '예' 입니다. 한 갈래씩 짚어 보겠습니다.
2.1 공개 데이터셋: 이름이 한 건도 없는 칸
양식은 이 절에서 제3자가 만들어 무료로 공개했고 통째로 또는 정해진 덩어리로 내려받을 수 있는 데이터셋을 다룹니다. 공개 저장소와 플랫폼의 데이터셋, 전문 웹사이트, Common Crawl 스냅샷 같은 것들이 여기 해당합니다. 그리고 "대규모(large)" 데이터셋의 정의를 숫자로 정해 두었습니다. 해당 모달리티에서 학습에 쓰인 전체 공개 데이터셋 크기의 3퍼센트를 넘으면 대규모이고, 대규모 데이터셋 각각에 대해 "데이터셋의 식별자 또는 이름과, 데이터셋에 접근할 수 있는 링크" 를 제공해야 합니다. 링크가 없으면 수집 시작일과 종료일을 포함한 일반적 설명을 적고, 데이터셋의 일부만 썼다면 그 부분을 고른 방식을 밝히라고 되어 있습니다.
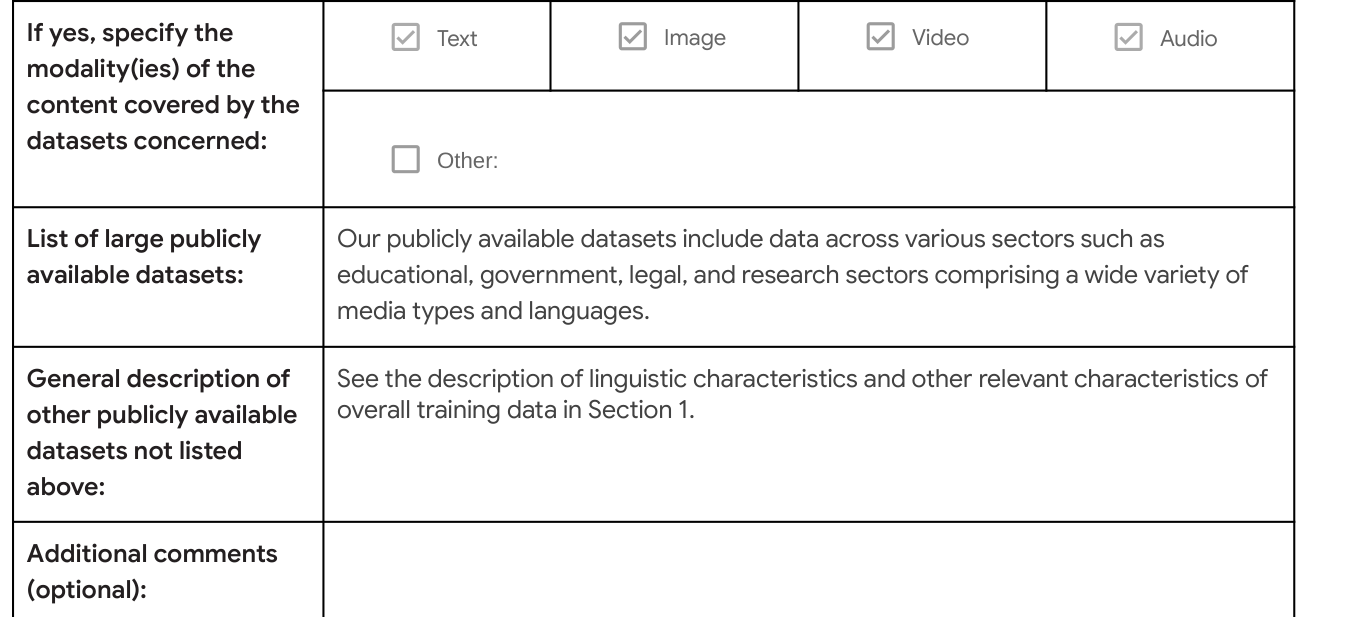
Google의 답변은 한 문장입니다. "우리의 공개 데이터셋에는 교육, 정부, 법률, 연구 분야 등 다양한 분야에 걸친 데이터가 포함되며, 폭넓은 매체 유형과 언어로 구성됩니다." 데이터셋 이름도, 링크도, 수집 기간도, 개수도 없습니다. 바로 아래 칸인 "위에 나열되지 않은 다른 공개 데이터셋에 대한 일반적 설명" 에는 "1절의 언어적 특성 및 기타 특성 서술을 참조하라" 는 상호 참조가 들어가 있습니다. 즉 두 칸 모두 실질적으로 1절의 같은 문장을 가리킵니다.
이 절이 두 리포트에서 요구와 답변의 간극이 가장 큰 자리입니다. 양식은 개별 식별자를 요구하는데 답변은 분야 수준의 형용사로 채워져 있고, 상위 참조 칸까지 같은 곳을 가리키고 있어 실질 정보량이 늘지 않습니다.
2.2 상용 라이선스와 제3자 비공개 데이터셋
2.2.1절은 권리자 또는 그 대리인과 체결한 상용 라이선스 계약을 묻습니다. 두 리포트 모두 예 이고, 텍스트, 이미지, 비디오, 오디오 네 모달리티 전부에 체크되어 있습니다. 양식이 이 절에서 요구하는 것은 여기까지입니다. 설명서는 라이선스 데이터에 대해서는 "권리자가 라이선스 계약의 당사자이므로" 최소한의 공개만 요구한다고 그 이유를 밝혔습니다. 권리자 본인은 자기가 무엇을 팔았는지 이미 알기 때문에, 굳이 공개할 필요가 없다는 논리입니다.
2.2.2절은 권리자와 직접 계약하지 않은 경로로 얻은 비공개 데이터셋, 예를 들어 데이터 중개자나 비공개 데이터베이스 제공자로부터 받은 데이터를 묻습니다. 역시 두 리포트 모두 예 이고 네 모달리티 전부입니다. 양식은 "공개적으로 알려진 경우" 그 데이터셋의 이름을 나열하라고 하는데, Google의 답변은 "2.2.2절에 해당하는 비공개 데이터셋 중 공개적으로 알려진 것은 없습니다" 입니다. 알려지지 않은 데이터셋에 대해서는 일반적 설명을 적게 되어 있고, 여기에 데이터의 내용을 가리키는 서술 가운데 가장 구체적인 축에 드는 문장이 등장합니다.
"데이터셋은 교육 자료, 과학적 추론, 수학을 포함한 주제 영역을 다룹니다."
"Datasets cover subject areas including educational materials, scientific reasoning, and mathematics."
권리자와 직접 계약한 경로가 아닌 방식으로 수학과 과학적 추론 데이터를 확보했다는 진술이고, 최근 프런티어 모델들의 추론 성능 향상과 자연스럽게 이어지는 대목입니다. 다만 여기서도 공급처나 규모는 없습니다.
2.3 크롤링과 스크래핑: 도메인 상위 10퍼센트를 요구한 칸
이 절이 저작권자에게 실질적으로 가장 중요한 자리입니다. 양식은 크롤러 이름과 식별자, 크롤러의 목적, 크롤러 동작에 대한 일반적 설명, 수집 기간, 크롤링한 콘텐츠 유형과 온라인 출처에 대한 포괄적 설명을 차례로 묻고, 마지막에 가장 관련성 높은 도메인 이름 요약 을 요구합니다. 그 요구의 문장은 다음과 같이 아주 구체적입니다.
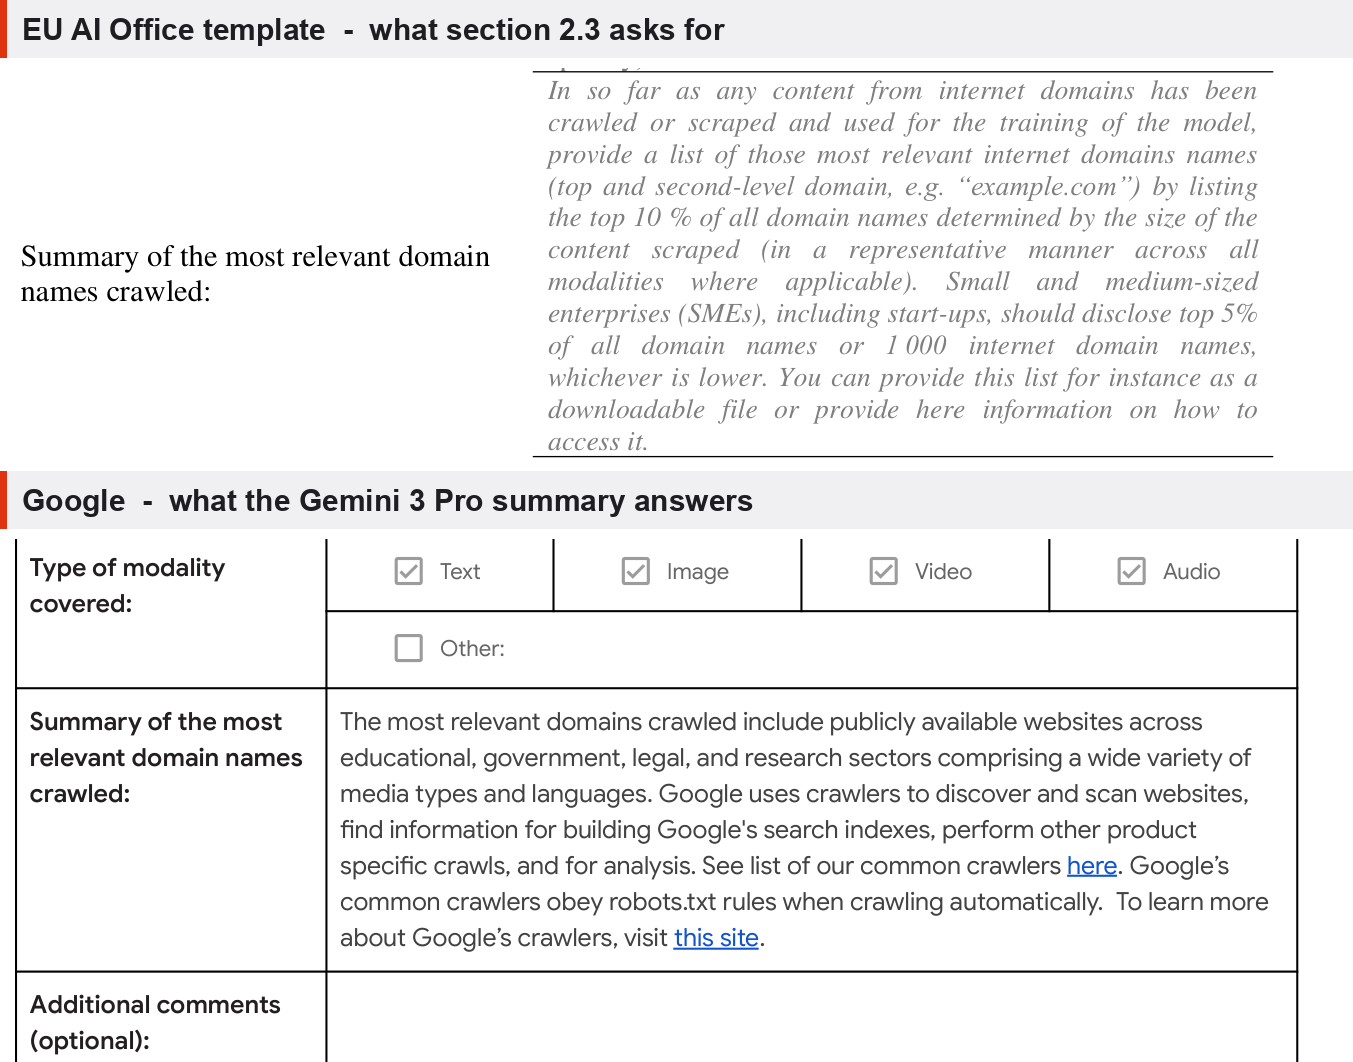
"인터넷 도메인의 콘텐츠가 크롤링 또는 스크래핑되어 모델 학습에 사용된 범위 내에서, 스크래핑된 콘텐츠의 크기로 결정한 전체 도메인 이름의 상위 10퍼센트 를 나열하여 가장 관련성 높은 인터넷 도메인 이름(최상위 및 2단계 도메인, 예: "example.com")의 목록을 제공하십시오. (중략) 이 목록은 예를 들어 내려받을 수 있는 파일로 제공하거나, 접근 방법에 관한 정보를 여기에 적을 수 있습니다."
중소기업과 스타트업은 상위 5퍼센트 또는 1,000개 도메인 중 적은 쪽으로 부담이 완화되지만, Google에는 상위 10퍼센트 기준이 적용됩니다. 설명서 본문도 이 요구를 별도 문단으로 다시 설명하면서, 목록에 없는 도메인에 대해서는 권리자가 요청할 경우 자사가 그 도메인의 콘텐츠를 학습에 썼는지 알려 주는 절차를 자발적으로 운영할 것을 권고했습니다.
Google의 답변은 다음과 같습니다.
"크롤링된 가장 관련성 높은 도메인에는 교육, 정부, 법률, 연구 분야에 걸친 공개 웹사이트가 포함되며, 폭넓은 매체 유형과 언어로 구성됩니다. Google은 크롤러를 사용해 웹사이트를 발견하고 스캔하며, Google 검색 색인 구축을 위한 정보를 찾고, 다른 제품별 크롤링을 수행하고, 분석을 위해 사용합니다. 우리의 일반 크롤러 목록은 여기를 참조하십시오. Google의 일반 크롤러는 자동 크롤링 시 robots.txt 규칙을 준수합니다."
도메인 이름이 하나도 없습니다. "여기" 가 가리키는 링크는 도메인 목록이 아니라 Google 공용 크롤러 문서이고, 그 문서는 Googlebot을 비롯해 검색과 제품별 크롤러를 함께 나열한 일반 안내서입니다. 어느 크롤러가 Gemini와 Gemma 학습 데이터 수집에 쓰였는지도 이 링크에서는 좁혀지지 않습니다. 크롤러 이름을 묻는 별도 칸에도 같은 링크가 "See list of crawlers here" 한 줄로 들어가 있습니다.
수집 기간 칸도 마찬가지입니다. 양식은 "MM/YYYY부터 MM/YYYY까지" 라는 형식까지 지정했는데, 답변은 "Gemini 3 Pro의 지식 컷오프 날짜는 2025년 1월입니다. 이 날짜 이후에도 주기적으로 모델을 갱신할 수 있습니다" 로, 시작 시점이 없습니다. 지식 컷오프는 데이터에 담긴 정보의 최신성을 가리키는 개념이고 수집 기간은 크롤링 행위가 벌어진 기간이라, 같은 값이 두 질문의 답이 될 수는 없습니다. 크롤러 동작을 설명하는 칸에도 양식이 예로 든 캡차, 비밀번호로 보호된 사이트, 페이월에 대한 처리 방침 대신 크롤러의 목적 문장이 그대로 한 번 더 반복됩니다.
2.4 사용자 데이터: Gemini 앱 대화가 학습에 쓰입니다
양식 2.4절은 메일 서비스, 소셜 미디어 플랫폼, 콘텐츠 플랫폼, 그리고 제공자의 AI 모델 및 시스템과의 상호작용을 포함해 제공자의 모든 서비스와 제품에서 수집된 사용자 데이터를 다룹니다. 여기서 두 리포트는 두 질문 모두에 예 로 답했습니다. 모델과의 상호작용에서 나온 데이터, 그리고 제공자의 다른 서비스와 제품에서 수집한 데이터가 둘 다 학습에 쓰였습니다.
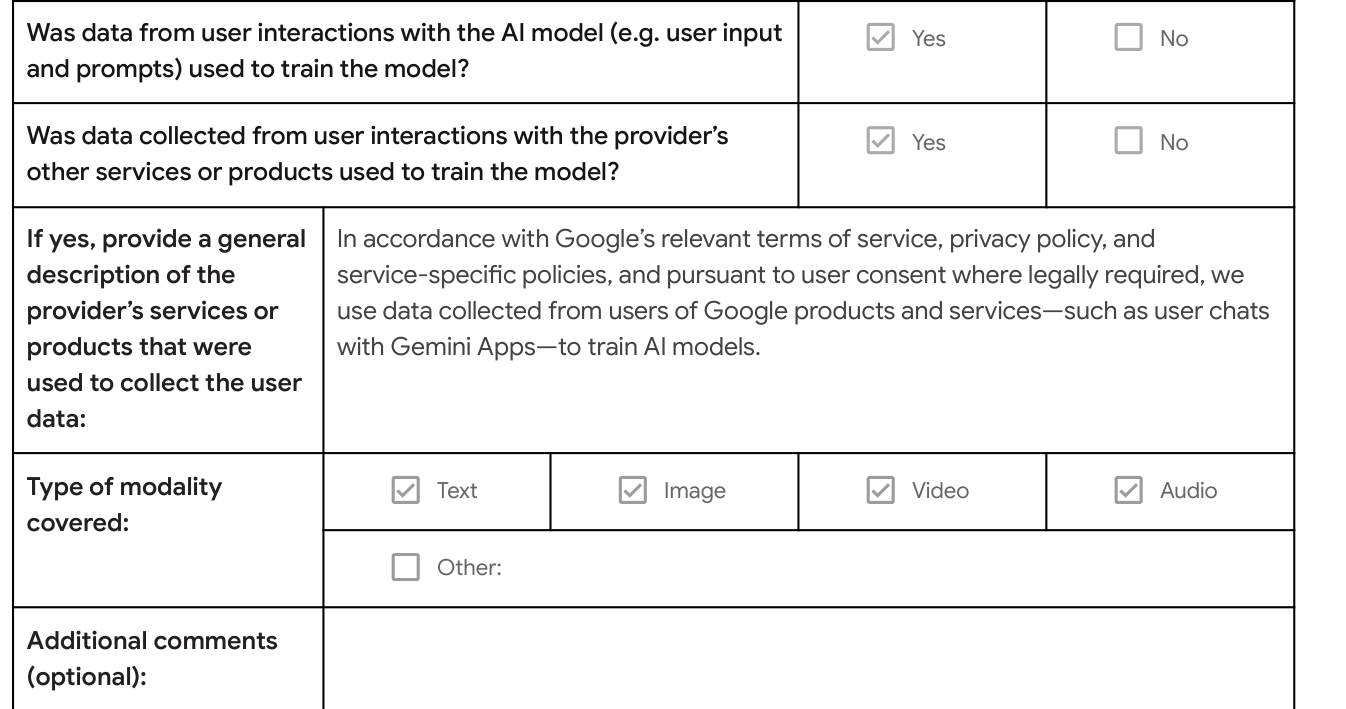
서술 칸의 문장은 이렇습니다. "Google의 관련 서비스 약관, 개인정보처리방침 및 서비스별 정책에 따라, 그리고 법적으로 요구되는 경우 사용자 동의에 근거하여, 우리는 Gemini 앱과의 사용자 대화와 같이 Google 제품 및 서비스 사용자로부터 수집한 데이터를 AI 모델 학습에 사용합니다." 모달리티는 텍스트, 이미지, 비디오, 오디오 네 가지 모두입니다.
"Google 제품 및 서비스" 라는 표현의 범위는 열려 있고, 구체적으로 이름이 나온 제품은 Gemini 앱 하나뿐입니다. 예시를 뜻하는 "such as" 로 연결되어 있어서 다른 제품이 포함되는지 여부는 이 문서만으로는 판단할 수 없습니다. 개인정보 보호 관점에서 이 절이 중요한 이유를 설명서가 밝혀 두었는데, 요약이 인터넷에서 스크래핑한 데이터와 서비스 상호작용에서 수집한 데이터에 관한 정보를 한자리에 모아 두면 정보주체의 권리 행사와 EU 개인정보 보호 규정의 집행에 도움이 된다는 것입니다.
2.5 합성 데이터: 두 리포트가 달라지는 유일한 칸
양식 2.5절은 다른 AI 모델의 출력을 직접 학습에 쓰는 경우, 특히 모델 증류나 모델 정렬(AI 피드백 기반 강화학습 등)을 통해 만들어진 합성 데이터(Synthetic Data)를 다룹니다. 데이터를 정제하거나 보강하는 용도로 AI 모델을 쓰는 경우는 제외입니다.
두 리포트 모두 예 이고, 사용한 모델도 명시되어 있습니다. "우리는 외부에 공개된 Gemini 3 계열 모델을 사용해 합성 데이터를 생성했습니다." 그리고 그 뒤 칸에는 "학습용 합성 데이터 생성을 위해 내부 모델과 비-GPAI 모델의 미세조정 버전을 사용할 수 있습니다" 라는 문장이 이어집니다.
여기서 두 문서의 내용이 처음이자 유일하게 달라집니다.
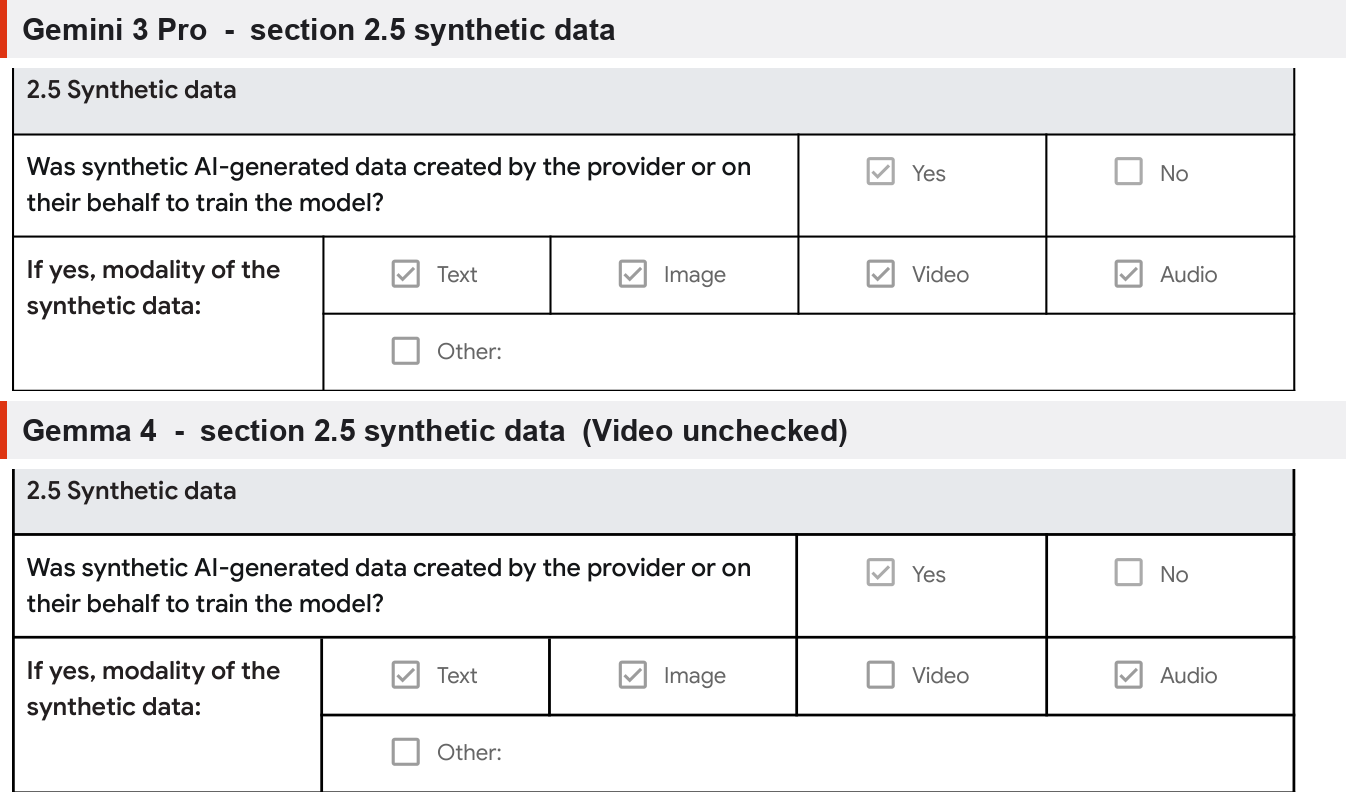
Gemini 3 Pro 리포트는 합성 데이터의 모달리티로 텍스트, 이미지, 비디오, 오디오 네 가지 전부에 체크했는데, Gemma 4 리포트는 비디오 칸이 비어 있습니다. 텍스트, 이미지, 오디오 세 가지만입니다. Gemma 4가 영상과 이미지를 입력으로 처리하면서도 합성 학습 데이터에서는 비디오를 쓰지 않았다는 뜻이 되고, 8쪽을 통틀어 두 모델의 학습 방식이 다르다고 적힌 유일한 부분입니다.
한편 Gemini 3 Pro 리포트가 "외부에 공개된 Gemini 3 계열 모델" 로 합성 데이터를 만들었다고 적은 것은 이 요약본이 다루는 계열과 같은 이름입니다. 계열 안에서 먼저 나온 모델이 뒤에 나온 모델의 학습 데이터를 만들었다는 서술로 읽히는데, 어느 시점의 어떤 모델인지는 특정되어 있지 않습니다. Gemma 4 쪽에서는 같은 문장이 훨씬 명확한 정보가 됩니다. 개방형 모델 Gemma 4가 폐쇄형 모델 Gemini 3의 출력으로 학습되었다 는 진술이기 때문입니다. Gemma 4 발표 블로그의 "Gemini 3와 동일한 세계 최고 수준의 연구와 기술로 만들어졌다" 는 문구가 규제 문서에서는 이렇게 구체적인 형태로 나타납니다.
설명서가 합성 데이터 절을 만든 이유가 앞서 언급한 경쟁 관점이었다는 점을 여기서 다시 짚어 둘 만합니다. 어떤 모델이 다른 모델의 증류로 만들어졌는지가 공개되면 시장의 종속 효과를 판단하는 재료가 된다는 것이었고, 이 칸은 그 목적에 맞게 실제로 작동한 셈입니다. 합성 데이터 생성에 관해서는 NeMo Data Designer처럼 이 작업을 전문으로 다루는 오픈소스 도구들도 참고할 만합니다.
2.6 기타 출처: 사업 과정에서 얻거나 직원이 만든 데이터
마지막 갈래는 앞의 다섯 범주에 들어가지 않는 데이터입니다. 양식은 오프라인 출처에서 수집한 데이터, 자체 디지털화한 매체, 제공자가 의뢰해 사람이 라벨링한 데이터셋, 강화학습을 위해 사람이 생성한 데이터 등을 예로 듭니다. 두 리포트는 예 로 답하고 다음과 같이 적었습니다.
"이 범주는 위에 기술된 범주에 속하지 않는 데이터 유형을 반영합니다. 여기에는 Google이 사업 운영 과정에서 취득하거나 생성하는 데이터셋, 또는 자사 인력으로부터 직접 얻는 데이터셋이 포함됩니다."
"자사 인력으로부터 직접(directly from its workforce)" 이라는 표현은 사람이 만든 라벨링 데이터와 선호 데이터를 가리키는 것으로 읽힙니다. 1.3절의 사후학습 서술에 등장한 인간 선호 데이터와 연결되는 대목입니다.
데이터 처리: 저작권 옵트아웃과 Google-Extended의 적용 범위
양식 3절은 데이터 처리 과정을 두 갈래로 묻습니다. 3.1절은 EU 디지털 단일시장 저작권 지침(Directive (EU) 2019/790) 제4조 제3항에 따라 표명된 텍스트 및 데이터 마이닝(Text and Data Mining, TDM) 예외에 대한 권리 유보를 어떻게 존중했는지, 3.2절은 불법 콘텐츠를 어떻게 걸러 냈는지입니다.
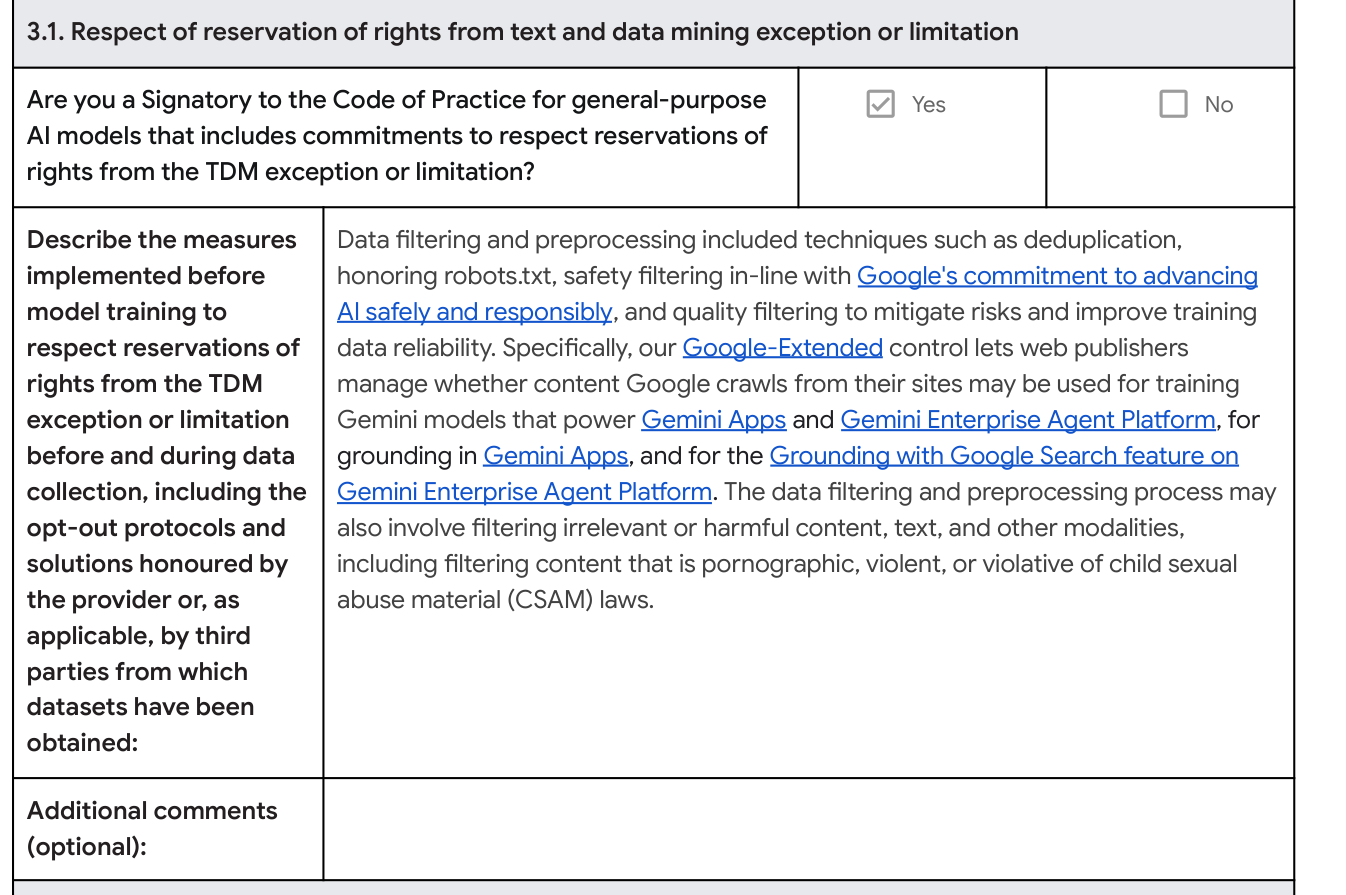
먼저 두 리포트 모두 범용 AI 모델 실천 규약(Code of Practice for general-purpose AI models) 서명자 여부에 예 로 체크했습니다. 이 규약은 TDM 예외에 대한 권리 유보 존중 약속을 포함하고 있어서, 서명 자체가 하나의 이행 신호입니다.
조치의 내용은 이렇게 서술되어 있습니다. 데이터 필터링과 전처리에 중복 제거(Deduplication), robots.txt 준수, Google의 안전하고 책임 있는 AI 발전 약속에 부합하는 안전 필터링, 그리고 위험 완화와 학습 데이터 신뢰성 향상을 위한 품질 필터링 같은 기법이 포함되었다는 것입니다.
그리고 이어지는 문장에서 Google-Extended를 구체적으로 언급합니다. 웹 게시자가 자신의 사이트에서 Google이 크롤링한 콘텐츠를 다음 용도에 사용해도 되는지 관리할 수 있게 하는 제어 수단이라는 설명입니다.
- Gemini 앱과 Gemini Enterprise Agent Platform을 구동하는 Gemini 모델의 학습
- Gemini 앱에서의 그라운딩(Grounding)
- Gemini Enterprise Agent Platform의 Grounding with Google Search 기능
여기서 읽어 둘 점이 있습니다. Google-Extended는 별도의 사용자 에이전트 문자열을 갖지 않고, 크롤링 자체는 기존 Google 사용자 에이전트로 수행되며 robots.txt의 토큰으로만 동작합니다. 즉 게시자는 크롤링을 막는 것이 아니라 크롤링된 콘텐츠의 사용처를 제한 하는 것이고, Google 문서도 Google-Extended가 Google 검색 포함 여부에 영향을 주지 않으며 검색 순위 신호로 쓰이지 않는다고 명시합니다. 그리고 위 세 줄에 열거된 적용 범위는 Gemini 앱과 Gemini Enterprise Agent Platform이며, 검색 자체의 AI 기능은 그 열거에 포함되어 있지 않습니다. 게시자가 이 문서를 근거로 옵트아웃 범위를 판단할 때는 열거된 항목이 곧 범위라는 점을 유의해야 합니다.
3.2절 불법 콘텐츠 제거 조치는 3.1절 서술을 다시 인용하는 형태입니다. 안전 필터링 과정에서 무관하거나 유해한 콘텐츠, 텍스트 및 기타 모달리티를 걸러 낼 수 있으며, 여기에는 음란물, 폭력물, 아동 성착취물(CSAM) 관련 법에 저촉되는 콘텐츠 필터링이 포함된다는 내용입니다. 그리고 문서에 놓인 선택 입력 칸은 여덟 곳의 "추가 의견(선택)" 과 3.3절의 기타 정보 칸까지 모두 아홉 곳인데, 두 리포트 모두 아홉 곳이 전부 비어 있습니다. 양식이 자발적 추가 공개를 위해 마련해 둔 자리를 한 번도 쓰지 않았습니다.
mixture는 왜 나오지 않는가: 양식이 묻지 않은 것
학습 데이터 이야기에서 개발자가 가장 궁금해하는 것은 보통 혼합 비율(Data Mixture) 입니다. 웹 텍스트와 코드와 수학 데이터의 비중이 각각 얼마인지, 어느 단계에서 어떤 데이터의 가중치를 올렸는지 같은 정보입니다. 두 리포트에는 그런 숫자가 전혀 없습니다.
이것은 Google이 답변을 생략한 것이 아니라 양식이 요구하지 않는 항목 입니다. 설명서 22항이 명시적으로 그렇게 적었습니다.
"양식은 데이터 출처의 정확한 혼합과 구성의 공개를 요구하지 않으며, 모달리티별 학습 데이터 규모에 관한 상위 수준 정보(세 가지 매우 광범위한 구간 중 선택)와 모든 출처에 걸친 집계값만을 요구한다."
"The Template does not require disclosure of the exact mix and composition of data sources, but only high-level information about the training data size per modality (selection amongst three very broad ranges) and aggregated across all sources."
설명서 17항부터 20항이 그 이유를 설명합니다. AI Act 전문 107조가 요구한 균형, 즉 정당한 이익을 가진 당사자의 권리 행사를 돕는 것과 영업비밀 및 기밀 사업 정보를 보호하는 것 사이의 균형을 위원회가 항목별로 조정했다는 것입니다. 그 조정의 결과가 출처마다 다른 상세 수준입니다. 라이선스 데이터는 권리자가 계약 당사자이므로 최소한만, 제3자 비공개 데이터는 공개적으로 알려진 경우에만 이름을, 공개 데이터셋은 공개된 정보라는 성격상 대규모 데이터셋의 식별자까지, 그리고 크롤링 데이터는 도메인 이름 목록까지 요구하는 구조입니다.
정리하면 두 리포트에서 비어 있는 칸은 성격이 둘로 나뉩니다.
| 알 수 없는 것 | 이유 |
|---|---|
| 데이터 혼합 비율, 커리큘럼 순서, 토큰화 방식, 데이터별 가중치 | 양식이 요구하지 않음 (설명서 22항) |
| 상용 라이선스 계약의 상대방과 규모 | 양식이 모달리티 체크만 요구함 (설명서 19항) |
| 학습에 쓴 개별 저작물과 작품 단위 정보 | 양식이 요구하지 않음. AI Act 전문 108조에 따라 AI Office도 작품 단위 심사를 하지 않음 |
| 대규모 공개 데이터셋의 이름과 링크 | 양식이 요구했으나 채워지지 않음 |
| 크롤링 도메인 상위 10퍼센트 목록 | 양식이 요구했으나 채워지지 않음 |
| 크롤링 데이터 수집 기간의 시작 시점 | 양식이 형식까지 지정했으나 채워지지 않음 |
위 표에서 굵게 표시한 세 줄이 이 두 문서를 평가할 때 실제로 쟁점이 되는 부분입니다. 나머지는 규제 설계상 처음부터 공개 대상이 아니었습니다.
같은 회사의 모델 카드와 겹쳐 보면: 규제가 새로 끌어낸 것은 무엇인가
여기까지 오면 따라오는 질문이 있습니다. 이 규제 문서가 없었다면 몰랐을 내용은 무엇인가 하는 것입니다. Google은 EU 요약본을 내기 전부터 Gemini 3 Pro 모델 카드를 공개해 왔습니다. 이 카드는 2025년 11월 모델 출시와 함께 나와 2026년 5월에 마지막으로 갱신되었고, 서두에 "이 모델 카드는 이전 모델 카드들보다 Gemini 3 계열에 관한 더 많은 필수 정보를 담고 있다" 고 적혀 있습니다. EU 요약본에 찍힌 2026년 7월 2일보다 두 달 앞섭니다.
두 문서를 문장 단위로 대조해 보면 겹치는 부분이 상당합니다. 아래는 모델 카드의 Model Data 절과 EU 요약본 1.3절의 같은 칸입니다.
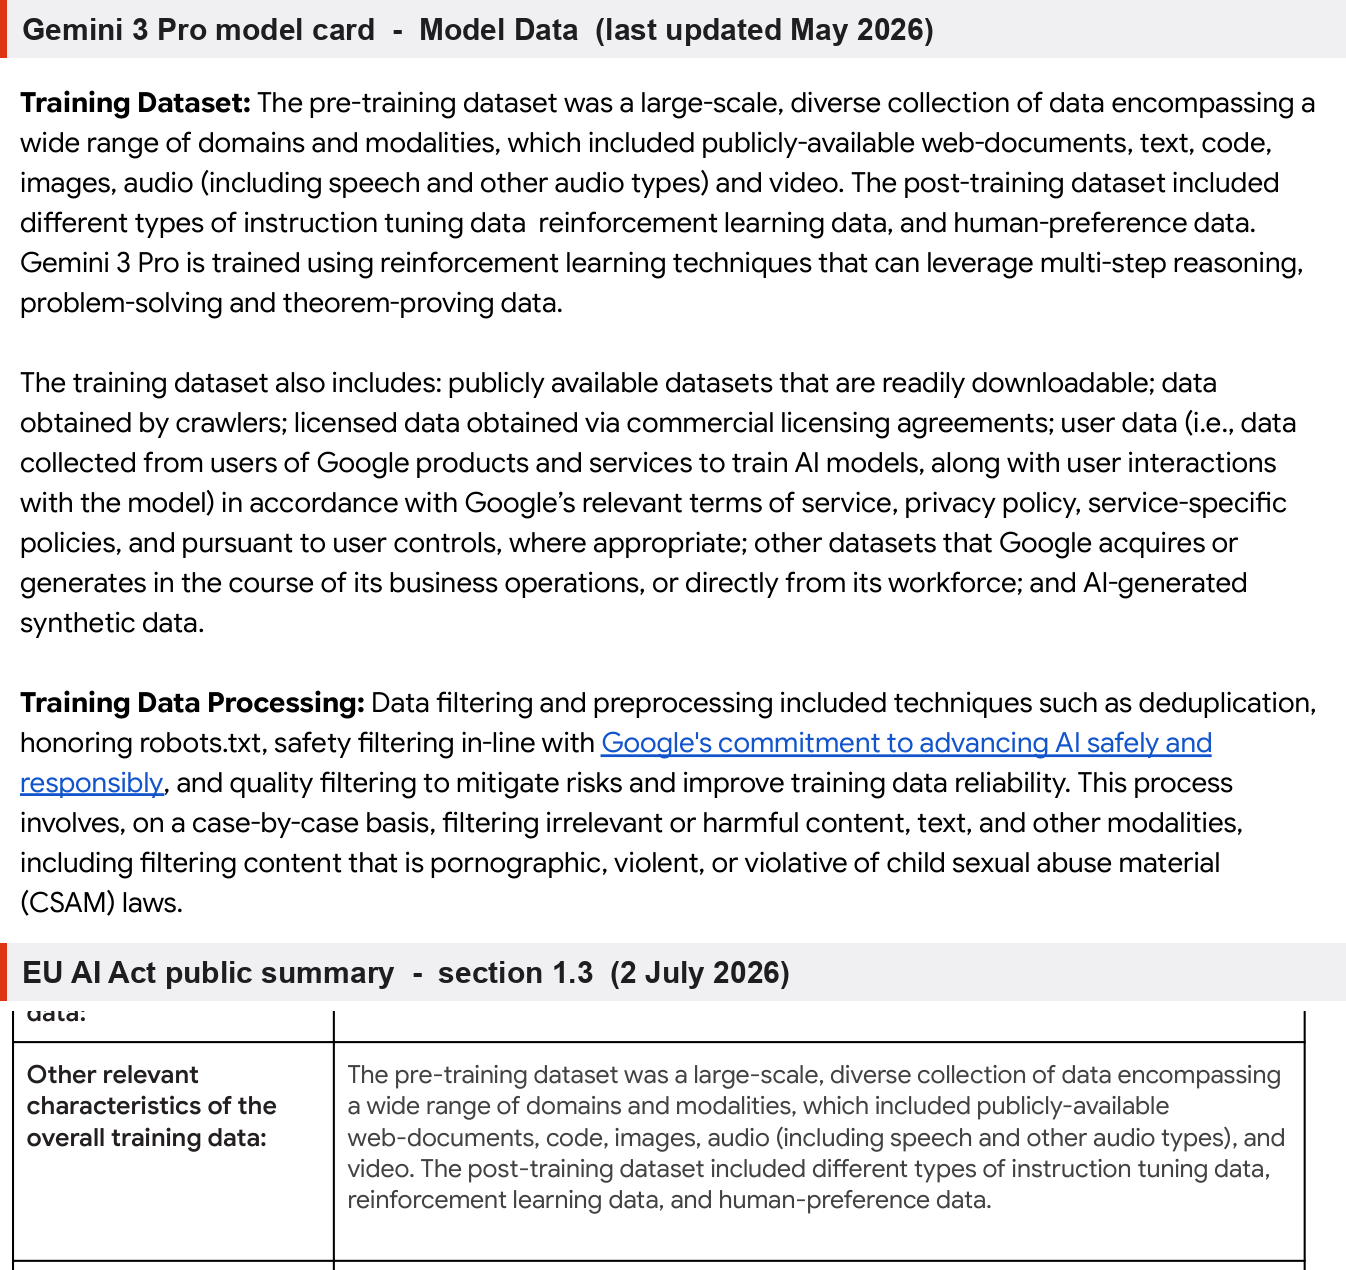
사전학습과 사후학습 데이터를 설명하는 문장, 데이터 필터링을 설명하는 문장(중복 제거, robots.txt 준수, 안전 필터링, 품질 필터링), 음란물과 폭력물과 CSAM 필터링 문장, 사업 운영 과정에서 취득하거나 인력에게서 얻은 데이터를 가리키는 문장은 모델 카드에 있던 표현이 EU 요약본에 그대로 옮겨져 있습니다. 데이터 출처 여섯 갈래도 모델 카드에는 이미 산문 한 문단으로 열거되어 있었고, EU 요약본은 그것을 체크박스 형태로 옮긴 셈입니다.
그러면 규제 문서가 새로 더한 것은 무엇인지 항목별로 정리하면 다음과 같습니다.
| 항목 | 모델 카드 (2026년 5월) | EU 요약본 (2026년 7월) |
|---|---|---|
| 사전학습, 사후학습 데이터 서술 | 있음 | 같은 문장 |
| 데이터 필터링 서술 | 있음 | 같은 문장 |
| 데이터 출처 여섯 갈래 | 산문으로 열거 | 체크박스로 표시 |
| 지식 컷오프 | 2025년 1월 | 2025년 1월 |
| 강화학습 데이터의 성격 | 있음 (다단계 추론, 문제 해결, 정리 증명) | 없음 |
| 모달리티별 데이터 규모 구간 | 없음 | 있음 |
| 출처별 모달리티 구분 | 없음 | 있음 |
| 합성 데이터 생성 모델 이름 | 없음 (AI 생성 합성 데이터라고만) | 있음 (Gemini 3 계열) |
| 공개적으로 알려진 제3자 데이터셋 유무 | 없음 | 있음 (없다고 진술) |
| 제3자 비공개 데이터셋의 주제 영역 | 없음 | 있음 (교육 자료, 과학적 추론, 수학) |
| 실천 규약 서명 여부 | 없음 | 있음 |
| Google-Extended의 적용 범위 | 없음 | 있음 |
위 표를 통해 규제가 실제로 끌어낸 항목이 일곱 개라는 것을 알 수 있습니다. 그중 값이 큰 것은 모달리티별 규모 구간과 합성 데이터 생성 모델 이름 두 가지입니다. 반대 방향의 항목도 하나 있습니다. 강화학습 데이터의 성격은 모델 카드에만 있고 규제 문서에는 빠졌습니다. 모델 카드는 Gemini 3 Pro가 "다단계 추론, 문제 해결, 정리 증명 데이터를 활용할 수 있는 강화학습 기법으로 학습되었다" 고 적었는데, EU 요약본의 사후학습 서술은 "여러 유형의 지시 미세조정 데이터, 강화학습 데이터, 인간 선호 데이터" 에서 멈춥니다.
Gemma 쪽은 격차가 더 벌어집니다. Gemma 4 모델 카드는 사전학습 데이터를 웹 문서, 코드, 수학, 이미지 네 갈래로 나누고 각각이 왜 필요한지까지 설명하며, 웹 문서가 140개가 넘는 언어를 담고 있다고 적습니다. 데이터 전처리 절에는 CSAM 필터링과 함께 "특정 개인정보와 그 밖의 민감 데이터를 학습 세트에서 걸러 내는 자동화 기법" 을 적용했다는 항목이 따로 있습니다. EU 요약본에는 언어 개수도 개인정보 필터링 언급도 없습니다. 수학은 EU 요약본에도 나오지만, 사전학습 구성요소가 아니라 2.2.2절에서 제3자로부터 확보한 비공개 데이터셋의 주제 영역으로 등장합니다.
이 대조가 규제를 무의미하게 만드는 것은 아닙니다. 모델 카드는 자발적 문서라 형식이 회사마다 다르고 언제든 내용이 바뀌거나 내려갈 수 있는 반면, 공개 요약은 정해진 양식에 정해진 항목을 채워야 하고 갱신 주기와 집행 대상이 따라붙습니다. 다만 이번 두 건에 한정하면, 규제가 새로 끌어낸 것은 규모 구간과 몇 개의 체크박스이고 서술 부분은 이미 있던 문서에서 옮겨 온 것이라는 점은 문장 대조로 확인됩니다.
제3자 평가: 트리니티 칼리지 더블린의 채점표
이 판단이 필자의 인상만은 아닙니다. 아일랜드 트리니티 칼리지 더블린의 ADAPT Centre 소속 AI Accountability Lab이 제53조 제1항 (d)호 공개 요약의 품질을 정량 평가하는 GPAI Training Transparency 프로젝트를 운영하고 있고, Gemini 3 Pro와 Gemma 4 요약본이 모두 평가 대상에 들어 있습니다. 평가 방법론은 Dick A. H. Blankvoort, Harshvardhan J. Pandit(ADAPT Centre), Maximilian Gahntz(Mozilla Foundation)이 2026년 ACM FAccT 학회에 발표한 논문 Quality Assessment of Public Summary of Training Content for GPAI models required by AI Act Article 53(1)(d)에 정리되어 있습니다.
평가 방법론은 소프트웨어 문서 품질 관리 기법을 규제 문서에 적용한 것으로, 6개 지표를 두 축으로 묶습니다. 명확성(Clarity), 완전성(Completeness), 일관성(Consistency), 정확성(Correctness)을 합쳐 투명성(Transparency) 점수를, 접근성(Accessibility)과 이해가능성(Comprehension)을 합쳐 유용성(Usefulness) 점수를 냅니다. 등급은 95점 이상 A+부터 50점 이상 C, 40점 이상 D+ 순으로 내려갑니다.
두 리포트의 점수는 다음과 같습니다.
| 평가 대상 | 투명성 | 유용성 |
|---|---|---|
| Gemini 3 Pro | 59.5% (C) | 53.6% (C) |
| Gemma 4 | 59.54% (C) | 53.6% (C) |
두 점수가 소수점까지 거의 같은 것은 앞에서 본 대로 두 문서가 사실상 같은 문서이기 때문입니다. C 등급은 이 척도에서 marginal, 즉 최저 통과선 근처에 해당합니다.
절별 점수를 보면 감점의 위치가 명확합니다. 공개 데이터셋 절(Public Data Sources)에서 투명성 6.92퍼센트, 유용성 0퍼센트로 사실상 바닥이고, 크롤링 데이터 절도 접근성 항목이 0퍼센트입니다. 반대로 데이터 처리 절은 투명성 90퍼센트로 높습니다. 평가팀이 남긴 메모는 감점 사유를 이렇게 요약합니다.
"요약본은 양식의 구조를 따르고 있으며 Gemma 4 계열의 학습 데이터 요약과 최소한으로만 다릅니다. 감점은 주로 더 상세한 정보가 요구되는 곳에 상위 수준 정보를 제공한 데서 발생했습니다. 예를 들어 대규모 공개 데이터 출처 목록을 제공해야 하는 항목에서 제공자는 대신 '우리의 공개 데이터셋에는 교육, 정부, 법률, 연구 분야 등 다양한 분야에 걸친 데이터가 포함되며, 폭넓은 매체 유형과 언어로 구성됩니다'라고 답했습니다."
이 프로젝트는 현재까지 44건의 공개 요약을 찾아 평가했고, 그와 별개로 공개 요약이 필요한데도 찾을 수 없었던 모델 19건 을 목록으로 정리해 두었습니다. 그 목록에는 Google의 Veo 3.1도 들어 있습니다. 평가팀은 이 작업에서 가장 어려웠던 점이 공개 요약을 찾는 일 자체였다고 적었는데, 요약을 어디에 어떤 형식으로 두어야 하는지에 관한 일관된 관행이 없기 때문입니다. 실제로 Google의 두 문서도 투명성 보고서 사이트의 규제 보고 섹션에서 드롭다운을 두 번 거쳐야 PDF 링크에 닿습니다.
한 가지 균형을 위해 덧붙이면, 이 평가에서 Google은 하위권이 아닙니다. 같은 표에서 Anthropic과 Meta의 여러 모델은 유용성이 D+로 더 낮고, Microsoft의 Phi-4는 투명성 D에 유용성 F로 최하위입니다. 반대로 Swiss AI Initiative의 Apertus가 투명성 A에 유용성 A+, Hugging Face의 SmolLM3-3B가 양쪽 모두 B+로 상위에 있습니다. 상세한 공개가 기술적으로 불가능해서 다들 못 하는 것이 아니라, 공개 수준이 제공자의 선택에 따라 크게 달라집니다. 학습 데이터를 처음부터 투명하게 설계한 사례로는 네덜란드의 GPT-NL 프로젝트도 참고할 만합니다.
개발자와 연구자에게 남는 것
이 두 문서에서 실무적으로 건질 것과 건질 수 없는 것을 정리하면 이렇습니다.
데이터 규모의 하한선이 문서로 확정되었습니다. 텍스트 10조 토큰 초과, 이미지 10억 장 초과, 오디오와 비디오 각각 100만 시간 초과라는 값은 추정이 아니라 제공자가 규제기관에 제출한 진술입니다. 자체 모델의 데이터 예산을 잡거나 스케일링 논의의 기준점을 삼을 때 인용할 수 있는 숫자입니다. 특히 온디바이스급 개방형 모델인 Gemma 4가 프런티어 모델과 같은 구간에 있다는 사실은, 소형 모델의 품질이 파라미터가 아니라 학습 데이터와 학습 절차에서 나온다는 최근 흐름과 맞닿아 있습니다.
개방형 모델의 재현 가능성은 이 문서로도 확보되지 않습니다. Gemma 4는 Apache 2.0으로 가중치를 받아 상업적으로도 자유롭게 쓸 수 있지만, 같은 데이터로 다시 학습해 볼 수는 없습니다. 데이터셋 이름이 없고, 크롤링 도메인이 없고, 혼합 비율이 없습니다. 여기에 더해 합성 데이터가 폐쇄형 Gemini 3 계열의 출력이라는 사실이 문서에 적혀 있으므로, 학습 파이프라인의 한 축은 원리적으로 외부에서 복제할 수 없습니다. 개방형 가중치와 개방형 학습 데이터가 다른 축이라는 점이 이 문서에서 분명해집니다.
웹 게시자와 저작권자 입장에서는 아직 실효적 도구가 부족합니다. AI Act가 도메인 목록을 요구한 목적이 권리자의 권리 행사를 돕는 것이었는데, 목록이 없으면 권리자는 자기 도메인이 학습에 쓰였는지 확인할 방법이 없습니다. 남은 경로는 설명서가 자발적 조치로 권고한 요청 기반 확인 절차인데, 두 리포트에는 그런 절차에 관한 언급이 없습니다. 실무적으로는 Google-Extended를 robots.txt에 명시해 사전에 옵트아웃하는 것이 현재로서 가장 확실한 방법이고, 이 방식은 GPTBot을 비롯한 다른 학습용 크롤러에도 각각 따로 적용해야 합니다.
국내 데이터 실무에도 참고할 지점이 있습니다. 한국에는 아직 학습 데이터 공개를 강제하는 법이 없지만, EU 시장에 모델이나 서비스를 내놓는 국내 기업에는 이 의무가 그대로 적용됩니다. 양식이 요구하는 여섯 갈래 출처 분류와 대규모 데이터셋 3퍼센트 기준, 도메인 상위 10퍼센트 기준은 지금부터 데이터 수집 이력을 어떤 단위로 남겨 두어야 하는지를 알려 주는 체크리스트이기도 합니다. 크롤링 시점의 도메인별 바이트 수를 기록해 두지 않으면 나중에 상위 10퍼센트를 계산할 수 없습니다. 데이터 구축 절차 자체에 관해서는 한국지능정보사회진흥원(NIA)의 AI 학습데이터 구축 안내서가, 규제 준수 여부를 자동 평가하는 접근으로는 COMPL-AI가 함께 볼 만합니다.
마지막으로 이 문서의 성격 자체를 기억해 둘 필요가 있습니다. 학습 콘텐츠 공개 요약은 모델을 이해하기 위한 문서가 아니라 권리를 행사하기 위한 문서입니다. 기술적 이해가 목적이라면 앞에서 대조한 모델 카드가 더 낫고, 데이터 파이프라인을 자발적으로 상세히 공개한 Microsoft의 MAI-Thinking-1 기술 보고서와 같은 자료는 그보다도 훨씬 많은 것을 알려 줍니다. 규제가 만들어 낸 문서가 자발적으로 공개된 문서보다 정보량이 적다는 것이 지금 상태입니다. AI Office의 집행 권한은 2026년 8월 2일부터 개시되었고, 위원회는 설명서에서 실무 경험과 기술 발전에 따라 양식과 설명서를 재검토하겠다고 밝혔습니다.
 Gemini 3 Pro 계열 학습 콘텐츠 공개 요약 (영문 PDF, 8쪽)
Gemma 4 계열 학습 콘텐츠 공개 요약 (영문 PDF, 8쪽)
 EU AI Office 학습 콘텐츠 공개 요약 설명서 및 양식
EU AI Act 제53조 원문 (범용 AI 모델 제공자의 의무)
Gemini 3 Pro 모델 카드 (영문 PDF)
 Google 투명성 보고서 규제 보고 섹션
 AI Accountability Lab의 GPAI 학습 투명성 평가
라이선스
두 학습 콘텐츠 공개 요약은 Google Ireland Limited가 EU AI Act 제53조 제1항 (d)호에 따라 공개한 문서로, Google 투명성 보고서를 통해 누구나 내려받아 열람할 수 있습니다. EU AI Office의 설명서와 양식은 유럽 위원회 문서로서 위원회 문서 재사용 결정(2011/833/EU)에 따라 출처를 표시하면 재사용할 수 있습니다.
더 읽어보기
-
Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개
-
Google, Gemini 3에 이은 Gemini 3 Deep Think 및 Gemini 3.1 Pro 출시
-
네덜란드의 소버린 AI, GPT-NL: 처음부터 학습한 국가 언어모델 진행 보고서 [네덜란드어/PDF/24p]
-
MAI-Thinking-1 기술 보고서: 데이터 파이프라인부터 RL 인프라까지, 프런티어 모델 학습의 전 과정을 해부한 '힐 클라이밍 머신' (feat. Microsoft AI)
-
Alignment Whack-a-Mole: LLM 파인튜닝이 정렬을 우회하여 저작권 도서의 그대로 기억을 활성화하는 메커니즘에 대한 연구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글이 유용하셨다면 아래 쪽 좋아요
 를 눌러주세요. 파이토치 한국 사용자 모임
 이 새로운 소식을 정리하고 공유하는 데 힘이 됩니다!
