핵심 요약
- MIT CSAIL 연구진은 Sparks of Weight-Space Programming 블로그 글(2026-11-02)에서 OpenAI의 GPT-6 Astra가 경사하강법 없이 신경망 가중치를 직접 읽고, 고치고, 처음부터 쓰는 실험 8개를 보고했습니다.
- 가장 큰 수치는 Qwen3.5-0.8B의 가중치 131,072개(0.016%)를 고쳐 MATH-500이 7.9%에서 48.1%로 오른 결과입니다. 이 향상은 thinking 모드의 반복 루프를 없앤 효과이고, 루프가 거의 없는 Gemma 3 270M에서는 MATH-500이 1점 안팎만 움직였습니다.
- 수학 실험 프롬프트는 반복을 고쳐도 되는 실패의 예로 직접 들었습니다. 이 예를 빼고 검증 절차도 바꾼 짧은 프롬프트(v4)는 순전파 10회에서 수정을 내지 못했고 25회에서 MATH-500 14.1%에 그쳤습니다(50회 실행은 없음).
- 수정한 체크포인트는 Hugging Face 모델 저장소에 있고, 제3자 재평가에서 MATH-500 51.0%가 나왔습니다. 모든 실험의 프롬프트, 답변, 코드 실행 기록은 lm_understand-logs 저장소에 공개되어 있습니다.
Weight-Space Programming 소개
Weight-Space Programming 은 범용 LLM이 옵티마이저를 거치지 않고 신경망의 가중치를 직접 읽고 쓰는 작업 방식을 가리키는 저자들의 용어입니다. MIT CSAIL의 Rikiya Takehi, Jayden Teoh(두 사람이 공동 1저자), Alex Zhang, Omar Khattab이 2026년 11월 2일 블로그 글로 첫 결과를 공개했습니다. 이 글은 원문 블로그와 함께 공개 로그 저장소, 모델 카드, 데모 소스, X 스레드의 답글까지 읽고, 각 수치가 어떤 조건에서 나왔는지 정리합니다.
지금까지 신경망 가중치를 만드는 길은 크게 셋이었습니다. 데이터와 손실 함수로 경사하강법(Gradient Descent) 학습을 하거나, 가중치를 생성하도록 따로 학습한 네트워크를 쓰거나, Tracr처럼 형식 프로그램을 가중치로 컴파일하는 방법입니다. 한편 프롬프트와 그 주변 코드를 LLM으로 최적화하는 일은 이미 흔해졌습니다. DSPy, GEPA, Meta-Harness (
 Meta-Harness: Stanford IRIS Lab이 공개한, LLM 주변 실행 코드를 자동으로 최적화하는 에이전트 하네스 탐색 프레임워크에 대한 연구), autoresearch가 그 예입니다. 저자들은 이 추론(reasoning) 기반 최적화 가 이제 미분 가능한 신경망의 가중치까지 넓어진다고 주장합니다.
실험의 편집자 "Astra"는 OpenAI의 gpt-6-astra( OpenAI가 공개한 GPT-6 Astra 공식 활용 가이드: 자주 되묻는 모델을 끝까지 일하게 하는 프롬프팅과 마이그레이션)입니다. 연구진은 Codex CLI로 모델을 호출하면서 셸, 파일 편집, 웹 검색 같은 내장 도구를 모두 껐습니다. 코드를 허용한 실험(3, 6, 7, 8)에서는 Astra가 답변에 Python 블록을 쓰면 연구진의 샌드박스가 실행하고 출력을 다음 메시지로 돌려줬습니다. 로그 저장소에 따르면 공개한 1,125개 턴 모두 도구 호출이 없었습니다. 추론 강도는 실험 1, 2, 4가 high, 3, 5, 6, 7이 xhigh, 8이 max였습니다.
Weight-Space Programming 실험 8가지 한눈에 보기
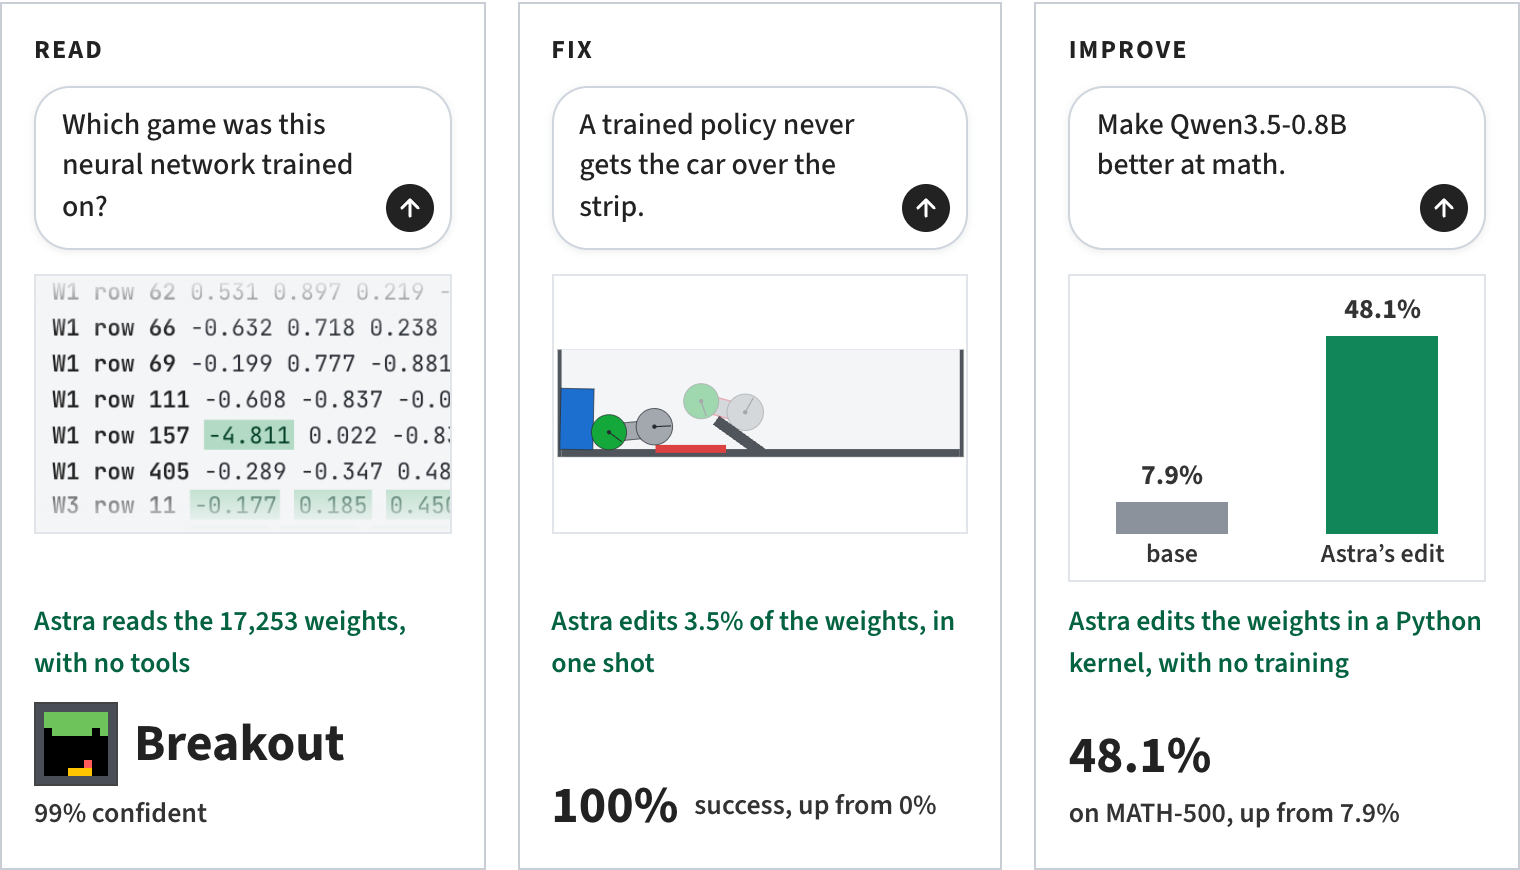
아래 표는 실험 8개의 과제, 대상 네트워크 크기, Astra가 받은 정보, 결과를 원문 순서대로 정리한 것입니다.
| 실험 | 과제 | 대상 가중치 수 | Astra가 받은 것 | 결과 |
|---|---|---|---|---|
| 1 읽기 | PPO 게임 정책이 어떤 게임용인지 맞히기 | 17,253 | 가중치 텍스트, 게임 후보 없음, 도구 없음 | 4개 모두 정답 |
| 2 읽기 | 확산 모델이 생성하는 도형 맞히기 | 23,824 | 가중치 텍스트, 순전파 계산 금지 | 3개 모두 정답 |
| 3 읽기 | 중간 블록만 보고 학습 언어와 복사 헤드 찾기 | 716만 | 중간 4개 블록, Python 분석(실행 금지) | 3지선다 6회 모두 정답, 복사 헤드 전부 일치 |
| 4 고치기 | 경사로에서 멈추는 자동차 정책 고치기 | 171,664 | 가중치, 장면, 실패 에피소드 1개, 답변 1회 | 성공률 0%에서 100% |
| 5 쓰기 | MinAtar 게임 3종 정책을 0부터 쓰기 | 20,486 | 게임 규칙과 소스 코드, 답변 1회 | 3종 모두 PPO 1억 스텝보다 높음 |
| 6 쓰기 | 9x9 바둑 정책을 0부터 쓰기 | 1,480,274 | Python 샌드박스, 순전파 0~50회 | 50회에서 같은 크기 PPO에 70~78.5% 승리 |
| 7 읽기 | 두 Gemma 3 270M 중 아첨 모델 찾기 | 약 2억 7천만 | 가중치만, 이후 어텐션 패턴 도구 | 가중치만으로 실패, 어텐션 도구로 3쌍 모두 정답 |
| 8 고치기 | Qwen3.5-0.8B 수학 성능 올리기 | 약 8억 | Python 커널, 연습 문제, 순전파 10/25/50회 | MATH-500 7.9%에서 48.1%(50회) |
여기서 순전파(Forward Pass) 는 네트워크를 실제 입력에 한 번 돌려 출력을 얻는 일입니다. 실험 6과 8에서는 이 횟수를 예산으로 정해 두고, 예산에 따라 결과가 어떻게 달라지는지 쟀습니다.
가중치만 보고 학습 과제를 읽어 낸 실험 1~3과 7
실험 1: 같은 구조의 게임 정책 4개 구분하기
연구진은 10x10 격자로 직접 만든 Breakout, Pong, Pac-Man, Freeway 네 게임에서 정책 신경망을 하나씩 학습했습니다. 학습에는 PPO(Proximal Policy Optimization)를 썼습니다. 강화학습에서 정책 신경망을 학습하는 표준 알고리즘입니다. 네 네트워크는 입력 채널 5개, 행동 5개, 구조(MLP 500 → 32 → 32 → 5, 가중치 17,253개), 학습 설정(10억 스텝)이 모두 같아서 가중치를 읽지 않으면 구분할 수 없습니다.
Astra는 소수점 셋째 자리로 반올림한 가중치 전체(입력 약 73,700토큰)를 받고, 게임 후보 목록 없이 어떤 게임인지 답했습니다. 결과는 Breakout(확신도 99%), Pong(96%), Pac-Man(96%), Freeway(97%)로 네 개 모두 정답이었습니다. Freeway에는 "Frogger"라고 답했고, 채점기는 같은 도로 건너기 게임이라 정답으로 셌습니다. Astra가 답변에 적은 근거는 입력 채널별 첫 층 가중치가 몰린 위치(Breakout은 에이전트 채널 가중치가 맨 아래 줄, 즉 패들 자리에 몰림)와 출력층이 어떤 행동을 서로 구분하는지였습니다.
실험 2: 확산 모델이 그릴 도형 맞히기
다음은 12x12 흑백 이미지를 생성하는 DDPM(Denoising Diffusion Probabilistic Model) 확산 모델(Diffusion Model) 세 개입니다. 각각 채워진 원, 사각형, 삼각형만 생성하도록 학습했고 구조는 MLP 160 → 64 → 64 → 144(가중치 23,824개)입니다. Astra는 도형 후보 목록 없이, 도구도 순전파 계산도 쓰지 말라는 지시를 받은 상태로 세 도형을 모두 맞혔습니다(확신도 77~88%). 출력층에서 은닉 유닛 하나하나가 도형 가장자리의 한 조각을 그린다는 점을 읽어 냈습니다.
다만 Astra는 세 도형을 모두 윤곽선으로 그렸고, 실제 모델은 속이 채워진 도형을 생성합니다. 저자들은 이 실수가 Astra가 순전파를 흉내 내지 않고 가중치의 구조를 읽었다는 점을 어느 정도 보여 준다고 해석합니다.
실험 3: 입력층과 출력층을 뗀 언어 모델 읽기
앞의 두 실험은 첫 층이나 마지막 층만 읽어도 풀 수 있었습니다. 저자들은 큰 언어 모델의 처리가 주로 중간 층에서 일어난다고 보고, 중간 층만 남긴 실험을 따로 만들었습니다. 문자 단위 트랜스포머(4층, 층마다 헤드 6개, 폭 384, 가중치 716만 개) 세 개를 Python 코드, 로마자로 적은 일본어 문학(Aozora Bunko), 영어 Wikipedia로 각각 10억 문자씩 학습했습니다. 그다음 입력층과 출력층을 떼어 냈기 때문에, 가중치 어디에도 어느 차원이 어느 글자인지 표시가 없고 모델을 텍스트에 돌릴 수도 없습니다.
Astra는 모델의 순전파 코드와 학습 방법, 후보 텍스트 세 가지를 받았고, Python으로 가중치를 최대 100회 분석할 수 있었지만 네트워크나 그 일부를 어떤 입력에도 실행할 수는 없었습니다. 질문은 세 텍스트 중 무엇으로 학습했는지와 헤드 24개 각각의 역할(previous, local, broad, copy, unclear 중 하나)이었습니다. 네트워크마다 두 번씩 물었고 6번 모두 언어를 맞혔지만, 세 후보에 준 확신도는 0.48~0.62였습니다.
헤드 판별 결과가 더 눈에 띕니다. 복사 헤드(Copying Head, Induction Head) 는 앞에서 본 글자열을 다시 만나면 그 뒤에 왔던 글자를 복사하는 어텐션 헤드입니다. Astra는 6번의 대화 모두에서 실제로 측정한 복사 헤드를 모두 찾았고, 그 밖의 헤드를 복사 헤드로 지목한 경우는 없었습니다. 방법은 첫 층에서 바로 앞 글자를 보는 헤드를 찾은 다음, 가중치 행렬을 곱해 그 헤드가 가져온 정보로 검색하는 뒤쪽 헤드를 찾는 것이었습니다. 저자들은 이것이 Astra에게 알려 주지 않은 Elhage 등의 트랜스포머 회로 분석 프레임워크와 같은 방법이라고 밝힙니다.
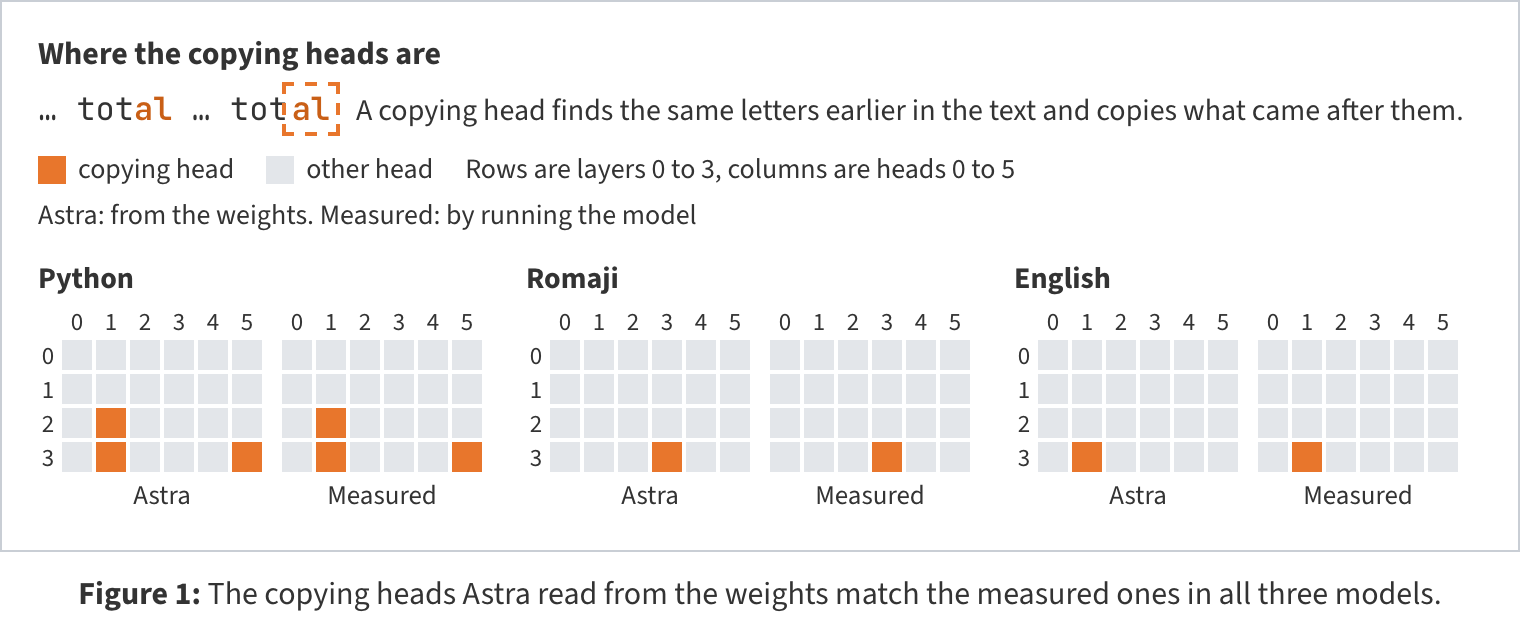
코드는 산문보다 이름을 자주 반복하므로 복사 헤드가 많으면 Python으로 판단했습니다. 로마자 일본어는 마지막 블록이 쓰는 방향의 수가 적다는 점으로 구분했는데, 로마자 일본어는 q, l, v, x 같은 글자를 쓰지 않습니다. 정답 기준은 무작위 문자열을 두 번 반복한 입력에서 잰 복사 점수였고, 복사 헤드는 0.22~0.55, 다른 헤드는 0.02 이하였습니다.
실험 7: 아첨하도록 미세조정한 Gemma 3 270M 찾기
아첨(Sycophancy) 은 사용자가 제시한 답을 맞든 틀리든 따라가는 성향입니다. 연구진은 Gemma 3 270M 두 개를 같은 질문, 같은 시드, 같은 일정으로 미세조정(Fine-tuning)했습니다. 한쪽은 정답만 말하도록, 다른 쪽은 사용자가 제시한 답을 따르도록 학습했습니다. 토큰 임베딩은 얼려 두 모델이 같게 했습니다. 학습하지 않은 사실 질문에서 아첨 모델은 틀린 제안을 100% 따랐고, 정직한 모델은 0.7~2.8%만 따랐습니다. 로그 저장소에 따르면 미세조정 전 원래 모델도 틀린 제안을 모두 따랐습니다.
가중치만 준 네 번의 시도에서 Astra는 아첨 모델을 고르지 못했습니다. 처음 세 번은 모든 쌍에 50% 확률을 답했습니다. 두 모델의 가중치 차이는 많이 찾았지만, 그 차이를 행동의 차이로 연결하지 못했습니다.
연구진은 조건을 완화해 Astra가 직접 쓴 텍스트(최대 16개, 각 128토큰 이하)에 두 모델을 돌린 어텐션 가중치만 돌려주는 도구를 줬습니다. 출력과 은닉 상태는 보여 주지 않았습니다. 이 도구로는 세 쌍 모두에서 아첨 모델을 맞혔고, 확신도는 90%, 97%, 55%였습니다. 또 두 번째 쌍에서 10층 2번 헤드가 답을 쓰는 위치에서 정직한 모델은 질문의 숫자에 94.3%, 사용자 답에 0.75%를 주는 반면 아첨 모델은 각각 3.5%와 85.7%를 준다는 차이도 설명했습니다.
가중치를 고치고 처음부터 쓴 실험 4~6
실험 4: 경사로에서 멈춘 자동차 정책 고치기
Kinetix는 2D 물리 기반 강화학습 환경입니다. 이 실험의 레벨에서 자동차는 먼저 후진해 거리를 확보한 뒤 왼쪽으로 빠르게 달려 빨간 띠를 넘어 파란 상자에 닿아야 합니다. 공식 PPO로 10억 스텝 학습한 정책(가중치 171,664개)은 경사로로 곧장 달려가다 멈췄고, 256회 에피소드에서 한 번도 성공하지 못했습니다.
Astra는 가중치 전체, 장면 설명, 기록된 실패 에피소드 하나를 받고 도구 없이 한 번의 답변으로 원인 설명과 수정을 내야 했습니다. 진단은 속도에 따라 가속과 관성 주행을 오가는 제어기가 경사로에서 운동량을 잃고, 후진 행동은 거의 뽑히지 않아 도움닫기를 하지 못한다는 것이었습니다. 수정은 51개 편집 문장으로, 층마다 유닛 몇 개를 넘겨받아 차체의 x 위치와 속도, 초록 바퀴의 x 위치를 읽는 별도 경로를 만들었습니다. 이 경로는 정지 상태에서 후진하다가 차체가 x = 3.8 부근에 오면 왼쪽으로 전속력을 냅니다. 초록 바퀴가 x = 0.95를 지나면 경로가 꺼지고 나머지 주행은 원래 네트워크가 맡습니다.
결과는 별도 테스트 1,024회 모두 성공이었습니다. 바뀐 가중치는 6,073개(3.54%)이고, 대부분 Astra가 경로로 쓰려고 0으로 비운 유닛의 행과 열입니다. 기준 위치값이 이 레벨의 좌표에 맞춰져 있으므로, 이 수정은 네트워크 안에 이 레벨 전용 규칙을 손으로 짜 넣은 것에 가깝습니다.
실험 5: MinAtar 게임 정책을 한 번의 답변으로 쓰기
MinAtar는 Atari 게임을 10x10 격자로 줄인 강화학습 벤치마크입니다. Astra는 Breakout, Seaquest, Asterix 각각에 대해 게임 규칙과 MinAtar 1.0.15의 게임 소스 파일, 입력과 출력 배치, 채점 방식을 받았습니다. 네트워크는 PPO와 같은 600 → 32 → 32 → 6(가중치 20,486개)이고 모든 가중치가 0에서 시작합니다. 데이터, 손실, 기울기, 도구가 없었고, 네트워크는 채점 전에 게임을 한 번도 하지 않았습니다.
| 게임 | PPO, 1억 스텝 | PPO, 5억 스텝 | Astra, 답변 1회 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
점수는 1,000회 에피소드 평균이고, 행동은 출력에서 샘플링하며 에피소드는 최대 10,000스텝에서 끊습니다. PPO 열은 여러 시드(1억 스텝은 Breakout과 Asterix가 시드 10개, Seaquest가 3개, 5억 스텝은 3개) 중 가장 좋은 값입니다. Astra가 쓴 네트워크에서 0이 아닌 가중치는 Breakout 815개, Seaquest 803개, Asterix 637개였습니다. Breakout에서는 첫 층이 공이 떨어질 위치를 계산하고 두 번째 층이 패들을 그 위치로 옮기도록 짰습니다.
실험 6: 가중치 148만 개짜리 9x9 바둑 정책
이번 네트워크(243 → 512 x 6 → 82, 가중치 1,480,274개)는 Astra의 컨텍스트에 직접 넣을 수 없는 크기입니다. Astra는 네트워크 가중치를 읽고 저장할 수 있는 Python 샌드박스(바둑 라이브러리와 인터넷 없음)를 받았고, 샌드박스 안에서는 네트워크를 돌릴 수 없었습니다. 대신 예산 안에서 순전파를 요청할 수 있었습니다. 순전파 1회는 연습 상대(무작위, REINFORCE 네트워크, 시드 1의 PPO 네트워크)와 최대 128판을 두거나, 국면 256개에 대한 출력을 받는 것입니다. 학습, 데이터 맞춤, 탐색(트리 탐색과 롤아웃)은 금지였습니다.
채점은 Astra가 한 번도 상대하지 않은 작은 PPO 네트워크 두 개(시드 0, 2)와 각각 2,000판입니다. 같은 크기(512 x 6) PPO 기준선은 2,050만 판을 학습했고, 학습률을 세 후보 중 연습 상대 기준으로 골랐으며 시드 3개를 뒀습니다. 같은 크기 PPO와의 대국은 예산 0회와 50회에서만 쟀습니다.
| 순전파 예산 | 작은 PPO 시드 0 | 작은 PPO 시드 2 | 같은 크기 PPO 시드 0 / 1 / 2 |
|---|---|---|---|
| 0회 | 54.1% | 54.9% | 42.6% / 26.3% / 36.3% |
| 10회 | 72.9% | 60.0% | 측정 안 함 |
| 25회 | 76.0% | 62.3% | 측정 안 함 |
| 50회 | 84.0% | 80.8% | 74.2% / 70.0% / 78.5% |
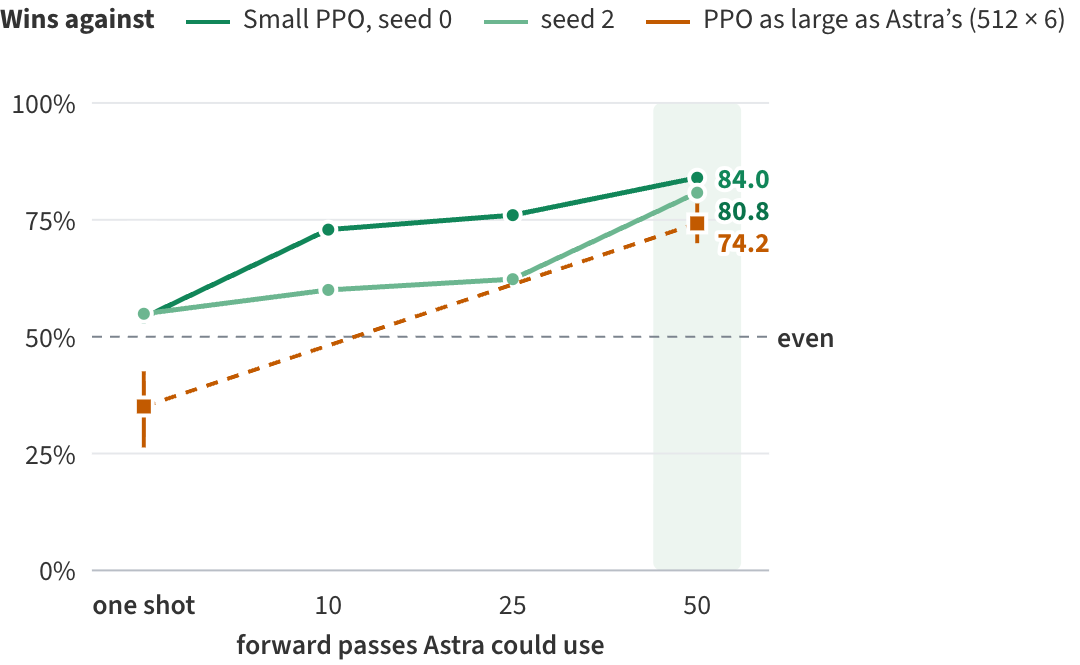
그림의 주황 점선은 0회와 50회 두 측정값을 이은 선이고, 10회와 25회의 같은 크기 PPO 승률은 측정하지 않았습니다.
Astra는 네트워크를 층마다 작은 바둑 프로그램처럼 짰습니다. 첫 층은 양쪽 돌과 그 옆 빈점(활로)을 표시합니다. 중간 층은 이어진 돌을 따라 정보를 몇 칸 전달해 위험한 그룹을 찾고, 마지막 층은 따내기, 자기 그룹 살리기, 단수와 자기 눈 메우기 피하기, 좋은 자리 선호를 수마다 점수로 바꿉니다. 예산 0회에서는 336줄짜리 Python 실행 한 번으로 전부 썼습니다. 예산이 있으면 연습 대국에서 진 판을 보고 그 원인이 된 부분을 고친 뒤 승률이 오를 때만 남겼습니다. 예산마다 실행은 한 번씩입니다.
Qwen3.5-0.8B 수학 실험: 실제로 바뀐 것은 반복 루프
실험 8의 설정
마지막 실험의 대상은 Qwen3.5-0.8B ( Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model)의 텍스트 부분(24층)이고, thinking 모드를 켜고 평가했습니다. Qwen3.5-0.8B는 기본이 non-thinking 모드이며, Qwen 모델 카드는 thinking 모드에서 이 모델이 다른 Qwen3.5 모델보다 생각 루프에 더 잘 빠진다고 경고합니다.
Astra는 GPU 없는 Python 커널, 연습 문제(GSM8K 학습셋 7,469개, MATH 학습셋 7,275개, AIME 714개), 순전파 예산 10, 25, 50회를 받았습니다. 순전파 1회는 연습 문제에 대한 답변을 최대 512개 생성하는 요청이거나, 텍스트 최대 1,024개를 읽혀 로그 확률과 은닉 상태를 받는 요청입니다. 경사하강법과 모든 학습, 커널 안에서 모델을 실행하는 일, 인터넷은 금지였습니다. 최종 정규화 층, 임베딩과 출력층, 텐서 전체에 상수를 곱하는 편집은 저장 함수가 거부했습니다. 평가는 vLLM에서 temperature 0.6, top_p 0.95, top_k 20, presence penalty 1.5, 최대 32,768토큰으로 했고, Astra는 평가셋을 보지 못했습니다.
반복 방향을 지운 편집
처음 연습 답변 96개 중 85개가 32,768토큰 한도에 닿았습니다. Astra는 이 반복을 15층과 19층 MLP가 쓰는 한 방향으로 추적했습니다. 그리고 각 층 down_proj 에서 그 방향을 가장 많이 쓰는 출력 열 64개에서 그 방향을 뺐습니다(2층 x 64열 x 1,024 = 131,072개). 저자들은 모델의 거절 행동을 방향 하나로 지운 Arditi 등의 연구와 비슷한 방식이라고 설명합니다. 같은 계열의 방향 제거 도구로는 Heretic이 있습니다.
예산별 세 실행은 서로 다른 편집을 냈습니다. 10회 실행은 8~22층의 출력 행렬 30개에서 반복 방향 u 를 지우는 랭크 1 편집 W' = W - 1.5\,u(u^\top W) 를, 25회 실행은 15층 7번 어텐션 헤드의 출력 열 256개를 0으로 만드는 편집을, 50회 실행은 위의 MLP 열 편집을 제출했습니다. 50회 실행은 158턴, Python 실행 80회, 대화 4개에 걸쳐 20.3시간이 걸렸습니다(연결이 끊겨 기다린 4.7시간 포함). Astra가 마지막에 스스로 보고한 확인 결과에서는 따로 떼어 둔 연습 문제 1,152개의 정답률이 10.6%에서 60.4%로 올랐습니다(+49.8점, 표준오차 1.5). 또 새로 맞힌 579개 중 576개가 원래 한도에서 잘린 답이었습니다. 원래 끝까지 답한 문제의 정답률은 바뀌지 않았습니다.
벤치마크 결과
아래 표는 원문 표와 그림, 그리고 로그 저장소의 결과표(RESULTS_excerpt.md)를 합친 것입니다. AIME24와 AIME25 행은 원문 블로그에는 없고 결과표에만 있습니다.
| 벤치마크 | 원래 모델 | 순전파 10회 | 25회 | 50회 |
|---|---|---|---|---|
| MATH-500 | 7.9 | 12.3 | 14.1 | 48.1 |
| GSM8K | 13.8 | 25.7 | 25.1 | 67.1 |
| AMC23 | 0.5 | 1.1 | 1.1 | 23.4 |
| Minerva Math | 1.5 | 3.9 | 3.5 | 25.4 |
| OlympiadBench | 1.3 | 2.4 | 3.9 | 21.8 |
| AIME24 | 0.0 | 0.0 | 0.0 | 0.6 |
| AIME25 | 0.0 | 0.0 | 0.0 | 2.3 |
| MMLU-Pro (1,000문항) | 40.3 | 40.0 | 44.7 | 45.5 |
| GPQA Diamond | 22.7 | 29.4 | 30.1 | 36.6 |
| IFEval | 21.0 | 49.0 | 39.9 | 62.3 |
| MATH-500 답 중 토큰 한도 도달 | 93.0 | 87.2 | 86.4 | 33.1 |
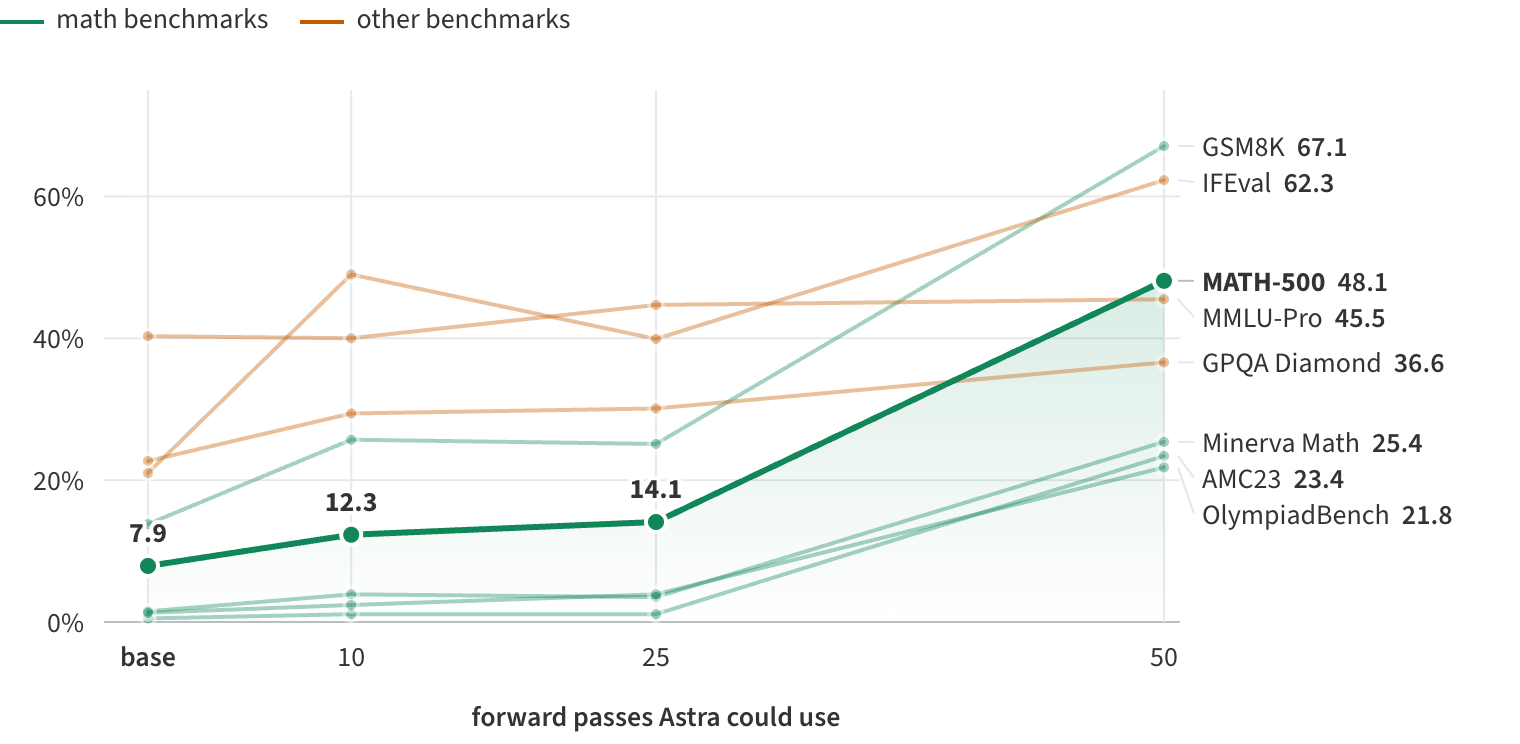
50회 편집 뒤에도 MATH-500 답의 33.1%가 여전히 한도에서 잘렸습니다. 10회와 25회는 루프가 거의 줄지 않았고, IFEval은 10회(49.0)가 25회(39.9)보다 높습니다. 예산마다 실행이 한 번뿐이어서, 이 차이가 예산 때문인지 실행마다의 편차인지는 공개 결과로 가를 수 없습니다.
수치를 읽을 때 확인할 조건
루프 제거와 수학 실력은 다릅니다. 저자들도 이 점을 추가 실험으로 확인했습니다. 답의 8.5%만 토큰 한도에 닿는 Gemma 3 270M에 같은 방식을 적용하자(프롬프트 v5, 모델 카드의 샘플링 설정, 최대 8,192토큰), MATH-500은 6.8%에서 7.0%, 7.6%, 7.7%, 7.0%(예산 5, 10, 25, 50회)로 1점 안팎만 움직였습니다. Astra는 Gemma의 실패에서 계산 실수와 잘못된 대수 전개를 찾았지만, 끌 수 있는 단일 구성 요소는 찾지 못했습니다. 저자들의 결론은 가중치 편집이 능력을 가린 장애물은 치울 수 있어도 모델에 없는 능력을 더하지는 못했다는 것입니다.
프롬프트가 반복을 고칠 대상의 예로 들었습니다. 50회 실행이 받은 첫 메시지(v3)는 if the model often fails because it repeats itself and never finishes, finding and fixing what drives that repetition counts 라고 적었습니다. 작업 순서에서도 토큰 한도에서 잘린 답이 흔히 생각 중 반복이라고 안내합니다. Lucas Beyer는 X 답글에서 이 프롬프트가 루프를 강하게 암시한다고 지적했습니다. 결과표에는 프롬프트 v4의 실행도 있습니다. v4는 더 짧고, 연습 문제를 선택용(DEV)과 확인용(HOLDOUT)으로 나누며, 실패 예시가 없습니다. 이 프롬프트로 10회는 수정을 제출하지 않았고 25회는 MATH-500 14.1%, GSM8K 25.1%였습니다. v4로 50회 실행은 하지 않았고 v4는 힌트 말고도 바뀐 점이 있으므로, 힌트가 없을 때 48.1%에 닿는지는 공개 자료로 알 수 없습니다.
기준 모델 점수는 루프가 잦은 조건에서 잰 값입니다. 7.9%는 thinking 모드, 32,768토큰 한도, temperature 0.6에서 잰 점수입니다. 참고로 Qwen 모델 카드가 보고한 Qwen3.5-0.8B의 IFEval은 thinking 모드 44.0, non-thinking 모드 52.1입니다. Qwen은 언어 벤치마크에 temperature 1.0을 썼고 채점 방식도 같은지 확인할 수 없어 직접 비교할 수는 없지만, 이 실험의 기준값 21.0이 모델 카드 수치의 절반 아래라는 점은 함께 봐야 합니다.
제3자 재평가는 수치를 확인했습니다. Hugging Face의 Ahsen Khaliq는 공개된 편집 diff로 체크포인트를 다시 만들고, 같은 프로토콜로 MATH-500 500문항 x 4샘플을 돌려 51.0%(한도 도달 31.6%)를 얻었습니다. 원래 모델은 25문항 시험에서 5.0%(한도 도달 95%)였습니다.
공개된 체크포인트와 데모로 직접 확인하기
수정된 모델은 RikiyaT/Qwen3.5-0.8B-weight-space-programming에 있습니다. 이 체크포인트는 Ahsen Khaliq가 ML Intern ( ML Intern: Hugging Face가 공개한, 논문을 읽고 모델을 학습하며 코드를 배포하는 오픈소스 ML 엔지니어 에이전트)으로 Hugging Face Jobs에서 다시 만든 것입니다. 로그 저장소의 exp8_math/code/apply_edit.py 가 원본 Qwen/Qwen3.5-0.8B (리비전 2fc06364)에 편집을 적용하고 텐서마다 sha256을 원문 평가본과 대조합니다. 원본과 다른 텐서는 layers.15.mlp.down_proj.weight 와 layers.19.mlp.down_proj.weight 두 개뿐입니다. 원문은 텍스트 전용으로 내보낸 모델을 평가했고 이 체크포인트는 멀티모달 전체 릴리스지만, 언어 모델 텐서는 같습니다. 데모가 불러오는 ML-Intern-lab/Qwen3.5-0.8B-weight-space-programming 저장소의 가중치 파일도 해시가 같습니다.
모델 카드의 사용 예는 평가와 같은 샘플링 설정으로 vLLM에서 실행합니다.
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer

ckpt = "RikiyaT/Qwen3.5-0.8B-weight-space-programming"
tok = AutoTokenizer.from_pretrained(ckpt)
llm = LLM(model=ckpt, dtype="bfloat16", max_model_len=34816)

prompt = tok.apply_chat_template(
    [{"role": "user", "content": "What is $2^{10} + 24$?\nPlease reason step by step, and put your final answer within \\boxed{}."}],
    tokenize=False, add_generation_prompt=True, enable_thinking=True)
sp = SamplingParams(n=1, temperature=0.6, top_p=0.95, top_k=20, presence_penalty=1.5,
                    max_tokens=32768, seed=0)
print(llm.generate([prompt], sp)[0].outputs[0].text)
Hugging Face Space 데모는 원래 모델과 수정 모델을 같은 문제에 나란히 실행하는 Gradio 앱입니다. 데모 속도 때문에 실시간 탭은 최대 생성 토큰이 기본 4,096(1,024~8,192 조절)이고, 소스(app.py)를 보면 presence penalty를 넘기지 않습니다. 따라서 실시간 탭의 결과는 평가 프로토콜과 다르고, 평가와 같은 조건(32,768토큰)의 생성 결과는 "Recorded verification runs" 탭에서 봐야 합니다.
이 실험은 영어 수학 문제와 영어 벤치마크만 썼습니다. 편집은 15층과 19층 MLP의 출력을 모든 입력에서 바꾸지만, 한국어를 포함한 다른 언어에서 어떤 영향이 있는지는 측정하지 않았습니다.
가중치를 만드는 기존 방법과 Weight-Space Programming 비교
원문의 관련 연구 절을 바탕으로, 가중치를 누가 어떻게 만드는지 기준으로 정리하면 다음과 같습니다.
| 접근 | 가중치를 만들거나 읽는 주체 | 그 일을 위한 학습 | 예 |
|---|---|---|---|
| 경사하강법 학습 | Adam, Muon 같은 옵티마이저 | 데이터와 손실 필요 | 일반적인 모델 학습 |
| 가중치 생성 네트워크 | 가중치 생성용으로 학습한 네트워크 | 생성기 학습 필요 | Fast Weight Programmers, p-diff, NeuroGen |
| 컴파일 | 형식 프로그램과 컴파일러 | 없음 | Tracr, Qwenputer |
| 가중치와 활성값 해석 | 해석용으로 학습한 모델 또는 전용 도구 | 경우에 따라 필요 | Weight Oracles, Circuit Tracer, neuron explorer |
| Weight-Space Programming | 범용 LLM의 추론 | 없음 | 이 글의 실험 8개 |
작은 규모에서는 코딩 에이전트가 작은 트랜스포머의 가중치를 손으로 정하는 AdderBoard 같은 시도가 있었습니다. 저자들이 내세우는 차이는 이 일을 위해 따로 학습하지 않은 범용 모델이, 텍스트로 받은 가중치 17만 개 규모부터 도구를 쓴 8억 개 규모까지 직접 읽고 썼다는 점입니다.
발표 뒤 반응도 이 위치 설정을 두고 갈렸습니다. Jürgen Schmidhuber는 답글에서 1990년대 fast weight programmers가 이미 한 일이라고 적었습니다. 원문은 그 계열 논문을 가중치를 쓰도록 학습한 네트워크 의 예로 인용하므로, 두 입장은 "학습한 쓰기 네트워크인가, 범용 LLM인가"에서 갈립니다. will depue는 답글에서 결과를 더 맥락 속에 놓아 달라고 했습니다. 연구진은 2026년 11월 3일 블로그 요약(TL;DR, Too Long; Didn't Read)의 well past what we'd expect from humans or conventional algorithms 를 using a variety of recent tools and algorithms or even via direct weight editing 으로 바꿨습니다. 그리고 사람이나 기존 알고리즘에 기대하는 수준을 넘어선다는 단정을 넘어설 수도 있다(may extend beyond) 는 가능성 표현으로 낮췄습니다(사이트 저장소 커밋).
저자들이 제시한 다음 단계와 남은 질문
저자들은 Weight-Space Programming이 다음 일을 가능하게 할 수 있다고 봅니다.
- 평가 없는 감사: 테스트셋 없이 가중치에서 백도어 같은 숨은 문제를 찾는 일
- 최적화 비용 절감: 데이터셋 구축과 전체 학습 대신 한 번에 가중치를 초기화하는 일
- 데이터 없는 능력 조정과 언러닝(Unlearning): 일부 가중치만 고쳐 능력을 더하거나 지우는 일. 저자들은 0.016%만 바꾸므로 미세조정보다 망각이 적을 것이라고 봅니다.
- 재귀적 자기 개선: 모델이 자신이나 더 새로운 모델의 가중치를 점검하고 고치는 일
- 구조가 다른 모델 사이의 회로 이식: 가중치 평균 대신 추론 모듈 같은 회로를 다른 구조의 모델로 옮기는 일
연구진은 이 능력을 재는 벤치마크를 만들고 있다고 밝혔습니다. LLM이 가중치를 탐색하고 쓰도록 돕는 실행 환경인 하네스(Harness)도 함께 만들고 있습니다. 다만 공개된 실험은 모두 Astra 한 모델로 했고, 순전파 예산을 둔 실험 6과 8은 예산마다 한 번씩 실행했습니다. 망각이 적다는 주장도 위 벤치마크 10종 밖의 능력에서는 측정하지 않았습니다. 가장 큰 결과인 실험 8은 프롬프트가 예로 든 반복 루프를 찾아 지운 사례이므로, 수학 능력을 새로 만든 사례로 읽지 않아야 합니다.
라이선스
lm_understand-logs 저장소의 로그, 데이터, 네트워크는 CC BY 4.0으로, 연구진의 스크립트는 MIT 라이선스로 배포됩니다. 출처를 표시하면 상업적 용도를 포함해 자유롭게 이용할 수 있습니다. 실험 5 프롬프트에 들어 있는 MinAtar 소스 코드는 GPL-3.0이고, 실험 8의 벤치마크 데이터는 각자의 라이선스를 따릅니다. 수정된 Qwen3.5-0.8B 체크포인트는 원본과 같은 Apache 2.0입니다.
 Sparks of Weight-Space Programming 소개 블로그
 lm_understand-logs GitHub 저장소 (전체 실험 로그)
 Qwen3.5-0.8B-weight-space-programming (Hugging Face)
 Weight-Space Programming 데모 (Hugging Face Space)
 저자의 Weight-Space Programming 공개 X 스레드
https://x.com/rikiyatakehi/status/2117313742891327994
더 읽어보기
-
OpenAI가 공개한 GPT-6 Astra 공식 활용 가이드: 자주 되묻는 모델을 끝까지 일하게 하는 프롬프팅과 마이그레이션
-
Qwenputer, Gated DeltaNet 상태를 RAM으로 취급하여 가중치에 RISC-V CPU를 넣은 실험적 모델
-
사고 패치(Thought Patching): 프롬프트를 가중치로 바꾸는 모델 편집에 대한 연구 (feat. Google)
-
Heretic: LLM의 검열을 자동으로 제거하는 도구 (Heretic: Fully automatic censorship removal for language models)
-
ML Intern: Hugging Face가 공개한, 논문을 읽고 모델을 학습하며 코드를 배포하는 오픈소스 ML 엔지니어 에이전트
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
